
Um algoritmo evolutivo multiobjetivo (MOEA) implementado em MATLAB pode ser entregue diretamente a um grande modelo de linguagem e reescrito automaticamente como um programa acelerado por GPU? À primeira vista, isso parece significar trocar MATLAB por PyTorch, arrays por tensores e laços por operações em lote. A verdadeira dificuldade, porém, está na semântica do algoritmo: quais cálculos podem rodar em paralelo, quais dependem de uma ordem que precisa ser preservada, quais variáveis são temporárias e quais carregam estado entre gerações. Se essas distinções estiverem erradas, o código convertido pode funcionar e, ainda assim, implementar um algoritmo diferente.
A equipe EvoX propõe a EvoCoCo (Evolutionary Code Conversion), uma arquitetura multiagente para tensorização automática guiada pela semântica. Primeiro ela entende o algoritmo de origem, depois explora diferentes implementações tensorizadas e, por fim, usa o feedback de execução para validar, reparar e selecionar candidatos. A EvoCoCo foi avaliada em 48 MOEAs em três dimensões: confiabilidade da migração, fidelidade de otimização e escalabilidade computacional. A cobertura global de fidelidade de otimização atingiu 88.2%. As acelerações medianas foram de 22.6× ao escalar o tamanho da população e de 80.2× ao escalar a dimensionalidade das variáveis de decisão. Em escala maior, o algoritmo representativo MOEA/D-DE alcançou uma aceleração de 37,339×.
O que é realmente difícil de levar para a GPU não é a sintaxe
Os MOEAs oferecem um paralelismo substancial em nível de população. A avaliação dos objetivos, a mutação, a ordenação, a seleção ambiental e as operações de arquivo costumam processar lotes de soluções candidatas ou relações dentro de uma população, o que os torna bem adequados a uma execução paralela por meio de computação tensorial em GPU.
O paralelismo de um algoritmo não significa que sua implementação existente esteja pronta para execução em GPU. No PlatEMO, por exemplo, o código MATLAB combina operações vetorizadas com laços em nível de indivíduo, contêineres dinâmicos, ramificações condicionais, extração iterativa de frentes não dominadas, fatiamento de objetos e várias funções auxiliares. Levar esse código para uma GPU exige reorganizar as representações de dados, o fluxo de controle e as atualizações de estado. Isso vai muito além da simples troca de sintaxe.
O desafio é identificar quais estruturas definem o algoritmo original:
- Quais variáveis representam estado do algoritmo que persiste entre gerações?
- Quais cálculos podem ser reescritos usando broadcasting, máscaras ou indexação em lote?
- Quais laços contêm dependências sequenciais de fato e precisam ser preservados?
- Quais mudanças de estado e de relações de atualização alterariam o mecanismo de otimização?
É exatamente a essas perguntas que a EvoCoCo responde. A conversão pode mudar os layouts de dados, o fluxo de controle e as estratégias de execução, preservando os operadores centrais, o estado persistente, as dependências e a lógica de atualização do algoritmo. Isso estabelece a fronteira entre o que a tensorização automática pode reestruturar e o que ela deve preservar.
A tensorização automática exige mais do que uma única geração de código
A EvoCoCo divide a conversão de código em três etapas: compreensão, tensorização e validação com seleção. Nenhum agente único cuida da conversão do começo ao fim. O algoritmo de origem é analisado uma única vez para produzir uma representação semântica compartilhada. Os candidatos tensorizados seguintes são gerados a partir dessa mesma representação e do mesmo plano. Assim, a compreensão do algoritmo fica separada da geração de implementações.
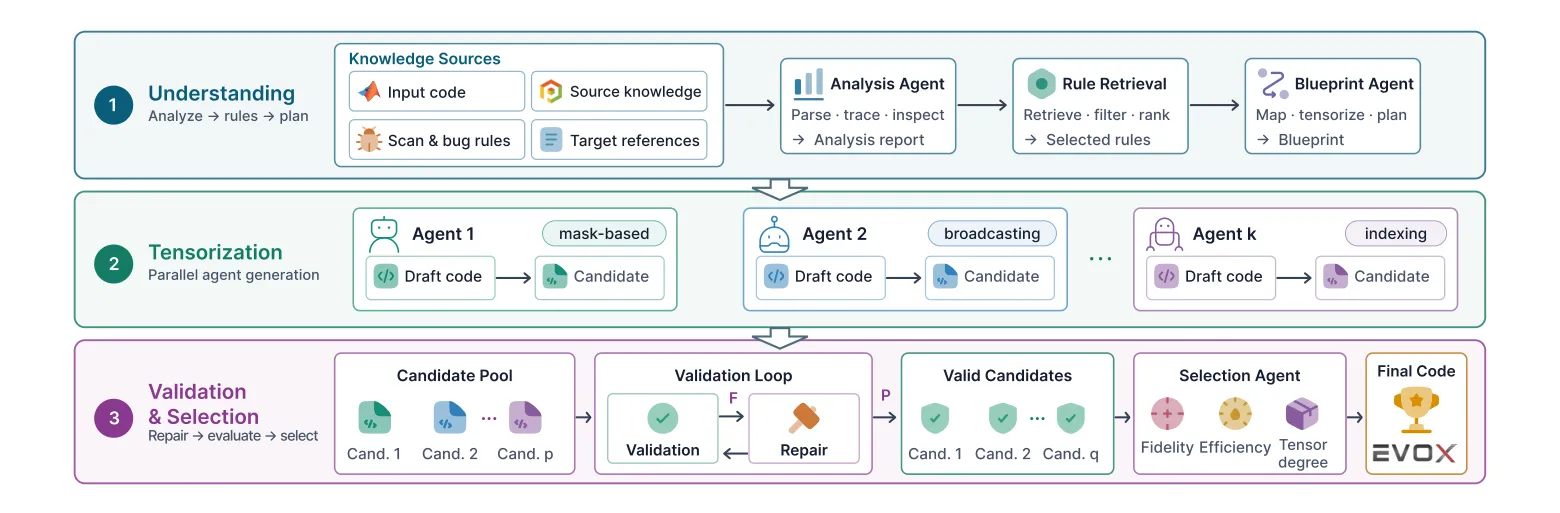
Figura 1. Arquitetura multiagente da EvoCoCo. O Source Analysis Agent reconstrói a semântica do algoritmo, o Rule Retriever recupera as regras de migração e o Blueprint Agent cria um plano de tensorização. Vários Tensorization Agents geram candidatos em paralelo sob restrições compartilhadas. O feedback de execução orienta o reparo, e o Selection Agent faz a seleção final.
Etapa 1: compreensão. O Source Analysis Agent reconstrói a semântica do algoritmo de origem, identificando seus operadores centrais, o estado persistente, as dependências e a lógica de atualização. O Rule Retriever recupera as regras de migração relevantes com base na estrutura do algoritmo. O Blueprint Agent então cria um plano de tensorização compartilhado que especifica como o estado é mapeado, como o cálculo é reestruturado e quais restrições a plataforma-alvo deve satisfazer.
Etapa 2: tensorização. Sob o mesmo plano, k Tensorization Agents geram candidatos em paralelo, com ênfases diferentes em broadcasting, otimização com einsum, operações mascaradas, atualizações in-place, operadores tensoriais avançados e tensorização da seleção iterativa. Eles exploram diferentes implementações computacionais do mesmo algoritmo, usando a compreensão compartilhada do código-fonte, em vez de reinterpretar cada um o código-fonte de forma independente.
Etapa 3: validação e seleção. Os programas candidatos passam por verificações estáticas e validação em execução. Problemas de interface, forma de tensores, dispositivo, numéricos ou de fluxo de controle expostos durante a execução são enviados ao Repair Agent para reparo adicional. Entre os candidatos que passam na validação, o Selection Agent escolhe a implementação final considerando os resultados de otimização, o tempo de execução e o grau de tensorização.
A ideia-chave é compartilhar a compreensão do algoritmo de origem e, ao mesmo tempo, permitir implementações diversas em GPU.
O feedback de execução faz o processo de conversão convergir
A tradução em uma única passada comprime a compreensão semântica, a adaptação à plataforma e o desenho da tensorização em um único passo de geração. Um erro em qualquer uma dessas frentes pode só aparecer quando o programa realmente roda, sem mecanismo para diagnóstico e reparo posteriores.
A EvoCoCo inclui a execução no processo de conversão. Os programas candidatos rodam no ambiente-alvo; problemas de interfaces, formas de tensores, comportamento numérico e atualizações de estado tornam-se feedback concreto para reparar os candidatos. Os múltiplos ramos de tensorização também oferecem caminhos alternativos de implementação. A geração de código vira um ciclo fechado de geração, execução, reparo e seleção.
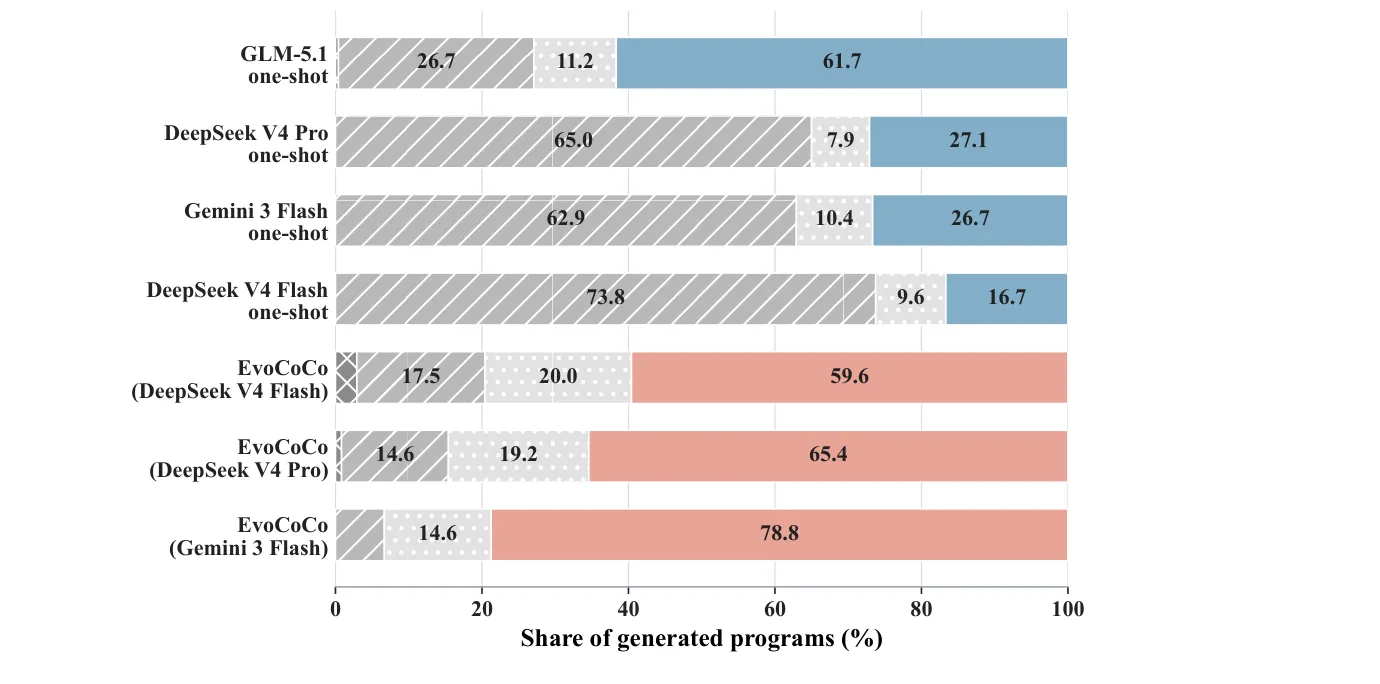
Figura 2. Resultados por etapa ao longo de 240 tentativas de conversão independentes por condição. Nas três comparações com o mesmo modelo, as falhas de execução representaram 62.9%–73.8% das tentativas de tradução em uma única passada, contra 6.7%–17.5% da EvoCoCo. Mais candidatos puderam avançar para a avaliação de otimização.
Essa mudança no ponto onde ocorrem as falhas mostra que o ciclo de feedback faz mais do que corrigir bugs: deixa o ambiente-alvo ajudar a determinar quais implementações tensorizadas são realmente utilizáveis. Muitas traduções em uma única passada param na etapa de execução. A EvoCoCo obtém informações de diagnóstico por meio da execução real e, então, repara e filtra candidatos para que mais implementações possam avançar para a avaliação do seu comportamento de otimização.
Rodar com sucesso é só o primeiro passo da migração
Os experimentos da EvoCoCo respondem a três perguntas: se a conversão automática pode ser concluída de forma confiável, se os algoritmos convertidos mantêm um desempenho de otimização aceitável e se a tensorização consegue liberar o paralelismo das GPUs. A avaliação abrange confiabilidade da migração, fidelidade de otimização e escalabilidade computacional.
1. Confiabilidade da migração
Nas comparações com o mesmo modelo, cada condição incluiu 240 tentativas de conversão independentes. A EvoCoCo com Gemini 3 Flash alcançou uma taxa de aprovação de execução de 93.33% e uma taxa de aprovação de convergência de 78.75%. Para cada um dos 48 algoritmos de benchmark, a EvoCoCo produziu pelo menos uma implementação que passou na validação de convergência. A taxa de aprovação de convergência foi 52.08 pontos percentuais maior que a da tradução em uma única passada com o mesmo modelo, e 17.08 pontos percentuais maior que a do GLM-5.1, a melhor condição entre todas as traduções em uma única passada.
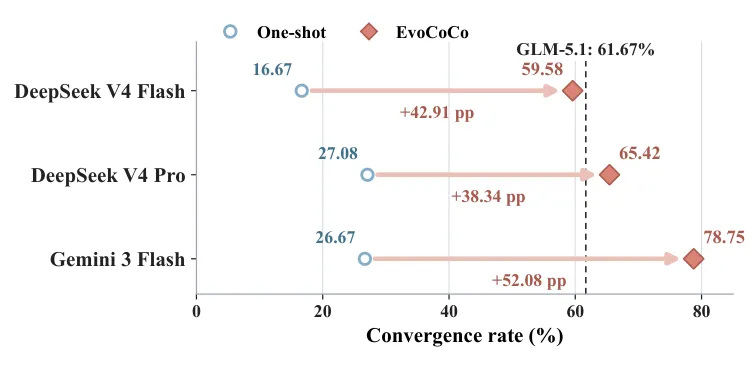
Figura 3. A EvoCoCo melhorou a taxa de aprovação de convergência em relação à tradução em uma única passada nas três comparações com o mesmo modelo. A linha tracejada representa o GLM-5.1, a referência mais forte de tradução em uma única passada.
2. Fidelidade de otimização
Algoritmos evolutivos são estocásticos, de modo que a comparação elemento a elemento da saída de uma única execução não pode estabelecer se a conversão preserva o comportamento de otimização. A avaliação usou execuções repetidas e independentes para comparar os valores finais de distância geracional invertida (IGD) das implementações PlatEMO e EvoX em configurações idênticas do problema. As suítes DTLZ, WFG, LSMOP e MaF forneceram 1,904 comparações válidas, das quais 1,680 cumpriram o critério de fidelidade predefinido, resultando em uma cobertura global de 88.2%. A cobertura ultrapassou 80% nas quatro suítes, atingindo 96.5% na WFG. Dos 48 algoritmos, 41 alcançaram uma cobertura em nível de algoritmo de pelo menos 80%.
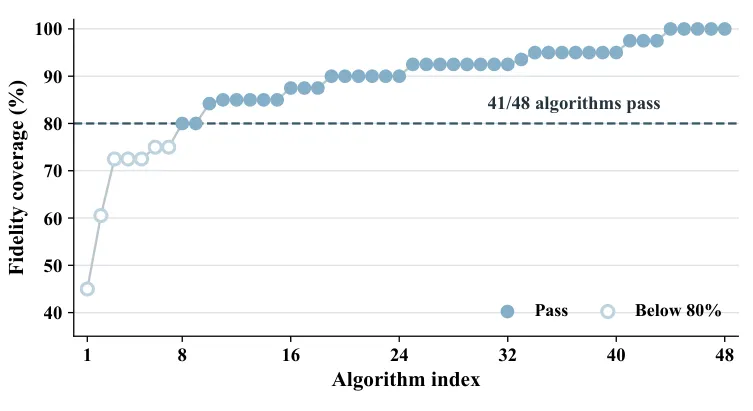
Figura 4. Cobertura de fidelidade de otimização para 48 algoritmos tensorizados. No total, 41 algoritmos atingiram o limiar de 80%.
3. Escalabilidade computacional
Em todas as comparações CPU–GPU válidas, a aceleração mediana foi de 22.6× ao escalar o tamanho da população e de 80.2× ao escalar a dimensionalidade das variáveis de decisão. À medida que o tamanho dos problemas crescia ainda mais, as implementações em GPU ganharam, em geral, uma vantagem de execução ainda maior.
| Eixo de escalonamento | Comparações válidas | Aceleração mediana | Média geométrica | Amplitude interquartil |
|---|---|---|---|---|
| Tamanho da população | 289 | 22.6× | 29.9× | 4.5–163.5× |
| Dimensionalidade das variáveis de decisão | 276 | 80.2× | 71.5× | 8.4–404.9× |
As acelerações variam bastante entre os algoritmos, mas a tendência global é clara: à medida que o tamanho da população ou a dimensionalidade das variáveis de decisão aumentam, a tensorização guiada pela semântica libera progressivamente o paralelismo em nível de população que permanecia oculto nas estruturas de programas para CPU. As curvas de tempo de execução de algoritmos representativos ilustram ainda mais essa vantagem de escalabilidade.
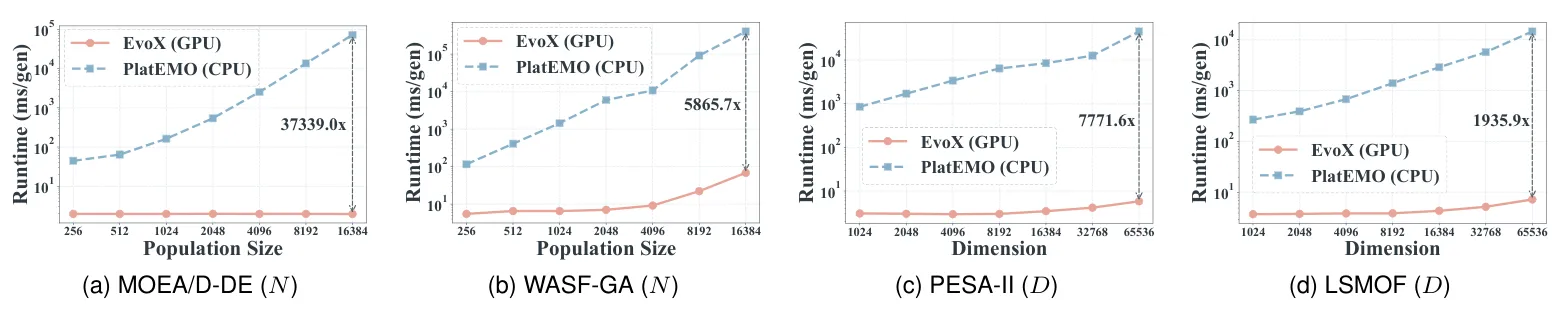
Figura 5. Os painéis (a) e (b) mostram o escalonamento do tamanho da população; os painéis (c) e (d), o da dimensionalidade das variáveis de decisão. As anotações indicam as acelerações nas maiores escalas testadas. O MOEA/D-DE atingiu 37,339× com N = 16,384.
Além das três avaliações centrais, ablações de componentes e a conversão a partir de fontes externas testaram ainda mais os mecanismos-chave da EvoCoCo. Em um subconjunto de diagnóstico de 12 algoritmos, a arquitetura EvoCoCo completa alcançou taxas de aprovação de execução e de convergência de 98.3% e 83.3%, respectivamente. Remover o Repair Agent reduziu essas taxas para 60.0% e 41.7%; usar um único ramo de geração as levou a 68.3% e 40.0%. Esses resultados mostram que o feedback de execução e a geração multiramo são especialmente importantes para a confiabilidade da migração. Em 10 implementações externas e legadas de MATLAB/Octave fora do PlatEMO, a EvoCoCo alcançou uma taxa de aprovação de execução de 96% e de convergência de 62%. Nove algoritmos obtiveram pelo menos uma implementação que passou na validação de convergência. Os resultados correspondentes da tradução em uma única passada foram 34%, 18% e 2 algoritmos. Isso indica que o processo em etapas de tensorização automática consegue acomodar diferentes fontes e estilos de código, ao passo que a eficácia de otimização continua sendo a prova mais difícil.
O código pode mudar; o algoritmo não
Passar de MATLAB para PyTorch e de CPU para GPU muda a linguagem, as estruturas de dados e a estratégia de execução. Os mecanismos centrais do algoritmo devem permanecer intactos.
A EvoCoCo também é significativa pela forma como reformula a conversão de código. Ela desloca o foco de reproduzir instruções para identificar o que precisa ser preservado. Quando a plataforma de computação muda, uma conversão bem-sucedida não precisa reproduzir a estrutura do programa original: deve permitir que o cálculo seja reorganizado, desde que as relações que definem o algoritmo continuem valendo.
Uma linguagem de programação é uma maneira de expressar um algoritmo, e o hardware é uma maneira de executar um cálculo. O que precisa sobreviver à migração entre linguagens e hardware é a estrutura por trás desse cálculo.
Código aberto e recursos da comunidade
Artigo: https://arxiv.org/abs/2609.02387
GitHub: https://github.com/EMI-Group/evococo
Projeto upstream (EvoX): https://github.com/EMI-Group/evox
Grupo QQ: 297969717
Grupo QQ | Evolutionary Machine Intelligence