
Может ли многокритериальный эволюционный алгоритм (MOEA), реализованный на MATLAB, быть просто передан большой языковой модели и автоматически переписан в программу с ускорением на GPU? На первый взгляд это означает заменить MATLAB на PyTorch, массивы на тензоры, а циклы на пакетные операции. Настоящая трудность, однако, заключается в семантике алгоритма: какие вычисления могут выполняться параллельно, какие зависят от порядка, который необходимо сохранить, какие переменные временны, а какие переносят состояние между поколениями. Если эти различения неверны, преобразованный код может работать, реализуя при этом другой алгоритм.
Команда EvoX предлагает EvoCoCo (Evolutionary Code Conversion) — многоагентный каркас автоматической тенсоризации, управляемой семантикой. Сначала он понимает исходный алгоритм, затем исследует различные тенсоризованные реализации и, наконец, использует обратную связь по выполнению для валидации, исправления и отбора кандидатов. EvoCoCo был оценён на 48 MOEA по трём измерениям: надёжность переноса, точность оптимизации и вычислительная масштабируемость. Общая полнота соответствия оптимизации достигла 88.2%. Медианные ускорения составили 22.6× при масштабировании размера популяции и 80.2× при масштабировании размерности переменных принятия решений. В более крупном масштабе репрезентативный алгоритм MOEA/D-DE достиг ускорения 37,339×.
Что действительно трудно перенести на GPU — это не синтаксис
MOEA обладают значительным параллелизмом на уровне популяции. Оценивание целевых функций, мутация, сортировка, экологический отбор и операции с архивом часто обрабатывают целые пакеты решений-кандидатов или отношений внутри популяции, что делает их хорошо подходящими для параллельного выполнения посредством тензорных вычислений на GPU.
Параллелизм алгоритма не означает, что его существующая реализация готова к выполнению на GPU. В PlatEMO, например, код MATLAB сочетает векторизованные операции с циклами на уровне особей, динамическими контейнерами, условными ветвлениями, итеративным извлечением недоминируемых фронтов, срезами объектов и множеством вспомогательных функций. Перенос такого кода на GPU требует реорганизации представления данных, потока управления и обновления состояния. Это выходит далеко за рамки простой замены синтаксиса.
Задача — определить, какие структуры определяют исходный алгоритм:
- Какие переменные представляют состояние алгоритма, сохраняющееся между поколениями?
- Какие вычисления можно переписать с использованием широковещания, масок или пакетной индексации?
- Какие циклы содержат настоящие последовательные зависимости и должны быть сохранены?
- Какие изменения состояния и отношений обновления изменили бы сам механизм оптимизации?
Именно эти вопросы решает EvoCoCo. Преобразование может менять размещения данных, поток управления и стратегии выполнения, сохраняя при этом ключевые операторы, постоянное состояние, зависимости и логику обновления алгоритма. Это устанавливает границу между тем, что автоматическая тенсоризация может перестраивать, и тем, что она обязана сохранить.
Автоматическая тенсоризация — это не одноразовая генерация кода
EvoCoCo делит преобразование кода на три этапа: понимание, тенсоризация, валидация и отбор. Ни один агент не ведёт преобразование от начала до конца. Исходный алгоритм анализируется один раз, порождая общее семантическое представление. Последующие кандидаты на тенсоризацию генерируются из этого же представления и проектного плана. Так понимание алгоритма отделяется от генерации реализаций.
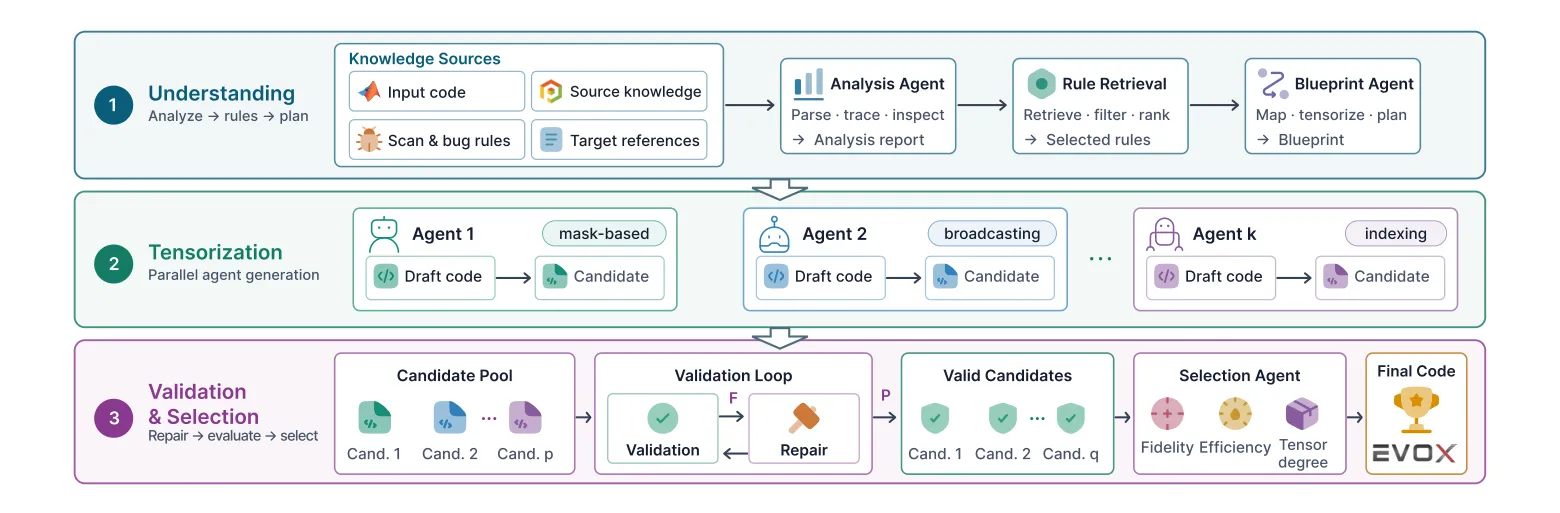
Рисунок 1. Многоагентная архитектура EvoCoCo. Source Analysis Agent восстанавливает семантику алгоритма, Rule Retriever извлекает правила переноса, а Blueprint Agent создаёт проектный план тенсоризации. Несколько Tensorization Agent параллельно генерируют кандидатов при общих ограничениях. Обратная связь по выполнению управляет исправлением, а Selection Agent осуществляет итоговый отбор.
Шаг 1: понимание. Source Analysis Agent восстанавливает семантику исходного алгоритма, выявляя его ключевые операторы, постоянное состояние, зависимости и логику обновления. Rule Retriever извлекает релевантные правила переноса на основе структуры алгоритма. Затем Blueprint Agent создаёт общий проектный план тенсоризации, задающий, как отображается состояние, как перестраивается вычисление и какие ограничения должна удовлетворять целевая платформа.
Шаг 2: тенсоризация. При одном и том же проектном плане k Tensorization Agent параллельно генерируют кандидатов с разными акцентами: широковещание, оптимизация через einsum, операции с масками, обновления на месте, продвинутые тензорные операторы и тенсоризация итеративного отбора. Они исследуют различные вычислительные реализации одного и того же алгоритма, опираясь на общее понимание исходного кода, а не переинтерпретируют его каждый по-своему.
Шаг 3: валидация и отбор. Программы-кандидаты проходят статические проверки и проверку при выполнении. Проблемы с интерфейсами, формами тензоров, устройством, численным поведением или потоком управления, выявленные при выполнении, передаются Repair Agent для дальнейшего исправления. Среди кандидатов, прошедших валидацию, Selection Agent выбирает итоговую реализацию с учётом результатов оптимизации, времени выполнения и степени тенсоризации.
Ключевая идея — разделить понимание исходного алгоритма, допустив при этом разнообразие реализаций на GPU.
Обратная связь по выполнению делает процесс преобразования сходящимся
Одноразовый перевод сжимает семантическое понимание, адаптацию к платформе и проектирование тенсоризации в один шаг генерации. Ошибка в любой из этих областей может проявиться лишь тогда, когда программа реально запущена, без механизма дальнейшей диагностики и исправления.
EvoCoCo включает само выполнение в процесс преобразования. Программы-кандидаты запускаются в целевой среде; проблемы с интерфейсами, формами тензоров, численным поведением и обновлением состояния становятся конкретной обратной связью для исправления кандидатов. Несколько ветвей тенсоризации также дают альтернативные пути реализации. Генерация кода превращается в замкнутый цикл: генерация — выполнение — исправление — отбор.
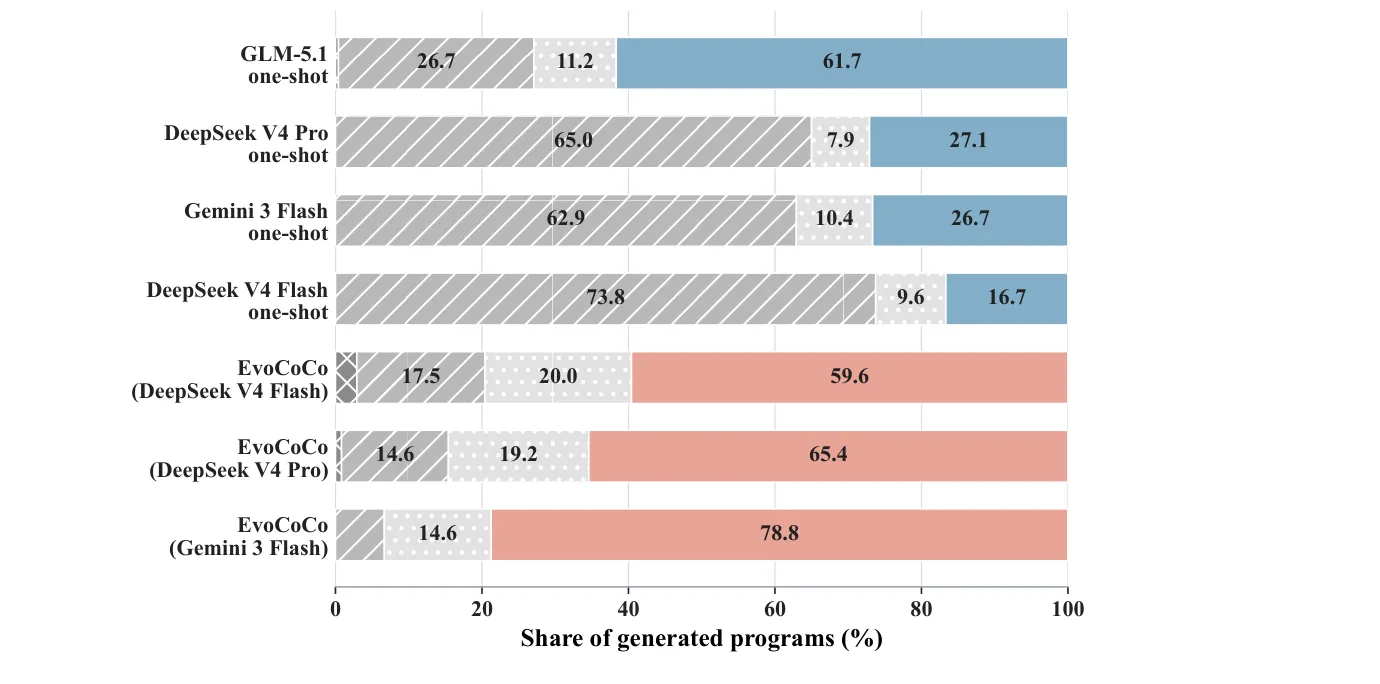
Рисунок 2. Результаты по этапам для 240 независимых попыток преобразования в каждом условии. В трёх сравнениях с одинаковой моделью доля сбоев выполнения составила 62.9%–73.8% попыток одноразового перевода против 6.7%–17.5% у EvoCoCo. Больше кандидатов смогло перейти к оценке оптимизации.
Это смещение места отказов показывает, что петля обратной связи не просто исправляет ошибки: она позволяет целевой среде участвовать в определении того, какие тенсоризованные реализации действительно применимы. Многие одноразовые переводы останавливаются на этапе выполнения. EvoCoCo получает диагностическую информацию из реального выполнения, затем исправляет и отбирает кандидатов, чтобы больше реализаций могло пройти к оценке их оптимизационного поведения.
Успешное выполнение — лишь первый рубеж переноса
Эксперименты EvoCoCo отвечают на три вопроса: можно ли надёжно завершить автоматическое преобразование, сохраняют ли преобразованные алгоритмы приемлемое качество оптимизации и способна ли тенсоризация высвободить параллелизм GPU. Оценка охватывает надёжность переноса, точность оптимизации и вычислительную масштабируемость.
1. Надёжность переноса
В сравнениях с одинаковыми модельными бэкендами каждое условие включало 240 независимых попыток преобразования. EvoCoCo с Gemini 3 Flash достиг доли успешного выполнения 93.33% и доли прохождения сходимости 78.75%. Для каждого из 48 эталонных алгоритмов EvoCoCo получил хотя бы одну реализацию, прошедшую валидацию сходимости. Доля прохождения сходимости была на 52.08 процентных пункта выше, чем у одноразового перевода с тем же бэкендом, и на 17.08 процентных пункта выше, чем у GLM-5.1 — лучшего условия среди всех одноразовых переводов.
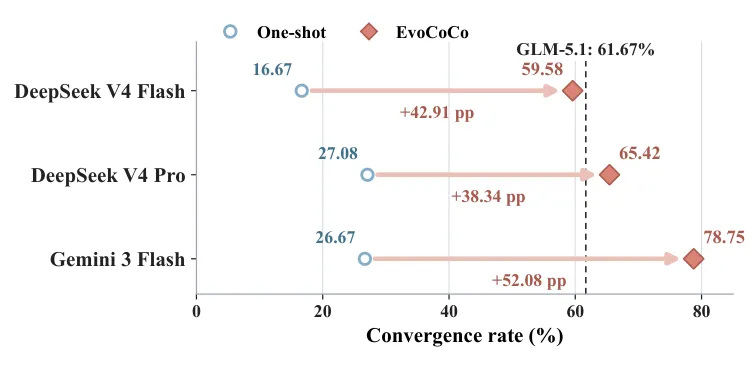
Рисунок 3. Во всех трёх сравнениях с одинаковыми бэкендами EvoCoCo превзошёл одноразовый перевод по доле прохождения сходимости. Пунктирная линия — GLM-5.1, сильнейший базовый вариант одноразового перевода.
2. Точность оптимизации
Эволюционные алгоритмы стохастичны, поэтому поэлементное сравнение результатов одного запуска не может установить, сохраняет ли преобразование оптимизационное поведение. Оценка использовала независимые повторные запуски, сравнивая итоговые значения обратной генерационной дистанции (IGD) реализаций PlatEMO и EvoX при одинаковых настройках задач. Наборы DTLZ, WFG, LSMOP и MaF дали 1,904 корректных сравнения, из которых 1,680 удовлетворили заранее заданному критерию точности — общая полнота составила 88.2%. Во всех четырёх наборах полнота превысила 80%, достигнув 96.5% на WFG. Из 48 алгоритмов 41 достигли полноты не менее 80% на уровне алгоритма.
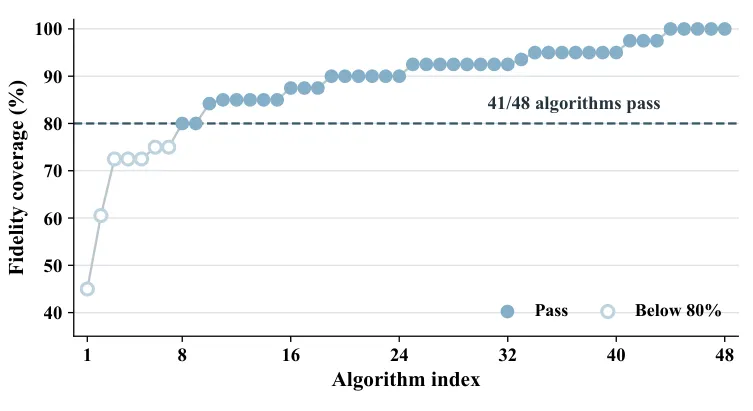
Рисунок 4. Полнота соответствия оптимизации для 48 тенсоризованных алгоритмов. Всего 41 алгоритм достиг порога 80%.
3. Вычислительная масштабируемость
По всем корректным сравнениям CPU–GPU медианное ускорение составило 22.6× при масштабировании размера популяции и 80.2× при масштабировании размерности переменных принятия решений. При дальнейшем росте размера задач реализации на GPU в целом получали всё большее преимущество по времени выполнения.
| Ось масштабирования | Корректных сравнений | Медианное ускорение | Среднее геометрическое | Межквартильный размах |
|---|---|---|---|---|
| Размер популяции | 289 | 22.6× | 29.9× | 4.5–163.5× |
| Размерность переменных принятия решений | 276 | 80.2× | 71.5× | 8.4–404.9× |
Ускорения сильно различаются по алгоритмам, но общая тенденция ясна: с ростом размера популяции или размерности переменных управляемая семантикой тенсоризация постепенно высвобождает скрытый в структурах CPU-программ параллелизм на уровне популяции. Кривые времени выполнения репрезентативных алгоритмов дополнительно иллюстрируют это преимущество масштабирования.
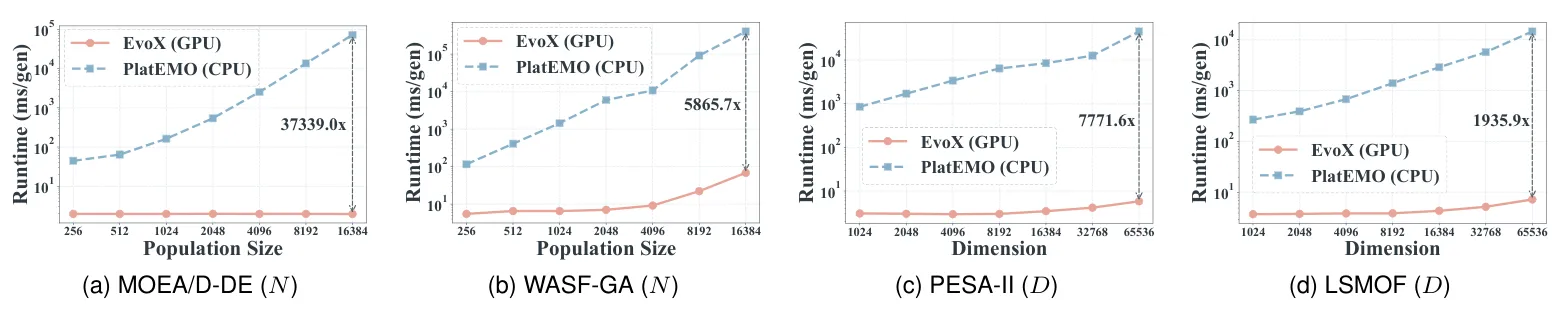
Рисунок 5. Панели (a) и (b) — масштабирование размера популяции; панели (c) и (d) — размерности переменных. Аннотации указывают ускорения на крупнейших протестированных масштабах. MOEA/D-DE достиг 37,339× при N = 16,384.
Помимо трёх ключевых оценок, абляции компонентов и перенос из внешних источников дополнительно проверили ключевые механизмы EvoCoCo. На диагностическом подмножестве из 12 алгоритмов полный каркас EvoCoCo достиг долей успешного выполнения и прохождения сходимости 98.3% и 83.3% соответственно. Без Repair Agent эти доли снизились до 60.0% и 41.7%; при одной ветви генерации — до 68.3% и 40.0%. Эти результаты показывают, что обратная связь по выполнению и многоветвенная генерация особенно важны для надёжности переноса. На 10 внешних и унаследованных реализациях MATLAB/Octave вне PlatEMO EvoCoCo достиг доли успешного выполнения 96% и доли сходимости 62%; девять алгоритмов получили хотя бы одну реализацию, прошедшую валидацию сходимости. Соответствующие результаты одноразового перевода — 34%, 18% и 2 алгоритма. Это показывает, что поэтапный процесс автоматической тенсоризации способен работать с разными источниками и стилями кода, тогда как эффективность оптимизации остаётся более сложным испытанием.
Код может меняться, алгоритм — нет
Переход от MATLAB к PyTorch и от CPU к GPU меняет язык, структуры данных и стратегию выполнения. Ключевые механизмы алгоритма должны оставаться нетронутыми.
EvoCoCo важен и тем, как он переосмысляет преобразование кода. Фокус смещается с воспроизведения инструкций на определение того, что должно быть сохранено. Когда вычислительная платформа меняется, успешное преобразование не обязано воспроизводить структуру исходной программы. Оно должно допускать реорганизацию вычислений — при условии, что отношения, определяющие алгоритм, продолжают выполняться.
Язык программирования — лишь один способ выразить алгоритм, а аппаратура — лишь один способ выполнить вычисление. Через языки и аппаратуру должен переноситься не код в его форме, а структура, стоящая за вычислением.
Открытый код и ресурсы сообщества
Статья: https://arxiv.org/abs/2609.02387
GitHub: https://github.com/EMI-Group/evococo
Основной проект (EvoX): https://github.com/EMI-Group/evox
QQ-группа: 297969717
QQ-группа | Evolutionary Machine Intelligence