
Un algoritmo evolutivo multi-obiettivo (MOEA) implementato in MATLAB può essere consegnato direttamente a un modello linguistico di grandi dimensioni e riscritto automaticamente come un programma accelerato su GPU? In apparenza sembra significare sostituire MATLAB con PyTorch, gli array con i tensori e i cicli con operazioni batch. La vera difficoltà, però, sta nella semantica dell’algoritmo: quali calcoli possono essere eseguiti in parallelo, quali dipendono da un ordine da preservare, quali variabili sono temporanee e quali trasportano stato attraverso le generazioni. Se queste distinzioni sono errate, il codice convertito può funzionare pur implementando un algoritmo diverso.
Il team EvoX propone EvoCoCo (Evolutionary Code Conversion), un framework multi-agente per la tensorizzazione automatica guidata dalla semantica. Prima comprende l’algoritmo sorgente, poi esplora diverse implementazioni tensorizzate e infine utilizza il feedback di esecuzione per validare, riparare e selezionare i candidati. EvoCoCo è stato valutato su 48 MOEA secondo tre dimensioni: affidabilità della migrazione, fedeltà di ottimizzazione e scalabilità computazionale. La copertura complessiva di fedeltà di ottimizzazione ha raggiunto l’88.2%. Le accelerazioni mediane sono state di 22.6× ridimensionando la dimensione della popolazione e di 80.2× ridimensionando la dimensionalità delle variabili decisionali. A scale maggiori, l’algoritmo rappresentativo MOEA/D-DE ha raggiunto un’accelerazione di 37,339×.
Ciò che è davvero difficile portare su GPU non è la sintassi
I MOEA offrono un notevole parallelismo a livello di popolazione. La valutazione degli obiettivi, la mutazione, l’ordinamento, la selezione ambientale e le operazioni di archivio elaborano spesso gruppi di soluzioni candidate o relazioni all’interno di una popolazione, rendendosi adatti a un’esecuzione parallela tramite calcolo tensoriale su GPU.
Il parallelismo di un algoritmo non significa che la sua implementazione esistente sia pronta per l’esecuzione su GPU. In PlatEMO, ad esempio, il codice MATLAB combina operazioni vettorializzate con cicli a livello di individuo, contenitori dinamici, rami condizionali, estrazione iterativa dei fronti non dominati, slicing di oggetti e varie funzioni di supporto. Portare questo codice su una GPU richiede di riorganizzare le rappresentazioni dei dati, il flusso di controllo e gli aggiornamenti di stato. Questo va oltre la semplice sostituzione della sintassi.
La sfida è identificare quali strutture definiscono l’algoritmo originale:
- Quali variabili rappresentano lo stato dell’algoritmo che persiste attraverso le generazioni?
- Quali calcoli possono essere riscritti usando broadcasting, maschere o indicizzazione batch?
- Quali cicli contengono genuine dipendenze sequenziali e devono essere preservati?
- Quali modifiche a stato e relazioni di aggiornamento altererebbero il meccanismo di ottimizzazione?
EvoCoCo affronta esattamente queste domande. La conversione può modificare i layout dei dati, il flusso di controllo e le strategie di esecuzione, preservando però gli operatori fondamentali, lo stato persistente, le dipendenze e la logica di aggiornamento dell’algoritmo. Questo stabilisce il confine tra ciò che la tensorizzazione automatica può ristrutturare e ciò che deve preservare.
La tensorizzazione automatica richiede più di una generazione di codice una tantum
EvoCoCo divide la conversione del codice in tre fasi: comprensione, tensorizzazione, validazione e selezione. Nessun agente singolo gestisce la conversione dall’inizio alla fine. L’algoritmo sorgente viene analizzato una sola volta per produrre una rappresentazione semantica condivisa. I candidati tensorizzati successivi vengono generati da quella stessa rappresentazione e blueprint. Questo separa la comprensione dell’algoritmo dalla generazione delle implementazioni.
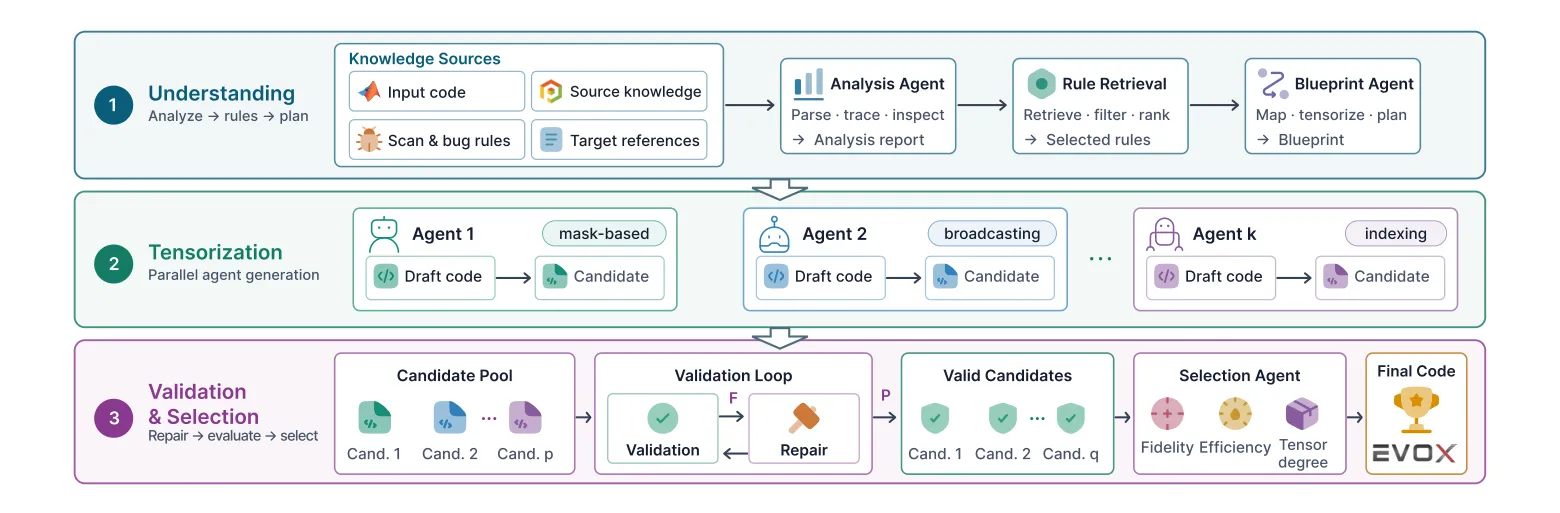
Figura 1. Architettura multi-agente di EvoCoCo. Il Source Analysis Agent ricostruisce la semantica dell’algoritmo, il Rule Retriever recupera le regole di migrazione e il Blueprint Agent crea un blueprint di tensorizzazione. Più Tensorization Agent generano candidati in parallelo sotto vincoli condivisi. Il feedback di esecuzione guida la riparazione, e il Selection Agent effettua la selezione finale.
Fase 1: comprensione. Il Source Analysis Agent ricostruisce la semantica dell’algoritmo sorgente, identificandone gli operatori fondamentali, lo stato persistente, le dipendenze e la logica di aggiornamento. Il Rule Retriever recupera le regole di migrazione pertinenti in base alla struttura dell’algoritmo. Il Blueprint Agent crea quindi un blueprint di tensorizzazione condiviso che specifica come mappare lo stato, come ristrutturare il calcolo e quali vincoli il framework di destinazione deve soddisfare.
Fase 2: tensorizzazione. Sotto lo stesso blueprint, k Tensorization Agent generano candidati in parallelo, con enfasi diverse su broadcasting, ottimizzazione einsum, operazioni mascherate, aggiornamenti in-place, operatori tensoriali avanzati e tensorizzazione della selezione iterativa. Esplorano diverse implementazioni computazionali dello stesso algoritmo, utilizzando la comprensione condivisa del codice sorgente, senza reinterpretare ciascuno il codice sorgente in modo indipendente.
Fase 3: validazione e selezione. I programmi candidati vengono sottoposti a controlli statici e validazione a runtime. I problemi di interfaccia, forma dei tensori, dispositivo, numerici o di flusso di controllo emersi durante l’esecuzione vengono trasmessi al Repair Agent per ulteriori riparazioni. Tra i candidati che superano la validazione, il Selection Agent sceglie l’implementazione definitiva considerando i risultati di ottimizzazione, il tempo di esecuzione e il grado di tensorizzazione.
L’idea chiave è condividere la comprensione dell’algoritmo sorgente, pur consentendo implementazioni GPU diverse.
Il feedback di esecuzione fa convergere il processo di conversione
La traduzione una tantum comprime la comprensione semantica, l’adattamento al framework e la progettazione della tensorizzazione in un unico passo di generazione. Un errore in uno di questi ambiti può manifestarsi solo quando il programma viene effettivamente eseguito, senza un meccanismo per ulteriore diagnosi e riparazione.
EvoCoCo include l’esecuzione nel processo di conversione. I programmi candidati vengono eseguiti nell’ambiente di destinazione; i problemi di interfacce, forme dei tensori, comportamento numerico e aggiornamenti di stato diventano feedback concreto per riparare i candidati. I rami multipli di tensorizzazione offrono anche percorsi di implementazione alternativi. La generazione di codice diventa un ciclo chiuso di generazione, esecuzione, riparazione e selezione.
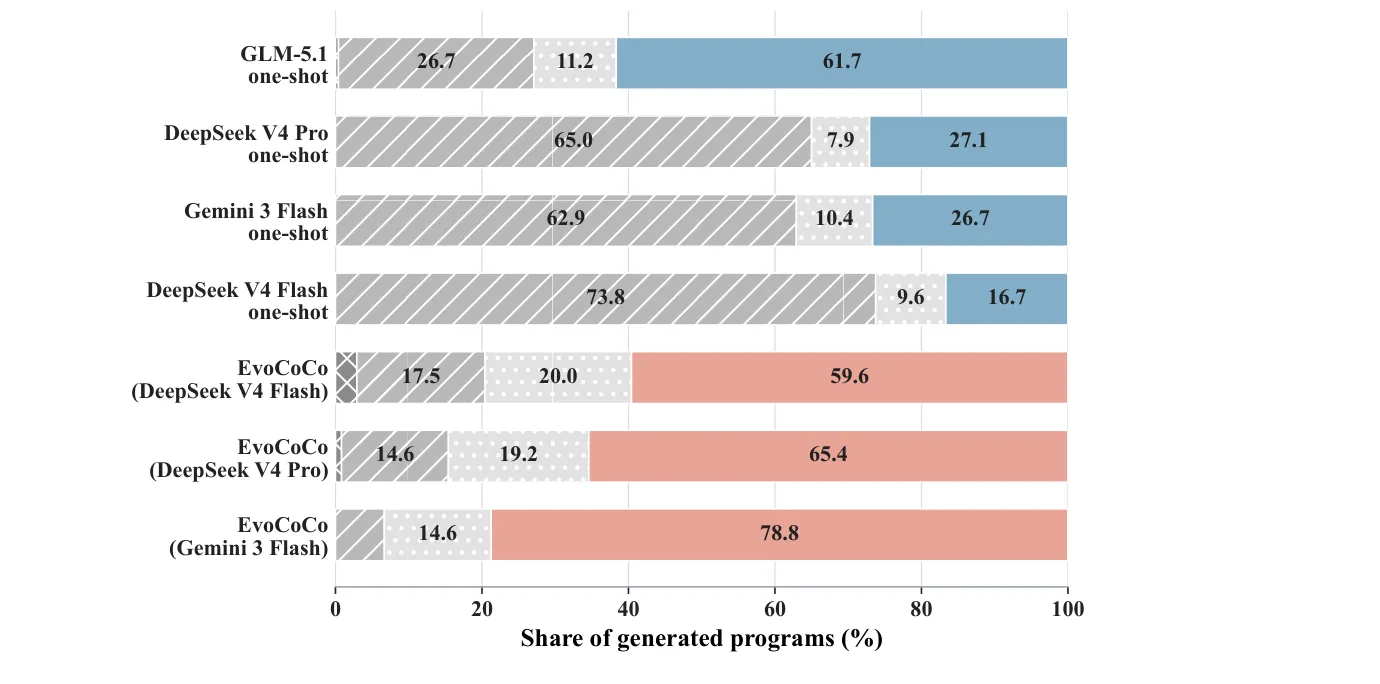
Figura 2. Esiti per fase su 240 tentativi di conversione indipendenti per condizione. In tre confronti con backend abbinato, i fallimenti di esecuzione hanno rappresentato il 62.9%–73.8% dei tentativi di traduzione una tantum, contro il 6.7%–17.5% di EvoCoCo. Più candidati hanno potuto procedere alla valutazione di ottimizzazione.
Questo cambiamento nel punto in cui si verificano i fallimenti mostra che il ciclo di feedback fa più che correggere bug: lascia che l’ambiente di destinazione contribuisca a determinare quali implementazioni tensorizzate siano effettivamente utilizzabili. Molte traduzioni una tantum si fermano alla fase di esecuzione. EvoCoCo ottiene informazioni diagnostiche tramite l’esecuzione reale, quindi ripara e filtra i candidati così che più implementazioni possano procedere alla valutazione del loro comportamento di ottimizzazione.
L’esecuzione corretta è solo il primo passo della migrazione
Gli esperimenti di EvoCoCo affrontano tre domande: se la conversione automatica possa essere completata in modo affidabile, se gli algoritmi convertiti conservino prestazioni di ottimizzazione accettabili e se la tensorizzazione possa sbloccare il parallelismo delle GPU. La valutazione copre affidabilità della migrazione, fedeltà di ottimizzazione e scalabilità computazionale.
1. Affidabilità della migrazione
Nei confronti con backend abbinati, ogni condizione includeva 240 tentativi di conversione indipendenti. EvoCoCo con Gemini 3 Flash ha raggiunto un tasso di superamento dell’esecuzione del 93.33% e un tasso di superamento della convergenza del 78.75%. Per ciascuno dei 48 algoritmi di benchmark, EvoCoCo ha prodotto almeno un’implementazione che ha superato la validazione di convergenza. Il tasso di superamento della convergenza era di 52.08 punti percentuali superiore alla traduzione una tantum con lo stesso backend. Era inoltre di 17.08 punti percentuali superiore a GLM-5.1, la condizione migliore tra tutte le traduzioni una tantum.
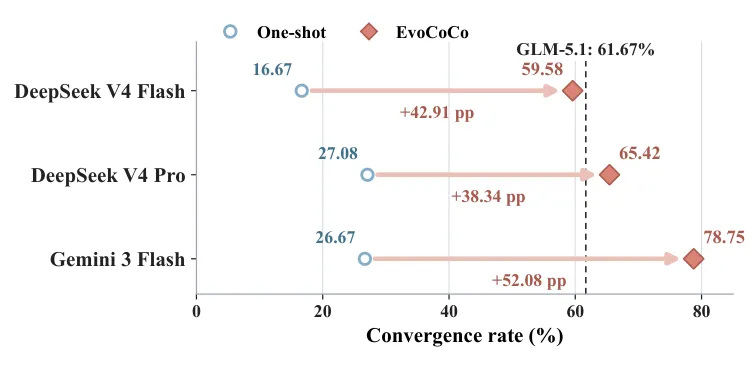
Figura 3. EvoCoCo ha migliorato il tasso di superamento della convergenza rispetto alla traduzione una tantum in tutti e tre i confronti con backend abbinato. La linea tratteggiata rappresenta GLM-5.1, la baseline una tantum più forte.
2. Fedeltà di ottimizzazione
Gli algoritmi evolutivi sono stocastici, quindi il confronto elemento per elemento dell’output di una singola esecuzione non può stabilire se la conversione preservi il comportamento di ottimizzazione. La valutazione ha utilizzato esecuzioni ripetute indipendenti per confrontare i valori finali di inverted generational distance (IGD) delle implementazioni PlatEMO ed EvoX in impostazioni di problema identiche. Le suite DTLZ, WFG, LSMOP e MaF hanno fornito 1,904 confronti validi, di cui 1,680 soddisfacenti il criterio di fedeltà predefinito, per una copertura complessiva dell’88.2%. La copertura ha superato l’80% in tutte e quattro le suite, raggiungendo il 96.5% su WFG. Dei 48 algoritmi, 41 hanno raggiunto una copertura a livello di algoritmo di almeno l’80%.
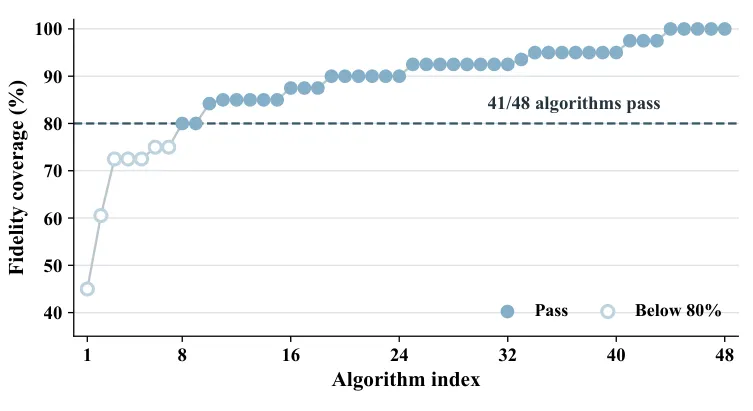
Figura 4. Copertura della fedeltà di ottimizzazione per 48 algoritmi tensorizzati. In totale, 41 algoritmi hanno raggiunto la soglia dell’80%.
3. Scalabilità computazionale
Su tutti i confronti CPU–GPU validi, l’accelerazione mediana è stata di 22.6× ridimensionando la dimensione della popolazione e di 80.2× ridimensionando la dimensionalità delle variabili decisionali. Con l’aumentare delle dimensioni del problema, le implementazioni su GPU hanno generalmente guadagnato un maggiore vantaggio in termini di tempo di esecuzione.
| Asse di ridimensionamento | Confronti validi | Accelerazione mediana | Media geometrica | Scarto interquartile |
|---|---|---|---|---|
| Dimensione della popolazione | 289 | 22.6× | 29.9× | 4.5–163.5× |
| Dimensionalità delle variabili decisionali | 276 | 80.2× | 71.5× | 8.4–404.9× |
Le accelerazioni variano notevolmente tra gli algoritmi, ma la tendenza complessiva è chiara: con l’aumentare della dimensione della popolazione o della dimensionalità delle variabili decisionali, la tensorizzazione guidata dalla semantica sblocca progressivamente il parallelismo a livello di popolazione nascosto nelle strutture dei programmi CPU. Le curve del tempo di esecuzione di algoritmi rappresentativi illustrano ulteriormente questo vantaggio di scalabilità.
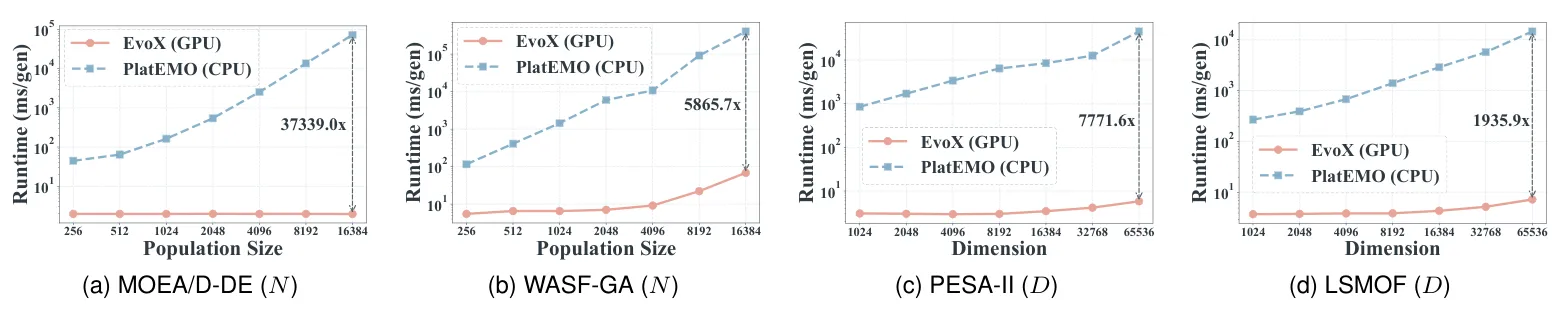
Figura 5. I pannelli (a) e (b) mostrano il ridimensionamento della dimensione della popolazione; i pannelli (c) e (d) quello della dimensionalità delle variabili decisionali. Le annotazioni indicano le accelerazioni alle maggiori scale testate. MOEA/D-DE ha raggiunto 37,339× con N = 16,384.
Oltre alle tre valutazioni principali, ablazioni di componenti e la conversione da fonti esterne hanno messo alla prova i meccanismi chiave di EvoCoCo. Su un sottoinsieme diagnostico di 12 algoritmi, il framework EvoCoCo completo ha raggiunto tassi di superamento di esecuzione e convergenza rispettivamente del 98.3% e 83.3%. Rimuovendo il Repair Agent questi tassi scendono al 60.0% e 41.7%; usando un singolo ramo di generazione al 68.3% e 40.0%. Questi risultati mostrano che il feedback di esecuzione e la generazione multi-ramo sono particolarmente importanti per l’affidabilità della migrazione. Su 10 implementazioni MATLAB/Octave esterne e legacy al di fuori di PlatEMO, EvoCoCo ha raggiunto un tasso di superamento dell’esecuzione del 96% e di convergenza del 62%. Nove algoritmi hanno ottenuto almeno un’implementazione che ha superato la validazione di convergenza. I corrispondenti risultati della traduzione una tantum sono stati 34%, 18% e 2 algoritmi. Ciò indica che il processo di tensorizzazione automatica a fasi può adattarsi a fonti e stili di codice diversi, mentre l’efficacia di ottimizzazione resta la prova più difficile.
Il codice può cambiare, l’algoritmo no
Il passaggio da MATLAB a PyTorch e da CPU a GPU cambia il linguaggio, le strutture dati e la strategia di esecuzione. I meccanismi fondamentali dell’algoritmo dovrebbero rimanere intatti.
EvoCoCo è significativo anche per come ridefinisce la conversione del codice. Sposta l’attenzione dal riprodurre istruzioni all’identificare ciò che deve essere preservato. Quando cambia la piattaforma di calcolo, una conversione riuscita non deve riprodurre la struttura del programma originale. Deve consentire che il calcolo sia riorganizzato, purché continuino a valere le relazioni che definiscono l’algoritmo.
Un linguaggio di programmazione è un modo di esprimere un algoritmo, e l’hardware è un modo di eseguire un calcolo. Ciò che deve sopravvivere alla migrazione tra linguaggi e hardware è la struttura sottesa a quel calcolo.
Codice open source e risorse della comunità
Paper: https://arxiv.org/abs/2609.02387
GitHub: https://github.com/EMI-Group/evococo
Progetto upstream (EvoX): https://github.com/EMI-Group/evox
Gruppo QQ: 297969717
Gruppo QQ | Evolutionary Machine Intelligence