
Kann ein in MATLAB implementierter multikriterieller evolutionärer Algorithmus (MOEA) direkt einem großen Sprachmodell übergeben und automatisch in ein GPU-beschleunigtes Programm umgeschrieben werden? Oberflächlich betrachtet bedeutet das, MATLAB durch PyTorch zu ersetzen, Arrays durch Tensoren und Schleifen durch Batch-Operationen. Die eigentliche Schwierigkeit liegt jedoch in der Semantik des Algorithmus: welche Berechnungen parallel laufen können, welche von einer Reihenfolge abhängen, die erhalten bleiben muss, welche Variablen temporär sind und welche einen Zustand über Generationen hinweg tragen. Werden diese Unterscheidungen falsch getroffen, kann der umgewandelte Code lauffähig sein und dennoch einen anderen Algorithmus implementieren.
Das EvoX-Team stellt EvoCoCo (Evolutionary Code Conversion) vor, ein Multi-Agenten-Framework für semantikgesteuerte automatische Tensorisierung. Es versteht zunächst den Quellalgorithmus, erkundet dann verschiedene tensorisierte Implementierungen und nutzt schließlich Ausführungsfeedback, um Kandidaten zu validieren, zu reparieren und auszuwählen. EvoCoCo wurde an 48 MOEAs in drei Dimensionen evaluiert: Migrationssicherheit, Optimierungstreue und Rechnerische Skalierbarkeit. Die Gesamtdecke der Optimierungstreue erreichte 88.2%. Die medianen Beschleunigungen lagen bei 22.6× beim Skalieren der Populationsgröße und bei 80.2× beim Skalieren der Dimension der Entscheidungsvariablen. In größerem Maßstab erreichte der repräsentative Algorithmus MOEA/D-DE eine Beschleunigung von 37,339×.
Was bei der Portierung auf GPUs wirklich schwer ist, ist nicht die Syntax
MOEAs bieten ein erhebliches Parallelitätspotenzial auf Populationsniveau. Zielfunktionsauswertung, Mutation, Sortierung, Umweltselektion und Archivoperationen verarbeiten häufig ganze Batches von Kandidatenlösungen oder Beziehungen innerhalb einer Population und eignen sich daher gut für eine parallele Ausführung durch Tensorberechnungen auf GPUs.
Dass ein Algorithmus Parallelität bietet, bedeutet nicht, dass seine bestehende Implementierung für die GPU-Ausführung bereit ist. In PlatEMO etwa kombiniert der MATLAB-Code vektorisierte Operationen mit individuenbezogenen Schleifen, dynamischen Containern, bedingten Verzweigungen, iterativer Extraktion nicht-dominierter Fronten, Objekt-Slicing und zahlreichen Hilfsfunktionen. Die Portierung dieses Codes auf eine GPU erfordert die Neuorganisation von Datenrepräsentationen, Kontrollfluss und Zustandsaktualisierungen. Das geht über das bloße Ersetzen von Syntax hinaus.
Die Herausforderung besteht darin zu erkennen, welche Strukturen den ursprünglichen Algorithmus definieren:
- Welche Variablen repräsentieren einen Algorithmuszustand, der über Generationen hinweg besteht?
- Welche Berechnungen lassen sich mit Broadcasting, Masken oder Batch-Indizierung umschreiben?
- Welche Schleifen enthalten echte sequenzielle Abhängigkeiten und müssen erhalten bleiben?
- Welche Änderungen an Zustand und Aktualisierungsbeziehungen würden den Optimierungsmechanismus verändern?
Genau diese Fragen behandelt EvoCoCo. Die Umwandlung darf Datenlayouts, Kontrollfluss und Ausführungsstrategien verändern, während die Kernoperatoren, der persistente Zustand, die Abhängigkeiten und die Aktualisierungslogik des Algorithmus erhalten bleiben. Damit wird die Grenze festgelegt zwischen dem, was automatische Tensorisierung umstrukturieren darf, und dem, was sie bewahren muss.
Automatische Tensorisierung ist mehr als einmalige Codegenerierung
EvoCoCo gliedert die Codeumwandlung in drei Phasen: Verstehen, Tensorisierung sowie Validierung und Auswahl. Kein einzelner Agent führt die Umwandlung von Anfang bis Ende durch. Der Quellalgorithmus wird einmalig analysiert, um eine gemeinsame semantische Repräsentation zu erzeugen. Alle weiteren Tensorisierungskandidaten werden aus derselben Repräsentation und demselben Blueprint erzeugt. Dadurch wird das Algorithmusverständnis von der Implementierungsgenerierung getrennt.
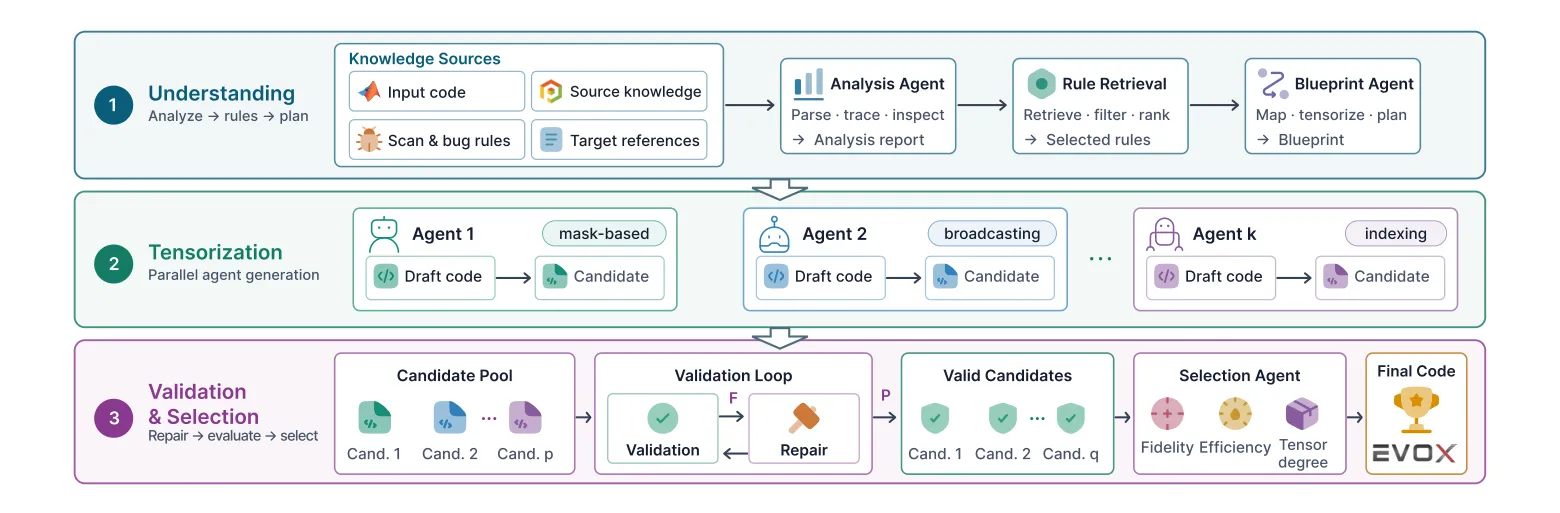
Abbildung 1. Die Multi-Agenten-Architektur von EvoCoCo. Der Source Analysis Agent rekonstruiert die Algorithmussemantik, der Rule Retriever ruft Migrationsregeln ab, und der Blueprint Agent erstellt einen Tensorisierungs-Blueprint. Mehrere Tensorization Agents erzeugen unter gemeinsamen Nebenbedingungen parallel Kandidaten. Ausführungsfeedback steuert die Reparatur, und der Selection Agent trifft die endgültige Auswahl.
Schritt 1: Verstehen. Der Source Analysis Agent rekonstruiert die Semantik des Quellalgorithmus und identifiziert dessen Kernoperatoren, persistenten Zustand, Abhängigkeiten und Aktualisierungslogik. Der Rule Retriever ruft anhand der Struktur des Algorithmus relevante Migrationsregeln ab. Der Blueprint Agent erstellt anschließend einen gemeinsamen Tensorisierungs-Blueprint, der festlegt, wie der Zustand abgebildet, wie die Berechnung umstrukturiert wird und welche Nebenbedingungen das Zielframework erfüllen muss.
Schritt 2: Tensorisierung. Unter demselben Blueprint erzeugen k Tensorization Agents parallel Kandidaten, mit unterschiedlichen Schwerpunkten auf Broadcasting, einsum-Optimierung, maskierten Operationen, In-place-Aktualisierungen, fortgeschrittenen Tensoroperatoren und der Tensorisierung iterativer Selektion. Sie erkunden verschiedene computationale Implementierungen desselben Algorithmus auf Grundlage des gemeinsamen Verständnisses des Quellcodes, statt den Quellcode jeweils unabhängig neu zu interpretieren.
Schritt 3: Validierung und Auswahl. Kandidatenprogramme durchlaufen statische Prüfungen und Laufzeitvalidierung. Schnittstellen-, Tensorform-, Geräte-, Numerik- oder Kontrollflussprobleme, die bei der Ausführung auftreten, werden zur weiteren Reparatur an den Repair Agent zurückgemeldet. Unter den Kandidaten, die die Validierung bestehen, wählt der Selection Agent die endgültige Implementierung unter Berücksichtigung von Optimierungsergebnissen, Laufzeit und Tensorisierungsgrad aus.
Die Kernidee: Das Verständnis des Quellalgorithmus wird geteilt, während vielfältige GPU-Implementierungen erlaubt sind.
Ausführungsfeedback lässt den Umwandlungsprozess konvergieren
Eine einmalige Übersetzung komprimiert semantisches Verständnis, Framework-Anpassung und Tensorisierungsentwurf in einen einzigen Generierungsschritt. Ein Fehler in einem dieser Bereiche wird möglicherweise erst sichtbar, wenn das Programm tatsächlich läuft – ohne Mechanismus für weitere Diagnose und Reparatur.
EvoCoCo bezieht die Ausführung in den Umwandlungsprozess ein. Kandidatenprogramme laufen in der Zielumgebung; Probleme mit Schnittstellen, Tensorformen, numerischem Verhalten und Zustandsaktualisierungen werden zu konkretem Feedback für die Reparatur der Kandidaten. Mehrere Tensorisierungszweige bieten zudem alternative Implementierungspfade. Codegenerierung wird zu einem geschlossenen Kreislauf aus Generierung, Ausführung, Reparatur und Auswahl.
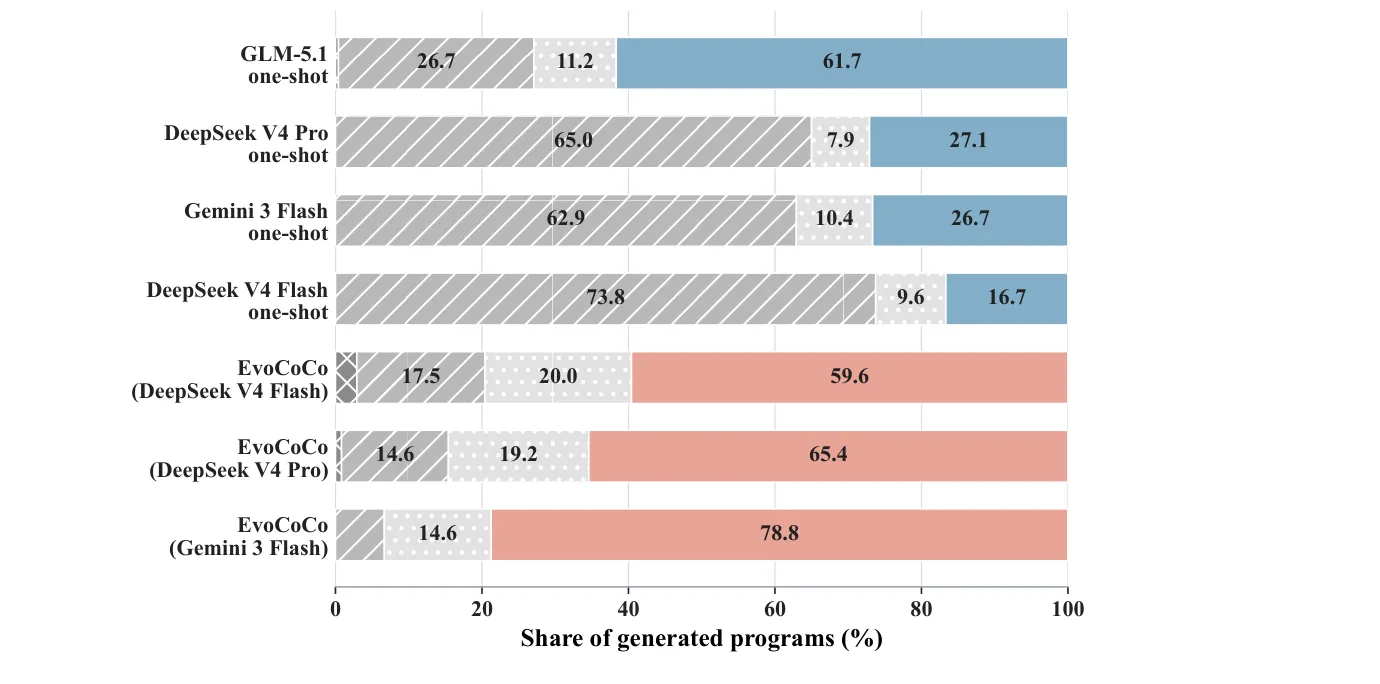
Abbildung 2. Ergebnisse je Phase über 240 unabhängige Umwandlungsversuche pro Bedingung. In drei Vergleichen mit identischem Modell-Backend entfielen auf Ausführungsfehler 62.9%–73.8% der einmaligen Übersetzungsversuche, gegenüber 6.7%–17.5% bei EvoCoCo. Mehr Kandidaten gelangten zur Optimierungsevaluation.
Diese Verschiebung der Fehlerstelle zeigt, dass die Feedback-Schleife mehr leistet als Fehler beheben: Sie lässt die Zielumgebung mitentscheiden, welche tensorisierten Implementierungen tatsächlich brauchbar sind. Viele einmalige Übersetzungen bleiben auf der Ausführungsstufe stecken. EvoCoCo gewinnt durch echte Ausführung Diagnoseinformationen, repariert und filtert Kandidaten, sodass mehr Implementierungen zur Evaluation ihres Optimierungsverhaltens vordringen.
Erfolgreiche Ausführung ist nur die erste Hürde der Migration
Die Experimente von EvoCoCo beantworten drei Fragen: ob die automatische Umwandlung zuverlässig abgeschlossen werden kann, ob umgewandelte Algorithmen akzeptable Optimierungsleistung bewahren und ob die Tensorisierung die GPU-Parallelität freisetzen kann. Die Evaluation umfasst Migrationssicherheit, Optimierungstreue und Rechnerische Skalierbarkeit.
1. Migrationssicherheit
In Vergleichen mit identischem Modell-Backend umfasste jede Bedingung 240 unabhängige Umwandlungsversuche. EvoCoCo mit Gemini 3 Flash erreichte eine Ausführungsbestehensquote von 93.33% und eine Konvergenzbestehensquote von 78.75%. Für jeden der 48 Benchmark-Algorithmen erzeugte EvoCoCo mindestens eine Implementierung, die die Konvergenzvalidierung bestand. Die Konvergenzbestehensquote lag 52.08 Prozentpunkte über der einmaligen Übersetzung mit demselben Backend und 17.08 Prozentpunkte über GLM-5.1, der besten Bedingung unter allen einmaligen Übersetzungen.
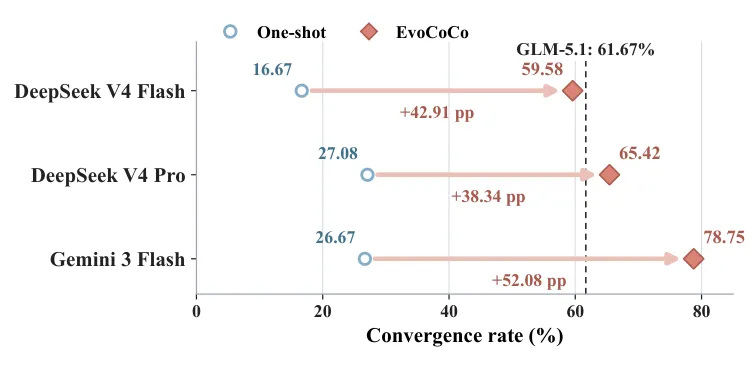
Abbildung 3. EvoCoCo steigerte die Konvergenzbestehensquote gegenüber der einmaligen Übersetzung in allen drei Vergleichen mit identischem Backend. Die gestrichelte Linie stellt GLM-5.1 dar, die stärkste Baseline der einmaligen Übersetzung.
2. Optimierungstreue
Evolutionäre Algorithmen sind stochastisch, daher kann ein elementweiser Vergleich der Ausgaben eines einzelnen Laufes nicht belegen, dass die Umwandlung das Optimierungsverhalten bewahrt. Die Evaluation nutzte unabhängige wiederholte Läufe, um unter identischen Problemeinstellungen die finalen IGD-Werte (Inverted Generational Distance) der PlatEMO- und EvoX-Implementierungen zu vergleichen. Die Suiten DTLZ, WFG, LSMOP und MaF lieferten 1,904 gültige Vergleiche, von denen 1,680 das vordefinierte Treuekriterium erfüllten – eine Gesamtdecke von 88.2%. Die Decke überstieg in allen vier Suiten 80% und erreichte auf WFG 96.5%. Von den 48 Algorithmen erreichten 41 eine Decke auf Algorithmusebene von mindestens 80%.
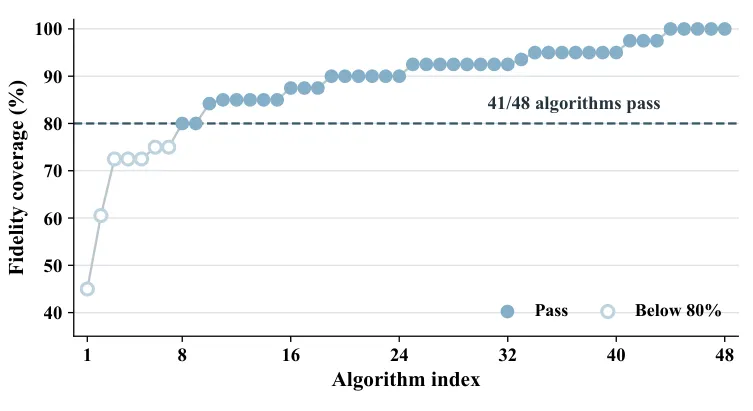
Abbildung 4. Decke der Optimierungstreue für 48 tensorisierte Algorithmen. Insgesamt erreichten 41 Algorithmen die 80%-Schwelle.
3. Rechnerische Skalierbarkeit
Über alle gültigen CPU–GPU-Vergleiche hinweg betrug die mediane Beschleunigung 22.6× beim Skalieren der Populationsgröße und 80.2× beim Skalieren der Entscheidungsvariablendimension. Mit weiter wachsender Problemgröße nahm der Laufzeitvorteil der GPU-Implementierungen im Allgemeinen zu.
| Skalierungsachse | Gültige Vergleiche | Median Beschleunigung | Geometrisches Mittel | Interquartilsabstand |
|---|---|---|---|---|
| Populationsgröße | 289 | 22.6× | 29.9× | 4.5–163.5× |
| Entscheidungsvariablendimension | 276 | 80.2× | 71.5× | 8.4–404.9× |
Die Beschleunigungen unterscheiden sich je Algorithmus erheblich, doch der Gesamttrend ist klar: Mit wachsender Populationsgröße oder Entscheidungsvariablendimension gibt die semantikgesteuerte Tensorisierung schrittweise das Parallelitätspotenzial auf Populationsniveau frei, das in CPU-Programmstrukturen verborgen war. Laufzeitkurven repräsentativer Algorithmen veranschaulichen diesen Skalierungsvorteil zusätzlich.
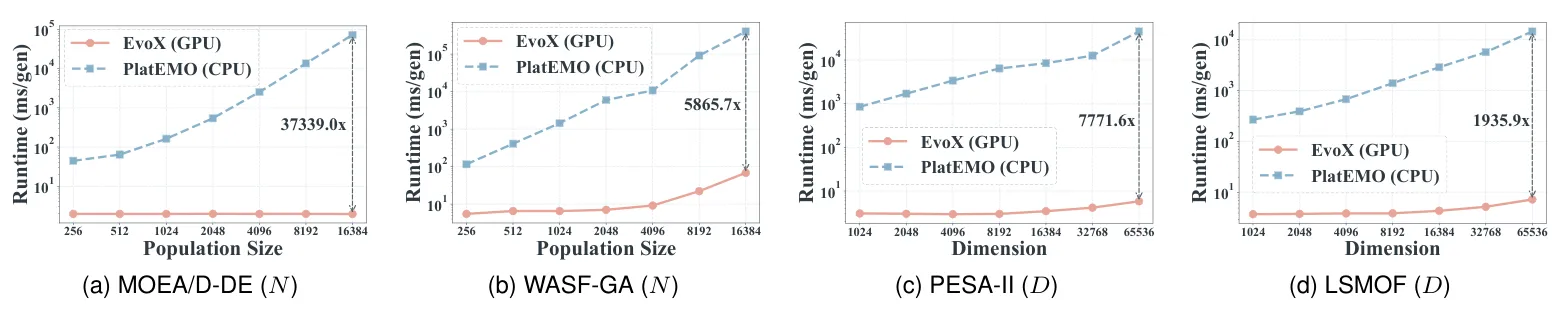
Abbildung 5. Die Panels (a) und (b) zeigen die Skalierung der Populationsgröße, die Panels (c) und (d) die Skalierung der Entscheidungsvariablendimension. Anmerkungen geben die Beschleunigungen in den größten getesteten Skalen an. MOEA/D-DE erreichte 37,339× bei N = 16,384.
Über die drei Kernevaluationen hinaus prüften Komponenten-Ablationen und die Umwandlung externer Quellen die Schlüsselmechanismen von EvoCoCo. Auf einem diagnostischen Teilset von 12 Algorithmen erreichte das vollständige EvoCoCo-Framework Ausführungs- und Konvergenzquoten von 98.3% bzw. 83.3%. Ohne den Repair Agent sanken diese Quoten auf 60.0% und 41.7%; mit einem einzigen Generierungszweig auf 68.3% und 40.0%. Diese Ergebnisse zeigen, dass Ausführungsfeedback und verzweigte Generierung für die Migrationssicherheit besonders wichtig sind. Auf 10 externen und älteren MATLAB/Octave-Implementierungen außerhalb von PlatEMO erreichte EvoCoCo eine Ausführungsquote von 96% und eine Konvergenzquote von 62%. Neun Algorithmen erhielten mindestens eine Implementierung, die die Konvergenzvalidierung bestand. Die entsprechenden Werte der einmaligen Übersetzung waren 34%, 18% und 2 Algorithmen. Das zeigt, dass der phasenweise Prozess der automatischen Tensorisierung unterschiedliche Quellen und Codestile verarbeiten kann, während die Optimierungseffektivität die schwierigere Prüfung bleibt.
Code kann sich ändern, der Algorithmus nicht
Der Wechsel von MATLAB zu PyTorch und von CPUs zu GPUs verändert Sprache, Datenstrukturen und Ausführungsstrategie. Die Kernmechanismen des Algorithmus sollten unangetastet bleiben.
Bedeutsam an EvoCoCo ist auch, wie es Codeumwandlung neu rahmt. Der Fokus verschiebt sich von der Reproduktion von Anweisungen zur Frage, was bewahrt werden muss. Wenn sich die Rechenplattform ändert, muss eine gelungene Umwandlung die ursprüngliche Programmstruktur nicht reproduzieren. Sie sollte erlauben, die Berechnung neu zu organisieren, sofern die Beziehungen, die den Algorithmus definieren, weiterhin gelten.
Eine Programmiersprache ist eine Art, einen Algorithmus auszudrücken, und Hardware ist eine Art, Berechnung auszuführen. Was über Sprachen und Hardware hinweg wandern muss, ist nicht die Form des Codes, sondern die Struktur hinter der Berechnung.
Open Source und Community
Paper: https://arxiv.org/abs/2609.02387
GitHub: https://github.com/EMI-Group/evococo
Upstream-Projekt (EvoX): https://github.com/EMI-Group/evox
QQ-Gruppe: 297969717
QQ-Gruppe | Evolutionary Machine Intelligence