
MATLAB로 구현된 다목적 진화 알고리즘(MOEA)을 대규모 언어 모델에 그대로 넘겨 GPU 가속 프로그램으로 자동 변환할 수 있을까요? 겉보기에는 MATLAB을 PyTorch로 바꾸고, 배열을 텐서로 바꾸고, 반복문을 배치 연산으로 바꾸는 일처럼 보입니다. 그러나 진짜 어려움은 알고리즘 의미론(semantics)에 있습니다. 어떤 계산이 병렬로 실행될 수 있고, 어떤 계산에 반드시 지켜야 하는 순서 의존이 있으며, 어떤 변수가 임시값이고 어떤 변수가 세대를 가로질러 상태를 유지하는지 말입니다. 이 구분이 틀리면 변환된 코드는 잘 동작하면서도 전혀 다른 알고리즘을 구현하고 있을 수 있습니다.
EvoX 팀은 의미 기반 자동 텐서화를 위한 다중 에이전트 프레임워크인 EvoCoCo(Evolutionary Code Conversion)를 제안했습니다. EvoCoCo는 먼저 원본 알고리즘을 이해하고, 이어서 다양한 텐서화 구현을 탐색하며, 마지막으로 실행 피드백으로 후보를 검증·수리·선택합니다. EvoCoCo는 48개 MOEA에 대해 이식 신뢰성, 최적화 충실도, 계산 확장성의 세 가지 관점에서 평가되었습니다. 전체 최적화 충실도 커버리지는 88.2%에 달했습니다. 개체 집단 크기를 확장할 때 중앙값 가속은 22.6×, 의사결정 변수 차원을 확장할 때는 80.2×였습니다. 더 큰 규모에서는 대표 알고리즘 MOEA/D-DE가 37,339×의 가속을 달성했습니다.
GPU 이식에서 정말 어려운 것은 문법이 아니라 알고리즘 의미론입니다
MOEA는 개체 집단 수준의 병렬성이 매우 큽니다. 목적 함수 평가, 변이, 정렬, 환경 선택, 아카이브 연산은 후보 해 집단이나 집단 내부의 관계를 한 번에 처리하는 경우가 많아, GPU에서의 텐서 계산을 통한 병렬 실행에 자연스럽게 들어맞습니다.
그러나 알고리즘 자체가 병렬성을 지닌다고 해서 기존 구현이 그대로 GPU 실행에 적합한 것은 아닙니다. 예를 들어 PlatEMO의 MATLAB 코드는 벡터화 연산과 개체 단위 반복문, 동적 컨테이너, 조건 분기, 반복적인 비지배 프론트 추출, 객체 슬라이싱, 각종 보조 함수가 뒤섞여 있습니다. 이 코드를 GPU로 옮기려면 데이터 표현과 제어 흐름, 상태 갱신을 재구성해야 하며, 단순한 문법 치환으로는 해결되지 않습니다.
핵심은 원래 알고리즘을 정의하는 구조가 무엇인지 판별하는 일입니다.
- 어떤 변수가 세대를 가로질러 유지되는 알고리즘 상태를 나타내는가?
- 어떤 계산을 브로드캐스팅, 마스크, 배치 인덱싱으로 다시 쓸 수 있는가?
- 어떤 반복문에 본질적인 순서 의존이 있어 보존해야 하는가?
- 어떤 상태와 갱신 관계가 바뀌면 최적화 메커니즘 자체가 달라지는가?
EvoCoCo가 정확히 다루는 것이 이 문제입니다. 변환 과정에서 데이터 배치, 제어 흐름, 실행 전략은 바뀔 수 있지만, 알고리즘의 핵심 연산자, 영속 상태, 의존 관계, 갱신 논리는 보존됩니다. 이는 자동 텐서화에서 재구성해도 되는 것과 반드시 유지해야 하는 것의 경계를 확립합니다.
자동 텐서화는 한 번의 생성으로 끝나지 않습니다
EvoCoCo는 코드 변환을 이해, 텐서화, 검증과 선택의 세 단계로 나눕니다. 어떤 단일 에이전트도 변환 전체를 처음부터 끝까지 담당하지 않습니다. 원본 알고리즘은 한 번만 분석되어 공유 의미 표현을 만들어냅니다. 이후의 텐서화 후보는 모두 그 같은 표현과 청사진에서 생성되므로, 알고리즘 이해와 구현 생성이 분리됩니다.
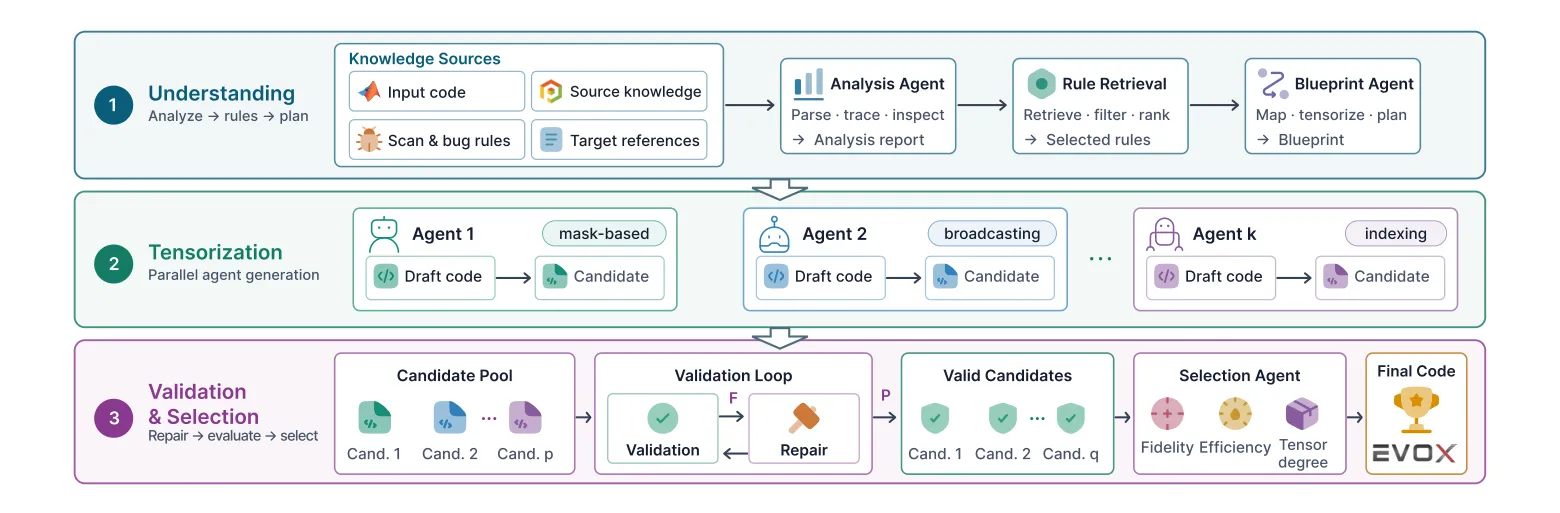
그림 1: EvoCoCo의 다중 에이전트 아키텍처. Source Analysis Agent가 알고리즘 의미론을 재구성하고, Rule Retriever가 이식 규칙을 검색하며, Blueprint Agent가 텐서화 청사진을 작성합니다. 여러 Tensorization Agent가 공유 제약 아래 병렬로 후보를 생성하고, 실행 피드백이 수리를 유도하며, Selection Agent가 최종 선택을 수행합니다.
1단계: 이해. Source Analysis Agent가 원본 알고리즘의 의미론을 재구성하여 핵심 연산자, 영속 상태, 의존 관계, 갱신 논리를 식별합니다. Rule Retriever가 알고리즘 구조에 따라 관련 이식 규칙을 검색합니다. 이어서 Blueprint Agent가 상태를 어떻게 매핑하고 계산을 어떻게 재구성하며 대상 프레임워크가 어떤 제약을 만족해야 하는지 규정한 공유 텐서화 청사진을 만듭니다.
2단계: 텐서화. 같은 청사진 아래에서 k개의 Tensorization Agent가 각기 다른 강조점으로 후보를 병렬 생성합니다. 브로드캐스팅, einsum 최적화, 마스크 연산, 제자리 갱신, 고급 텐서 연산자, 반복 선택의 텐서화 등이 그 강조점입니다. 이들은 원본 코드에 대한 공유된 이해를 바탕으로 같은 알고리즘의 서로 다른 계산 구현을 탐색하며, 각자 따로 원본 코드를 다시 해석하는 것이 아닙니다.
3단계: 검증과 선택. 후보 프로그램은 정적 검사와 실행 검증을 거칩니다. 실행 중에 드러난 인터페이스, 텐서 모양, 장치, 수치, 제어 흐름 문제는 Repair Agent에 전달되어 다시 수리됩니다. 검증을 통과한 후보 가운데에서 Selection Agent가 최적화 결과, 실행 시간, 텐서화 정도를 종합해 최종 구현을 선택합니다.
핵심 아이디어는 원본 알고리즘에 대한 이해는 공유하면서, GPU 구현의 다양성은 허용하는 것입니다.
실행 피드백이 변환 과정을 수렴시킵니다
한 번의 번역은 의미 이해, 프레임워크 적응, 텐서화 설계를 단 한 번의 생성에 압축합니다. 어느 한 부분의 오류는 프로그램이 실제로 실행될 때에야 드러나며, 이를 진단하고 수리할 장치가 없습니다.
EvoCoCo는 실행 자체를 변환 과정에 포함시킵니다. 후보 프로그램은 대상 환경에서 실행되고, 인터페이스, 텐서 모양, 수치 동작, 상태 갱신의 문제가 후보를 수리할 구체적인 피드백이 됩니다. 여러 텐서화 분기는 서로 다른 구현 경로를 제공합니다. 코드 생성은 생성—실행—수리—선택의 닫힌 순환으로 바뀝니다.
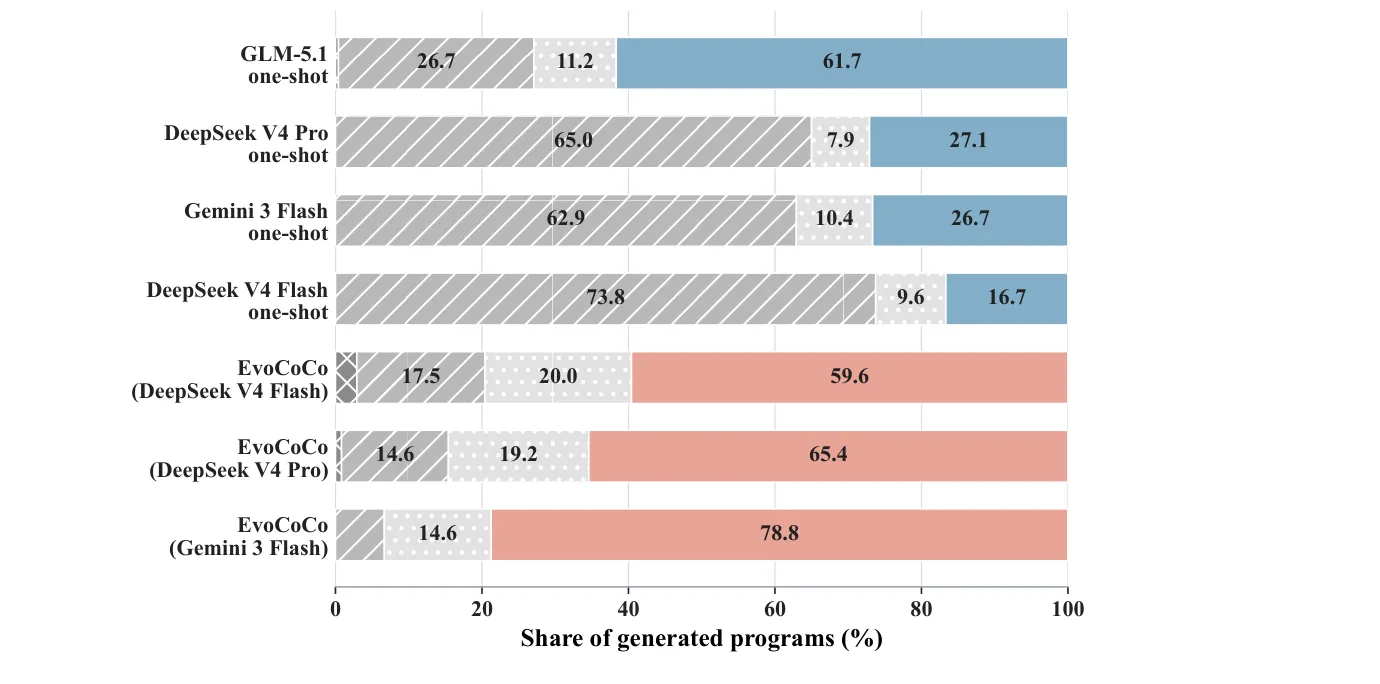
그림 2: 조건별 240회의 독립 변환 시도에 대한 단계별 결과. 백엔드를 통일한 세 비교에서 한 번의 번역은 실행 실패가 62.9%–73.8%를 차지한 반면, EvoCoCo는 6.7%–17.5%에 그쳤습니다. 더 많은 후보가 최적화 평가로 진행될 수 있었습니다.
실패가 발생하는 위치의 이러한 변화는 피드백 순환이 단순히 버그를 고치는 것 이상이라는 점을 보여줍니다. 대상 환경이 어떤 텐서화 구현이 실제로 쓸 만한지 판단하는 과정에 참여하게 되는 것입니다. 한 번의 번역 결과 상당수는 실행 단계에서 멈추지만, EvoCoCo는 실제 실행을 통해 진단 정보를 얻어 후보를 수리·선별함으로써 더 많은 구현이 최적화 동작 평가로 나아가게 합니다.
코드가 실행되는 것은 이식의 첫 관문일 뿐입니다
EvoCoCo의 실험은 세 가지 질문에 답합니다. 자동 변환을 안정적으로 완료할 수 있는가, 변환된 알고리즘이 허용 범위 내의 최적화 성능을 유지하는가, 텐서화가 GPU 병렬성을 실제로 끌어낼 수 있는가. 평가는 이식 신뢰성, 최적화 충실도, 계산 확장성의 세 축에서 이루어졌습니다.
1. 이식 신뢰성
모델 백엔드를 통일한 비교에서 각 조건은 240회의 독립 변환 시도를 포함했습니다. EvoCoCo(Gemini 3 Flash)는 실행 통과율 93.33%, 수렴 통과율 78.75%를 달성했습니다. 48개 벤치마크 알고리즘 각각에 대해 EvoCoCo는 수렴 검증을 통과한 구현을 최소 하나 이상 생성했습니다. 수렴 통과율은 같은 백엔드의 한 번 번역보다 52.08 퍼센트포인트 높았고, 모든 한 번 번역 조건 중 가장 좋았던 GLM-5.1보다도 17.08 퍼센트포인트 높았습니다.
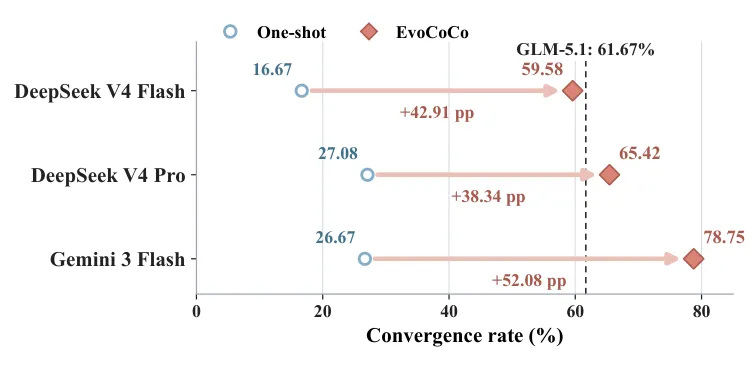
그림 3: 백엔드를 통일한 세 비교 모두에서 EvoCoCo는 한 번 번역보다 높은 수렴 통과율을 달성했습니다. 점선은 가장 강한 한 번 번역 기준선인 GLM-5.1을 나타냅니다.
2. 최적화 충실도
진화 알고리즘은 확률적이므로 한 번 실행한 출력을 요소별로 비교해서는 변환이 원래의 최적화 동작을 보존하는지 판단할 수 없습니다. 평가는 독립 반복 실행을 통해 동일한 문제 설정에서 PlatEMO 구현과 EvoX 구현의 최종 IGD(inverted generational distance) 값을 비교했습니다. DTLZ, WFG, LSMOP, MaF 스위트에서 총 1,904건의 유효 비교가 이루어졌고 이 중 1,680건이 사전 정의된 충실도 기준을 충족하여 전체 커버리지는 88.2%였습니다. 네 스위트 모두에서 커버리지가 80%를 넘었고 WFG에서는 96.5%에 도달했습니다. 48개 알고리즘 중 41개가 알고리즘 수준에서 80% 이상의 커버리지를 달성했습니다.
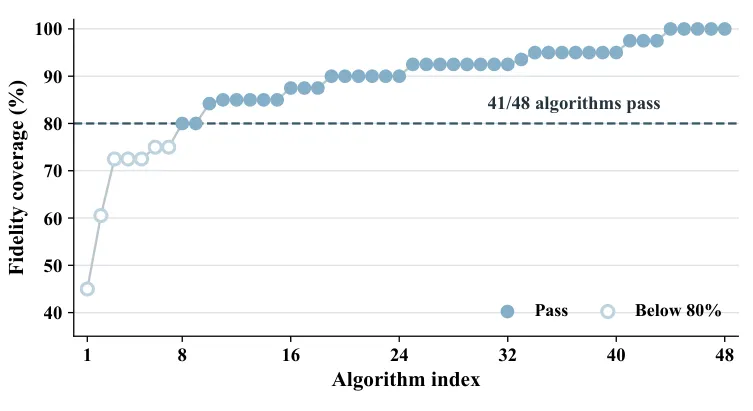
그림 4: 텐서화된 48개 알고리즘의 최적화 충실도 커버리지. 41개 알고리즘이 80% 임계값에 도달했습니다.
3. 계산 확장성
유효한 CPU–GPU 비교 전반에서 개체 집단 크기 확장 시 중앙값 가속은 22.6×, 의사결정 변수 차원 확장 시 중앙값 가속은 80.2×였습니다. 문제 규모가 더 커지면 GPU 구현의 실행 시간 우위는 대체로 더 커졌습니다.
| 확장 축 | 유효 비교 수 | 중앙값 가속 | 기하 평균 가속 | 사분위 범위 |
|---|---|---|---|---|
| 개체 집단 크기 | 289 | 22.6× | 29.9× | 4.5–163.5× |
| 의사결정 변수 차원 | 276 | 80.2× | 71.5× | 8.4–404.9× |
가속 폭은 알고리즘마다 크게 다르지만 전체 추세는 분명합니다. 개체 집단 크기나 의사결정 변수 차원이 커질수록 의미 기반 텐서화는 CPU 프로그램 구조에 숨어 있던 집단 수준 병렬성을 점진적으로 끌어냅니다. 대표 알고리즘의 실행 시간 곡선이 이러한 확장성 우위를 잘 보여줍니다.
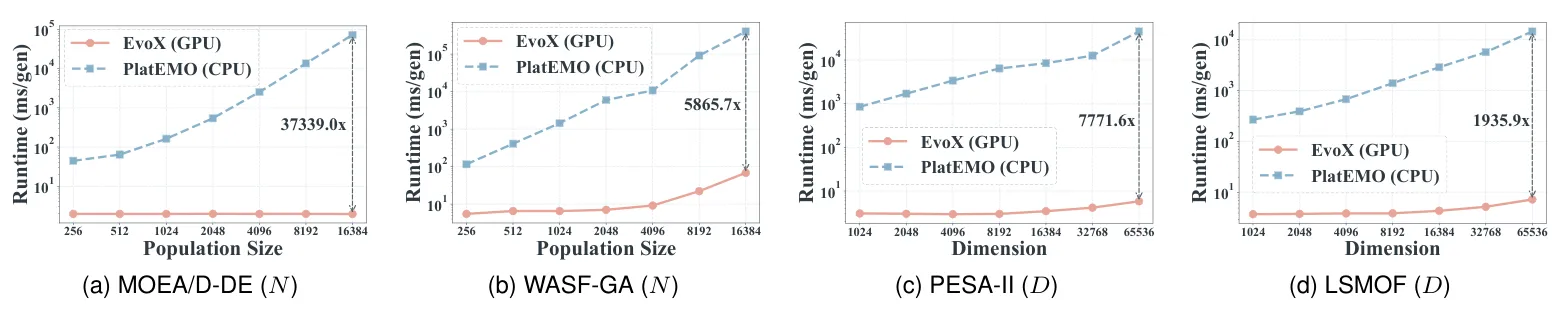
그림 5: (a)(b)는 개체 집단 크기 확장, (c)(d)는 의사결정 변수 차원 확장입니다. 주석은 최대 테스트 규모에서의 가속비를 나타내며, MOEA/D-DE는 N = 16,384에서 37,339×에 도달했습니다.
세 가지 핵심 평가 외에도 구성 요소 절제(ablation) 실험과 외부 소스 변환이 EvoCoCo의 핵심 메커니즘과 변환 능력을 추가로 검증했습니다. 12개 알고리즘으로 구성된 진단용 하위 집합에서 완전한 EvoCoCo 프레임워크의 실행·수렴 통과율은 각각 98.3%와 83.3%였습니다. Repair Agent를 제거하면 60.0%와 41.7%로, 단일 생成分기를 사용하면 68.3%와 40.0%로 떨어졌습니다. 이는 실행 피드백과 다중 분기 생성이 이식 신뢰성에 특히 중요함을 보여줍니다. 또한 PlatEMO 외부의 10개 외부·레거시 MATLAB/Octave 구현에서 EvoCoCo는 실행 통과율 96%, 수렴 통과율 62%를 달성했고 9개 알고리즘이 수렴 검증을 통과한 구현을 최소 하나 확보했습니다. 한 번 번역의 해당 결과는 34%, 18%, 2개 알고리즘이었습니다. 이는 단계적 자동 텐서화 과정이 다양한 코드 소스와 스타일을 수용할 수 있음을 보여주는 동시에, 최적화 유효성은 여전히 더 어려운 관문임을 시사합니다.
코드는 변해도 알고리즘은 변하지 않아야 합니다
MATLAB에서 PyTorch로, CPU에서 GPU로의 이동은 언어와 자료구조, 실행 방식을 바꿉니다. 그러나 알고리즘의 핵심 메커니즘은 그대로 남아 있어야 합니다.
EvoCoCo가 주목받을 만한 또 다른 점은 코드 변환을 바라보는 관점을 바꿨다는 것입니다. 이는 이 문장들을 어떻게 재현할까에서 무엇이 반드시 보존되어야 하는가로 초점을 옮깁니다. 컴퓨팅 플랫폼이 바뀔 때 성공적인 변환은 원래 프로그램 구조를 그대로 재현할 필요가 없으며, 알고리즘을 정의하는 관계가 유지되는 한 계산의 재구성을 허용해야 합니다.
프로그래밍 언어는 알고리즘을 표현하는 한 가지 방식이고 하드웨어는 계산을 수행하는 한 가지 수단일 뿐입니다. 언어와 하드웨어를 가로질러 이전되어야 할 것은 코드의 형식이 아니라 계산 이면의 구조입니다.
오픈소스와 커뮤니티
논문: https://arxiv.org/abs/2609.02387
GitHub: https://github.com/EMI-Group/evococo
상위 프로젝트(EvoX): https://github.com/EMI-Group/evox
QQ 그룹: 297969717
QQ 그룹 | Evolutionary Machine Intelligence