
一份MATLAB实现的多目标优化算法 (MOEA),能不能直接交给大模型,自动改写成能在GPU加速的程序?表面看,这只是把MATLAB换成PyTorch、数组换成张量、循环改成批量操作。但真正困难的不是语法,而是算法语义。哪些计算可以并行,哪些存在不可打乱的顺序依赖;哪些只是中间变量,哪些构成跨代状态。判断错了,代码即使能跑,也可能已经不是原来的算法。
EvoX团队提出EvoCoCo (Evolutionary Code Conversion),以语义引导的方式完成自动张量化:先理解源算法,再探索不同的张量化实现,最后通过执行反馈进行验证、修复与选择。EvoCoCo在48个MOEAs上验证了这一路线,并从迁移可靠性、优化保真度与计算扩展性三个方面进行评估。整体优化保真度覆盖率达到88.2%,种群规模与决策维度扩展的中位加速比分别为22.6×和80.2×。在更大规模下,代表性算法MOEA/D-DE的加速比达到37339×。
GPU上真正难搬的,不是语法
MOEAs本身具有很强的群体级并行性。目标评估、变异、排序、环境选择和档案操作,往往都需要同时处理一批候选解或种群关系,天然适合通过张量计算在GPU上并行执行。
但算法本身具备并行性,并不意味着现有实现已经适合GPU执行。以PlatEMO为例,MATLAB代码中既有向量化操作,也混合着个体级循环、动态容器、条件分支、迭代式前沿提取、对象切片以及各种辅助函数。真正要迁移到GPU,必须重新组织数据表示、控制流程和状态更新,而不是简单替换语法。
因此,难点在于判断哪些结构定义了原算法本身:
- 哪些变量是跨代保留的算法状态?
- 哪些计算可以改写为广播、掩码或批量索引?
- 哪些循环包含真正的顺序依赖,必须保留下来?
- 哪些状态和更新关系一旦改变,就会改变算法的优化机制?
EvoCoCo要解决的正是这个问题。迁移时可以改变数据布局、控制流程和执行方式,但算法的核心算子、持久状态、依赖关系与更新逻辑必须保留下来。这实际上划定了自动张量化中“什么可以重构、什么不能改变”的边界。
自动张量化,不是一次生成就结束
EvoCoCo没有让一个Agent从头到尾完成代码转换,而是把任务拆成理解、张量化、验证与选择三个阶段。对源算法的理解只需形成一次共享表示,后续多个张量化候选都在同一份语义表示和蓝图下生成,从而把“理解算法”和“生成实现”分开。
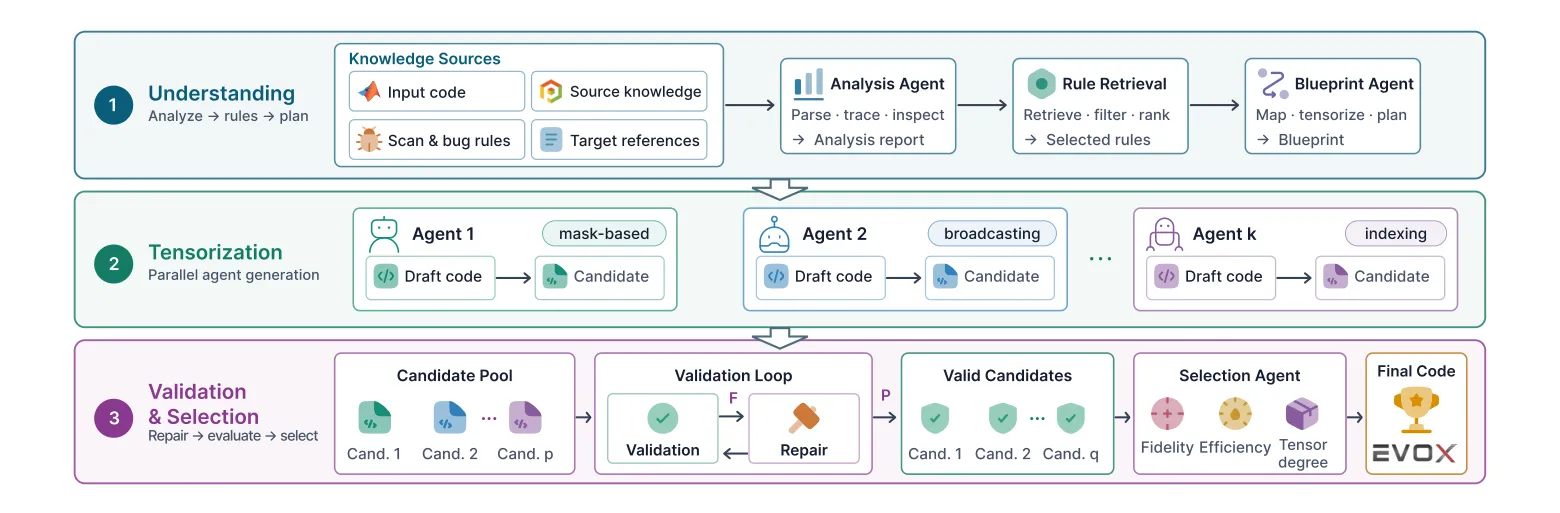
图1:EvoCoCo的多Agent架构。Source Analysis Agent重建算法语义,Rule Retriever检索迁移规则,Blueprint Agent生成张量化蓝图;多个Tensorization Agent在共享约束下并行生成候选,执行反馈驱动修复,Selection Agent完成最终选择。
第一步:理解。Source Analysis Agent先从源代码中重建算法语义,识别核心算子、持久状态、依赖关系和更新逻辑;Rule Retriever根据算法结构检索相关迁移规则;Blueprint Agent进一步生成共享的张量化蓝图,规定状态如何映射、计算如何重构,以及目标框架需要满足哪些约束。
第二步:张量化。k个Tensorization Agent在同一份蓝图下并行生成候选,分别侧重广播、einsum优化、掩码操作、原地更新、高级张量算子和迭代选择张量化等。它们探索的是同一算法的不同计算实现,而不是各自重新理解一遍源代码。
第三步:验证与选择。候选程序先经过静态检查和运行验证。执行中暴露出的接口、张量形状、设备、数值或控制流问题会反馈给Repair Agent继续修复;通过验证的候选再综合优化结果、运行时间和张量化程度,由Selection Agent选出最终实现。
EvoCoCo的关键就在这里,对源算法的理解是共享的,但GPU上的代码实现可以是多样的。
让代码转换在反馈中收敛
一次性翻译的问题在于,语义理解、框架适配和张量化设计都被压进一次生成中。某个环节判断错误,问题往往直到真正运行时才会暴露,而且缺少继续诊断和修复的机制。
EvoCoCo则把执行本身纳入转换过程。候选程序先在目标环境中运行,接口、张量形状、数值行为和状态更新等问题会转化为具体反馈,再用于修复候选。多个张量化分支也提供了不同的实现路径。代码生成由此从“一次猜中”,变成“生成—执行—修复—选择”的闭环。
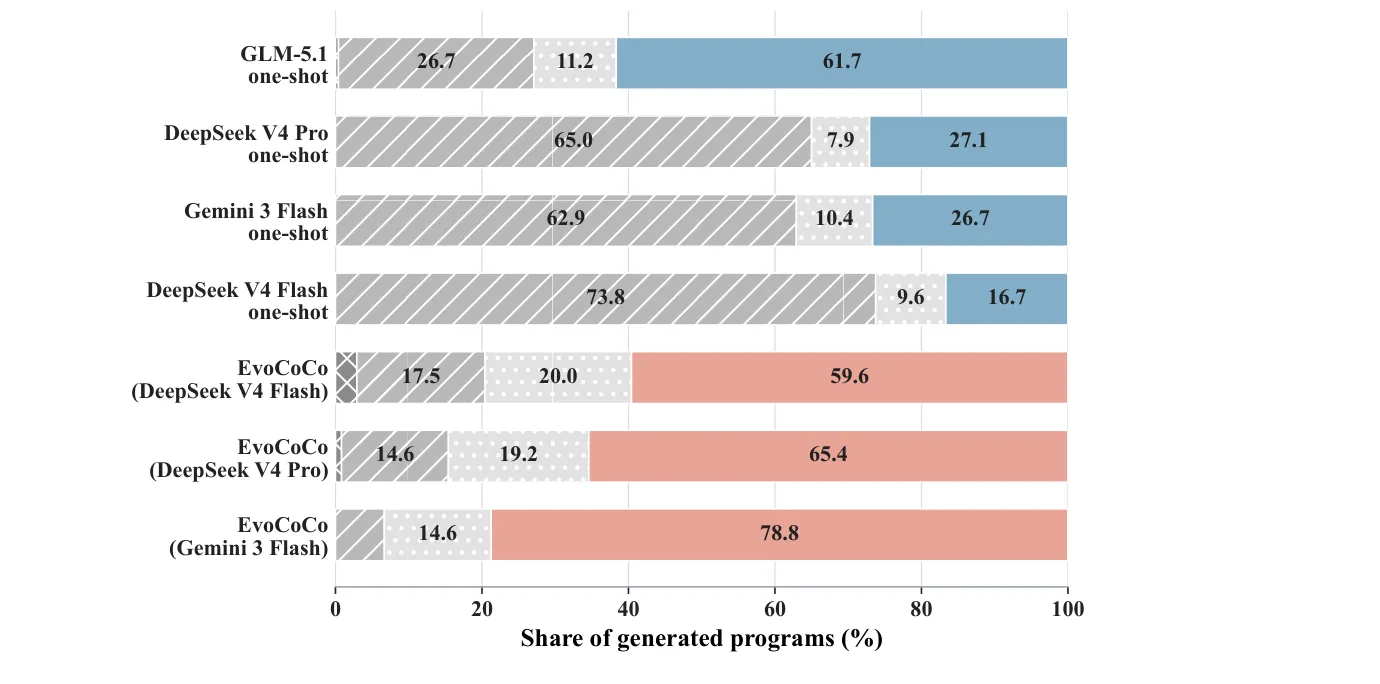
图2:每个条件240次独立转换尝试的阶段分布。三组匹配后端中,一次性翻译的执行失败占62.9%–73.8%,EvoCoCo降至6.7%–17.5%,更多候选能够进入后续优化评估。
这种失败位置的变化说明,反馈闭环的作用不只是“修 bug”,而是让目标环境参与判断哪一种张量化实现真正可用。一次性翻译的大量结果止步于执行阶段,而EvoCoCo通过实际运行获得诊断信息,再据此修复和筛选候选,使更多实现能够继续进入优化层面的评估。
代码能跑,只是迁移的第一关
EvoCoCo的实验主要回答三个问题:自动迁移能否稳定完成,迁移后的算法能否保持可接受的优化表现,以及张量化之后能否真正释放GPU并行能力。评估分别从迁移可靠性、优化保真度和计算扩展性三个方面展开。
1. 迁移可靠性
在匹配模型后端的比较中,每个条件包含240次独立转换尝试。EvoCoCo (Gemini 3 Flash) 的执行通过率达到93.33%,收敛通过率达到78.75%,48个基准算法全部至少得到一个收敛实现。相比同后端的一次性翻译,收敛通过率提高52.08个百分点;相比所有一次性翻译条件中表现最好的GLM-5.1,也高出17.08个百分点。
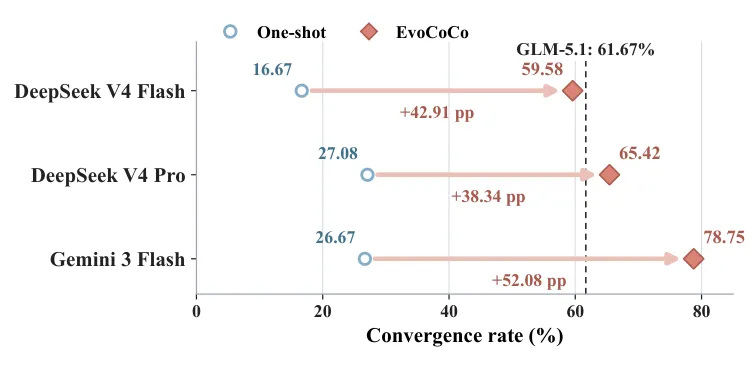
图3:三组匹配后端比较中,EvoCoCo相对一次性翻译均提高了收敛通过率。虚线表示表现最好的一次性翻译基线GLM-5.1。
2. 优化保真度
演化算法具有随机性,因此不能仅靠一次运行的逐元素输出判断迁移是否保留了原有优化行为。评估采用独立重复运行,在相同问题设置下比较PlatEMO与EvoX实现的最终IGD表现。DTLZ、WFG、LSMOP和MaF四个测试套件共得到1,904个有效比较,其中1,680个达到预设保真度标准,整体覆盖率为88.2%。四个测试套件的覆盖率均超过80%,其中WFG达到96.5%;48个算法中有41个的算法级覆盖率达到80%以上。
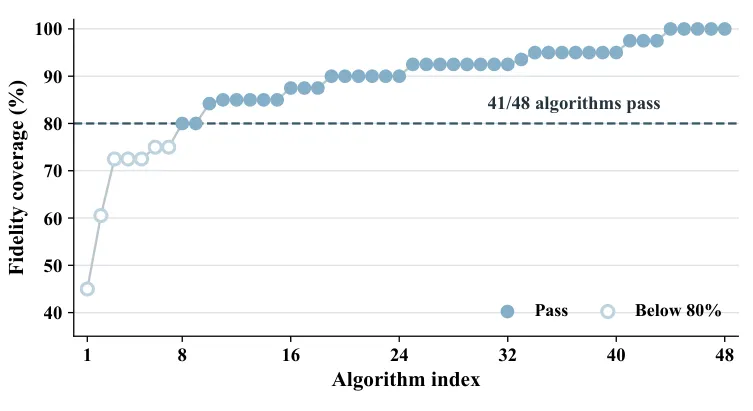
图4:48个张量化算法的优化保真度覆盖率。41个算法达到 80%阈值。
3. 计算扩展性
在有效的CPU–GPU对比中,种群规模扩展的中位加速为22.6×,决策变量维度扩展的中位加速为80.2×。随着问题规模继续扩大,GPU实现的运行优势总体上进一步增加。
| 扩展方向 | 有效比较 | 中位加速 | 几何平均 | 四分位区间 |
|---|---|---|---|---|
| 种群规模 | 289 | 22.6× | 29.9× | 4.5–163.5× |
| 决策维度 | 276 | 80.2× | 71.5× | 8.4–404.9× |
不同算法的加速幅度差异很大,但总体趋势较为明确:随着种群规模或决策维度增加,语义引导的张量化能够逐步释放原本隐藏在CPU程序结构中的群体级并行性。代表性算法的运行时间曲线进一步展示了这种扩展优势。
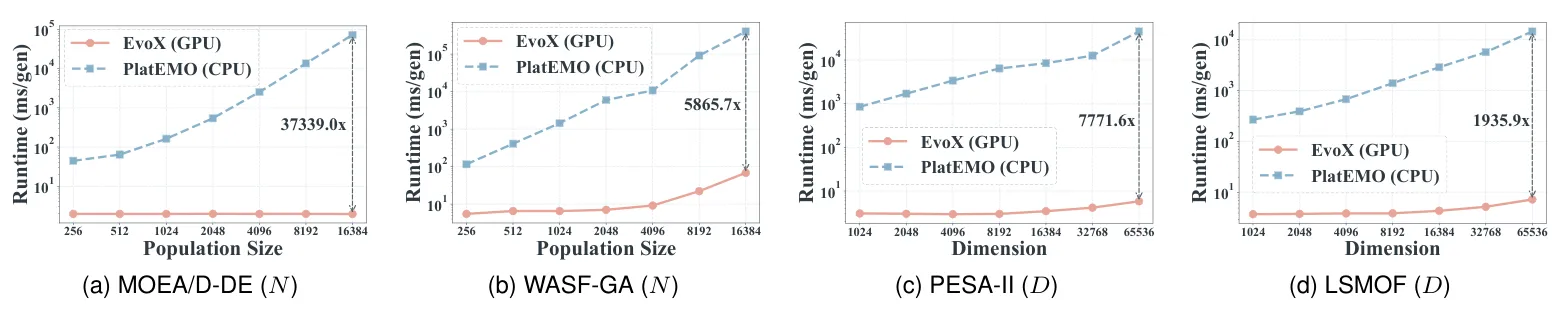
图5:(a)(b)为种群规模扩展,(c)(d)为决策维度扩展。图中标注最大测试规模下的加速比,其中MOEA/D-DE在 N = 16,384时达到37,339×。
除了三项核心评估,研究还通过组件消融和外部来源迁移进一步检验了EvoCoCo的关键机制与迁移能力。在12个算法构成的诊断子集上,完整EvoCoCo的执行通过率为98.3%、收敛通过率为83.3%;去掉Repair Agent后,两项指标分别降至60.0%和41.7%,改为单分支生成后则降至68.3%和40.0%,表明执行反馈与多分支生成对迁移可靠性尤为重要。与此同时,在PlatEMO之外的10个外部及遗留MATLAB/Octave实现上,EvoCoCo的执行通过率达到96%、收敛通过率达到62%,9个算法至少得到一个收敛实现。一次性翻译对应为34%、18%和2个,说明这套分阶段自动张量化流程能够适应不同来源和代码风格,但优化有效性仍是更难的一关。
代码会变,算法不该变
从MATLAB到PyTorch,从CPU到GPU,改变的是语言、数据结构和执行方式,不该被改变的是算法的核心机制。
EvoCoCo更值得关注的,是它改变了代码迁移所关注的问题。它把“如何复现这些语句”,转向了“哪些东西必须被保留下来”。当计算平台发生变化,好的迁移不必拘泥于原来的程序形态,而应该允许计算被重新组织,只要那些定义算法的关系仍然成立。
程序语言只是算法的一种表达,硬件也只是计算的一种载体。真正需要跨越语言与硬件迁移的,不是代码的形式,而是计算背后的结构。
开源与社区
论文:https://arxiv.org/abs/2609.02387
代码仓库:https://github.com/EMI-Group/evococo
上游项目(EvoX):https://github.com/EMI-Group/evox
QQ 交流群: 297969717
QQ交流群|演化机器智能