
MATLABで実装された多目的進化アルゴリズム(MOEA)を、そのまま大規模言語モデルに渡して、GPU高速化されたプログラムへ自動的に書き換えられるでしょうか。一見すると、これはMATLABをPyTorchに置き換え、配列をテンソルに、ループをバッチ化された操作に変えるだけのことに見えます。しかし、本当に難しいのはアルゴリズムの意味論にあります。どの計算が並列実行でき、どの計算に崩せない順序依存があるのか。どの変数が一時的なもので、どの変数が世代をまたいで状態を保持するのか。この区別を誤ると、変換後のコードは動作していても、実装しているのは別のアルゴリズムである可能性があります。
EvoXチームは、意味ガイド型自動テンソル化のためのマルチエージェントフレームワーク、EvoCoCo(Evolutionary Code Conversion)を提案します。まずソースアルゴリズムを理解し、次にさまざまなテンソル化実装を探索し、最後に実行フィードバックを使って候補を検証・修復・選択します。EvoCoCoは48のMOEAを対象に、移行信頼性、最適化忠実度、計算スケーラビリティの3つの観点から評価されました。全体の最適化忠実度カバレッジは88.2%に達しました。集団サイズをスケールさせた場合の加速比の中央値は22.6×、決定変数の次元をスケールさせた場合の中央値は80.2×でした。さらに大規模な設定では、代表的なアルゴリズムMOEA/D-DEが37,339×の加速比を達成しています。
GPUへの移行で本当に難しいのは、構文ではなくアルゴリズムの意味論
MOEAは本質的に高い集団レベルの並列性を持ちます。目的評価、変異、ソート、環境選択、アーカイブ操作は、しばしば候補解のバッチや集団内の関係をまとめて処理するため、GPU上のテンソル計算による並列実行と高い親和性を持ちます。
しかし、アルゴリズムが並列性を持っていても、既存の実装がそのままGPU実行に適しているわけではありません。たとえばPlatEMOでは、MATLABコードの中にベクトル化された操作と、個体レベルのループ、動的コンテナ、条件分岐、反復的な非支配フロントの抽出、オブジェクトのスライシング、各種ヘルパー関数が混在しています。このコードをGPUに移すには、データ表現、制御フロー、状態更新を再編成する必要があり、単なる構文の置き換えでは済みません。
難しいのは、元のアルゴリズムを定義している構造がどれかを見極めることです。
- どの変数が、世代をまたいで保持されるアルゴリズム状態を表しているか?
- どの計算が、ブロードキャスト、マスク、バッチインデックス参照を使って書き換えられるか?
- どのループが本物の順序依存を含んでおり、保存しなければならないか?
- どの状態と更新関係を変えると、最適化のメカニズムそのものが変わってしまうか?
EvoCoCoが取り組むのはまさにこの問題です。変換に際して、データレイアウト、制御フロー、実行戦略は変更できますが、アルゴリズムの中核となる演算子、永続状態、依存関係、更新ロジックは保持されます。これにより、自動テンソル化において「再構成してよいもの」と「保持しなければならないもの」の境界が定まります。
自動テンソル化は、一回の生成では終わらない
EvoCoCoはコード変換を、理解、テンソル化、検証と選択という3つの段階に分けます。変換全体を最初から最後まで単一のエージェントが担うことはありません。ソースアルゴリズムは一度だけ解析され、共有される意味表現が生成されます。その後のテンソル化候補は、その同じ意味表現と設計図(ブループリント)から生成されるため、アルゴリズムの理解と実装の生成が分離されます。
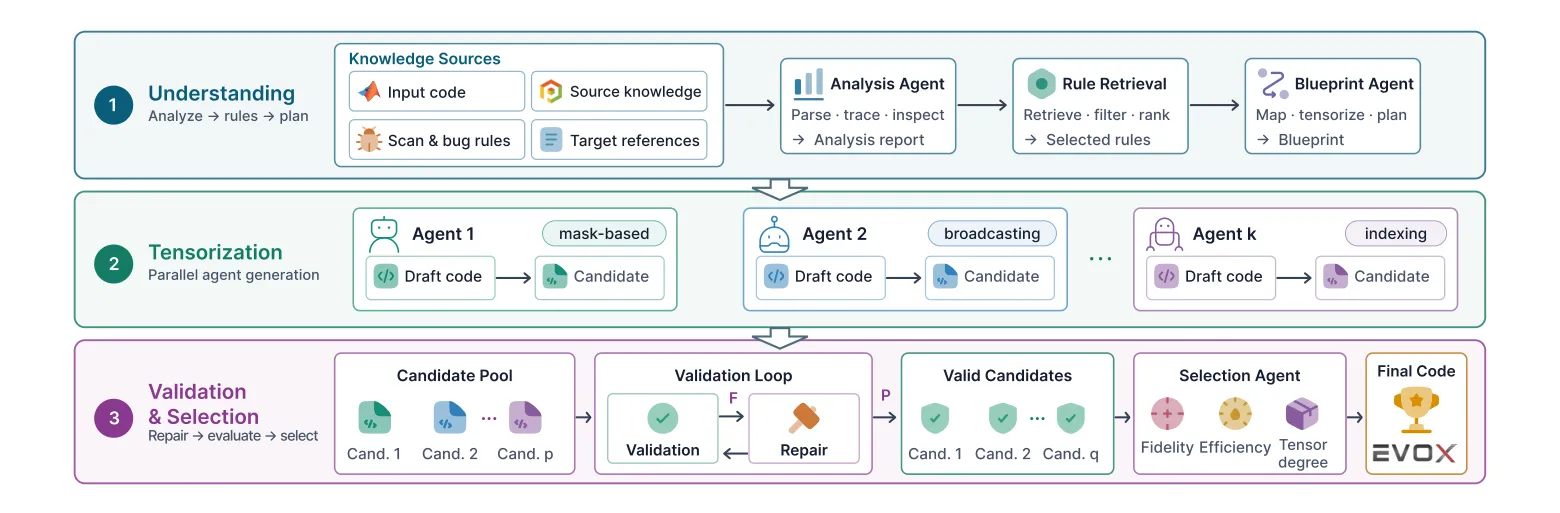
図1:EvoCoCoのマルチエージェントアーキテクチャ。Source Analysis Agentがアルゴリズムの意味論を再構成し、Rule Retrieverが移行ルールを検索し、Blueprint Agentがテンソル化の設計図を作成します。複数のTensorization Agentが共有制約の下で並列に候補を生成し、実行フィードバックが修復を駆動し、Selection Agentが最終選択を行います。
ステップ1:理解。Source Analysis Agentがソースアルゴリズムの意味論を再構成し、中核となる演算子、永続状態、依存関係、更新ロジックを特定します。Rule Retrieverがアルゴリズムの構造に基づいて関連する移行ルールを検索します。そしてBlueprint Agentが、状態をどうマップし、計算をどう再構成し、ターゲットフレームワークがどの制約を満たすべきかを規定した、共有テンソル化設計図を作成します。
ステップ2:テンソル化。同じ設計図の下で、k個のTensorization Agentが並列に候補を生成します。それぞれが、ブロードキャスト、einsumによる最適化、マスク操作、インプレース更新、高度なテンソル演算子、反復選択のテンソル化などに異なる重点を置きます。それらはソースコードの共有された理解の下で同じアルゴリズムの異なる計算実装を探索するのであり、各自がソースコードを独立に再解釈するわけではありません。
ステップ3:検証と選択。候補プログラムは静的チェックと実行時検証を受けます。実行中に明らかになったインターフェース、テンソル形状、デバイス、数値、制御フローの問題は、Repair Agentにフィードバックされてさらに修復されます。検証を通過した候補の中から、Selection Agentが最適化結果、実行時間、テンソル化の程度を考慮して最終実装を選択します。
鍵となる考え方は、ソースアルゴリズムの理解を共有しながら、GPU上の実装の多様性を許すことです。
実行フィードバックが変換プロセスを収束させる
一回きりの翻訳では、意味論の理解、フレームワークへの適合、テンソル化の設計がすべて一度の生成に圧縮されます。どこかで判断を誤っても、それはプログラムが実際に動くときにしか現れず、それ以上診断して修復する仕組みもありません。
EvoCoCoは変換プロセスの中に実行そのものを組み込みます。候補プログラムはターゲット環境で実行され、インターフェース、テンソル形状、数値の振る舞い、状態更新の問題が、候補を修復するための具体的なフィードバックになります。複数のテンソル化ブランチも、異なる実装の道筋を提供します。コード生成は、生成・実行・修復・選択の閉ループになります。
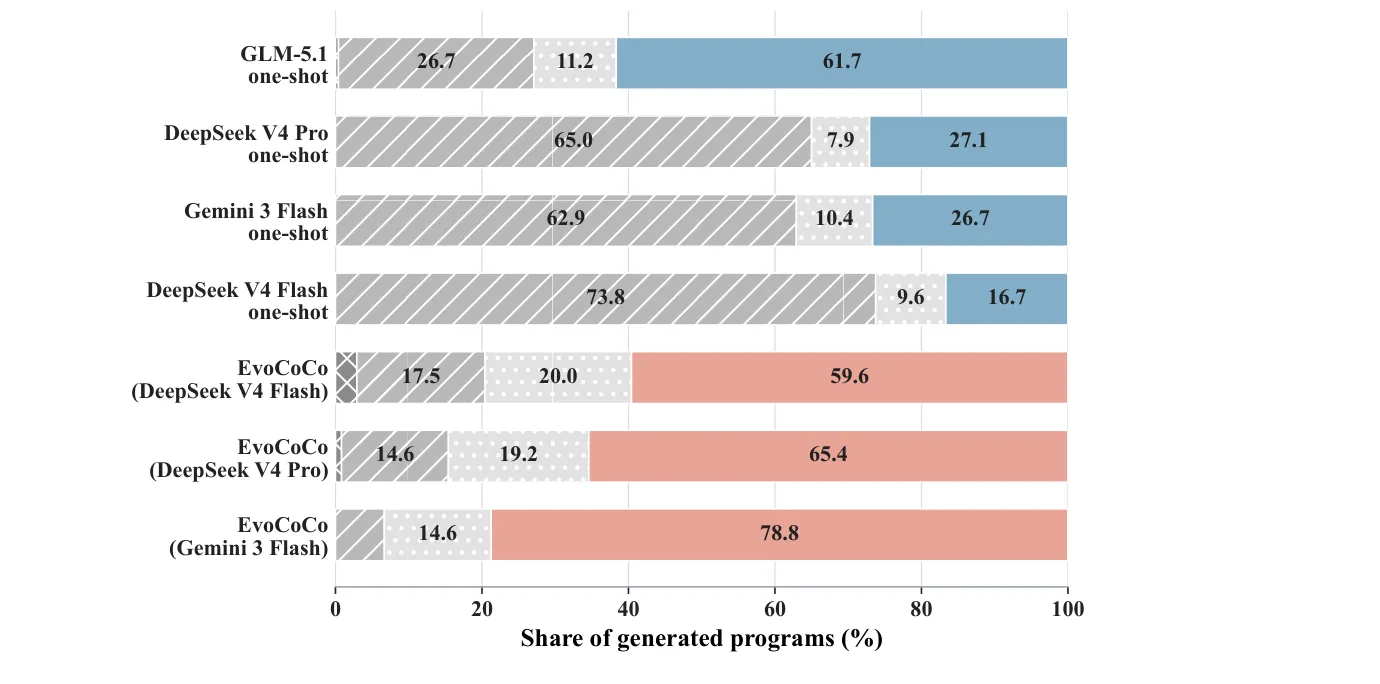
図2:各条件240回の独立した変換試行における段階別の結果。バックエンドを揃えた3組の比較において、一回きり翻訳では実行失敗が62.9%–73.8%を占めたのに対し、EvoCoCoでは6.7%–17.5%でした。より多くの候補が最適化評価に進めるようになりました。
失敗がどこで起きるかのこの変化は、フィードバックループが単なるバグ修正以上の働きをすることを示しています。ターゲット環境そのものが、どのテンソル化実装が実際に使えるかの判断に参加するようになるのです。一回きり翻訳の結果の多くは実行段階で止まりますが、EvoCoCoは実際の実行を通じて診断情報を得て、候補を修復・フィルタリングすることで、より多くの実装が最適化挙動の評価へ進めるようにします。
正常に実行できることは、移行の第一関門にすぎない
EvoCoCoの実験は3つの問いに答えます。自動変換を確実に完了できるか、変換されたアルゴリズムが許容できる最適化性能を保っているか、テンソル化がGPU並列性を解放できるか。評価は、移行信頼性、最適化忠実度、計算スケーラビリティの3軸で行われました。
1. 移行信頼性
バックエンドを揃えた比較では、各条件で240回の独立した変換試行を行いました。EvoCoCo(Gemini 3 Flash)は93.33%の実行成功率と78.75%の収束成功率を達成しました。48のベンチマークアルゴリズムすべてについて、EvoCoCoは収束検証を通過した実装を少なくとも1つ生成しました。収束成功率は、同じバックエンドの一回きり翻訳より52.08パーセントポイント高く、すべての一回きり翻訳条件の中で最良だったGLM-5.1よりも17.08パーセントポイント高い結果でした。
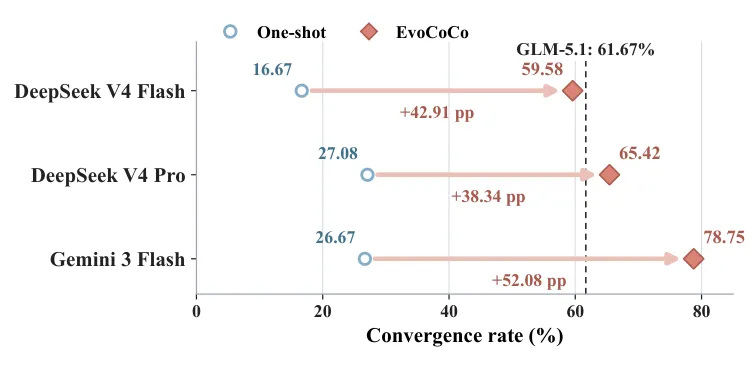
図3:バックエンドを揃えた3組の比較すべてにおいて、EvoCoCoは一回きり翻訳を上回る収束成功率を達成しました。破線は最も強い一回きり翻訳ベースラインであるGLM-5.1を表します。
2. 最適化忠実度
進化アルゴリズムは確率的であるため、単一実行の出力を要素ごとに比較しても、変換が最適化挙動を保存しているかは判断できません。評価では独立な反復実行を行い、同一の問題設定の下でPlatEMO実装とEvoX実装の最終IGD(inverted generational distance)を比較しました。DTLZ、WFG、LSMOP、MaFの各テストスイートで合計1,904件の有効な比較が得られ、うち1,680件が事前に定義した忠実度基準を満たし、全体のカバレッジは88.2%でした。4つのスイートすべてでカバレッジは80%を超え、WFGでは96.5%に達しました。48アルゴリズムのうち41が、アルゴリズムレベルで80%以上のカバレッジを達成しています。
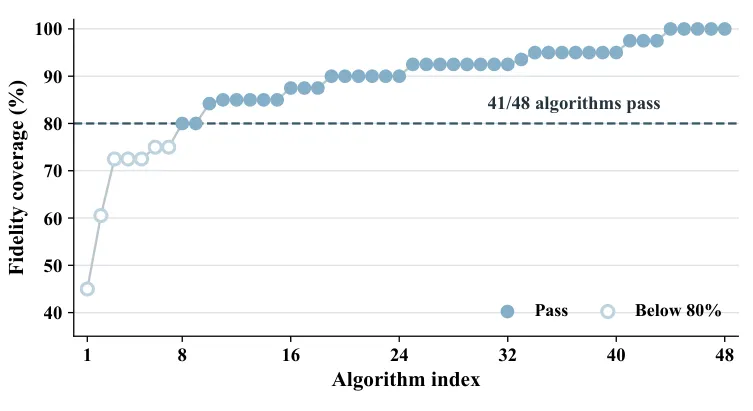
図4:テンソル化された48のアルゴリズムの最適化忠実度カバレッジ。41のアルゴリズムが80%のしきい値に達しました。
3. 計算スケーラビリティ
有効なCPU–GPU比較全体では、集団サイズをスケールさせた場合の加速比の中央値は22.6×、決定変数の次元をスケールさせた場合の中央値は80.2×でした。問題規模がさらに大きくなると、GPU実装の実行時間上の優位は一般にさらに拡大しました。
| 拡張軸 | 有効な比較数 | 中央値の加速比 | 幾何平均の加速比 | 四分位範囲 |
|---|---|---|---|---|
| 集団サイズ | 289 | 22.6× | 29.9× | 4.5–163.5× |
| 決定変数の次元 | 276 | 80.2× | 71.5× | 8.4–404.9× |
加速の大きさはアルゴリズムによって大きく異なりますが、全体の傾向は明確です。集団サイズまたは決定変数の次元が大きくなるにつれ、意味ガイド型テンソル化は、CPUプログラムの構造の中に隠れていた集団レベルの並列性を段階的に解放します。代表的なアルゴリズムの実行時間曲線が、このスケーリング上の優位をさらに示しています。
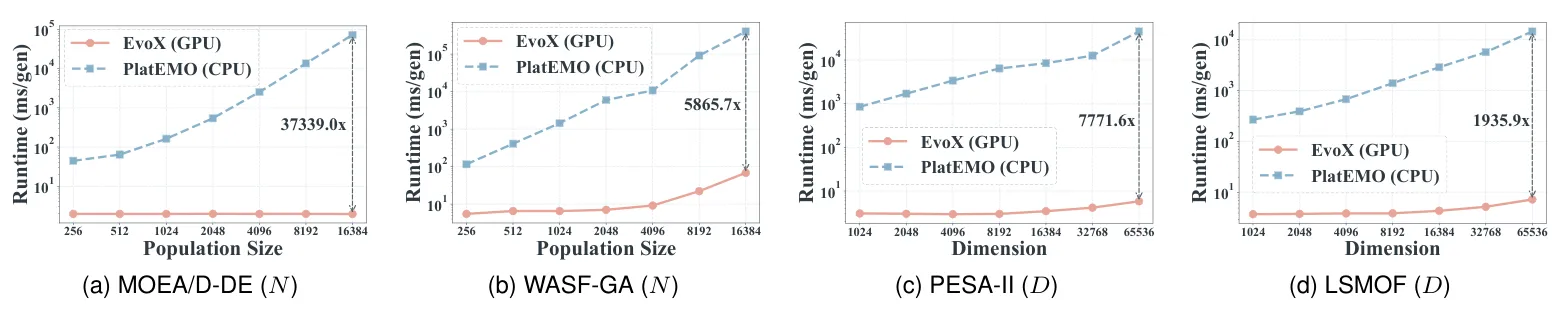
図5:(a)(b)は集団サイズのスケーリング、(c)(d)は決定変数の次元のスケーリング。注釈は最大テスト規模での加速比を示し、MOEA/D-DEはN = 16,384で37,339×に達しました。
3つの中核評価に加えて、コンポーネントのアブレーションと外部ソースからの変換により、EvoCoCoの主要メカニズムと変換能力がさらに検証されました。12のアルゴリズムからなる診断用サブセットでは、完全なEvoCoCoフレームワークの実行成功率と収束成功率はそれぞれ98.3%と83.3%でした。Repair Agentを取り除くとこれらは60.0%と41.7%に低下し、単一の生成分枝にすると68.3%と40.0%に低下しました。この結果は、実行フィードバックと複数分枝生成が移行信頼性にとって特に重要であることを示しています。また、PlatEMO以外の10の外部およびレガシーなMATLAB/Octave実装に対しては、EvoCoCoは96%の実行成功率と62%の収束成功率を達成し、9つのアルゴリズムが収束検証を通過した実装を少なくとも1つ得ました。一回きり翻訳の対応する結果は34%、18%、2アルゴリズムでした。これは、段階的な自動テンソル化のプロセスが異なるコードソースやスタイルに対応できる一方で、最適化の有効性は依然として難しい試練であることを示しています。
コードは変わっても、アルゴリズムは変わらない
MATLABからPyTorchへ、CPUからGPUへの移行は、言語、データ構造、実行戦略を変えます。しかし、アルゴリズムの中核メカニズムは損なわれるべきではありません。
EvoCoCoが重要なのは、コード変換の見方そのものを変えた点でもあります。これは「文を再現する」ことから「何を保存すべきかを見極める」ことへと焦点を移します。計算プラットフォームが変わるとき、成功した変換は元のプログラム構造を再現する必要はなく、アルゴリズムを定義する関係が保たれる限り、計算の再編成を許すべきです。
プログラミング言語はアルゴリズムの一つの表現であり、ハードウェアは計算の一つの担い手です。言語とハードウェアをまたいで移行すべきなのは、コードの形式ではなく、その計算の背後にある構造です。
オープンソースとコミュニティ
論文:https://arxiv.org/abs/2609.02387
GitHub:https://github.com/EMI-Group/evococo
上流プロジェクト(EvoX):https://github.com/EMI-Group/evox
QQグループ:297969717
QQグループ|Evolutionary Machine Intelligence