
一份MATLAB實現的多目標最佳化演算法 (MOEA),能不能直接交給大模型,自動改寫成能在GPU加速的程式?表面看,這只是把MATLAB換成PyTorch、陣列換成張量、迴圈改成批次操作。但真正困難的不是語法,而是演算法語義。哪些計算可以並行,哪些存在不可打亂的順序依賴;哪些只是中間變數,哪些構成跨代狀態。判斷錯了,程式碼即使能跑,也可能已經不是原來的演算法。
EvoX團隊提出EvoCoCo (Evolutionary Code Conversion),以語義引導的方式完成自動張量化:先理解源演算法,再探索不同的張量化實現,最後透過執行反饋進行驗證、修復與選擇。EvoCoCo在48個MOEAs上驗證了這一路線,並從遷移可靠性、最佳化保真度與計算擴充套件性三個方面進行評估。整體最佳化保真度覆蓋率達到88.2%,種群規模與決策維度擴充套件的中位加速比分別為22.6×和80.2×。在更大規模下,代表性演算法MOEA/D-DE的加速比達到37339×。
GPU上真正難搬的,不是語法
MOEAs本身具有很強的群體級並行性。目標評估、變異、排序、環境選擇和檔案操作,往往都需要同時處理一批候選解或種群關係,天然適合透過張量計算在GPU上並行執行。
但演算法本身具備並行性,並不意味著現有實現已經適合GPU執行。以PlatEMO為例,MATLAB程式碼中既有向量化操作,也混合著個體級迴圈、動態容器、條件分支、迭代式前沿提取、物件切片以及各種輔助函式。真正要遷移到GPU,必須重新組織資料表示、控制流程和狀態更新,而不是簡單替換語法。
因此,難點在於判斷哪些結構定義了原演算法本身:
- 哪些變數是跨代保留的演算法狀態?
- 哪些計算可以改寫為廣播、掩碼或批次索引?
- 哪些迴圈包含真正的順序依賴,必須保留下來?
- 哪些狀態和更新關係一旦改變,就會改變演算法的最佳化機制?
EvoCoCo要解決的正是這個問題。遷移時可以改變資料佈局、控制流程和執行方式,但演算法的核心運算元、持久狀態、依賴關係與更新邏輯必須保留下來。這實際上劃定了自動張量化中“什麼可以重構、什麼不能改變”的邊界。
自動張量化,不是一次生成就結束
EvoCoCo沒有讓一個Agent從頭到尾完成程式碼轉換,而是把任務拆成理解、張量化、驗證與選擇三個階段。對源演算法的理解只需形成一次共享表示,後續多個張量化候選都在同一份語義表示和藍圖下生成,從而把“理解演算法”和“生成實現”分開。
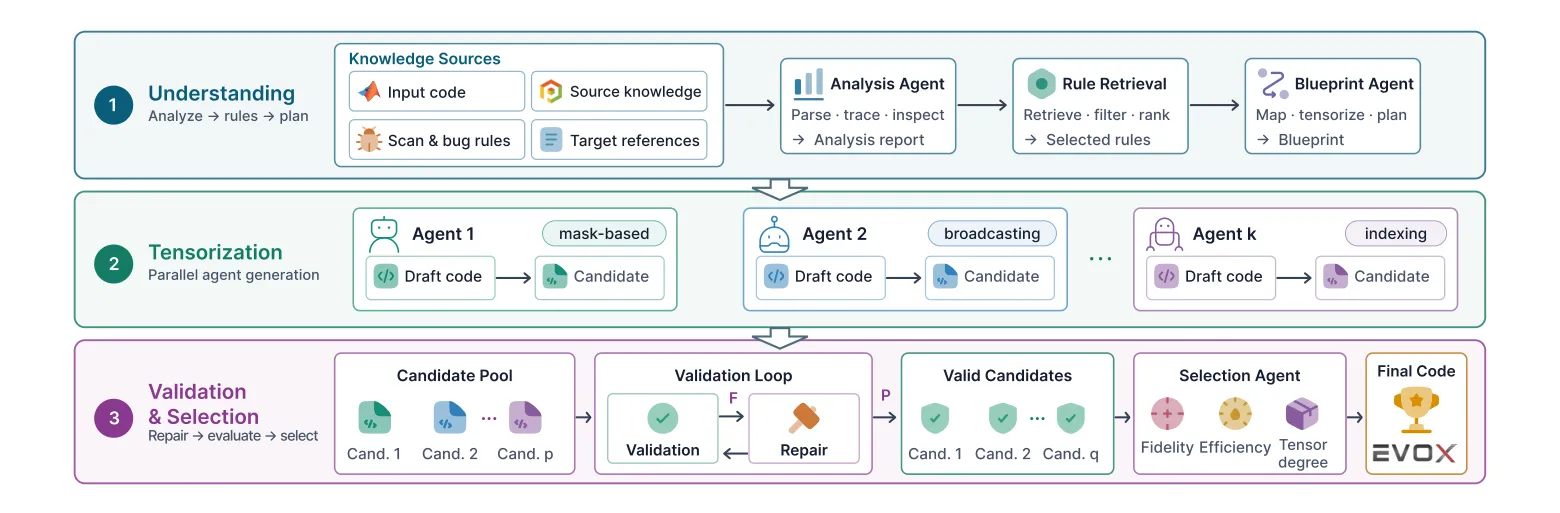
圖1:EvoCoCo的多Agent架構。Source Analysis Agent重建演算法語義,Rule Retriever檢索遷移規則,Blueprint Agent生成張量化藍圖;多個Tensorization Agent在共享約束下並行生成候選,執行反饋驅動修復,Selection Agent完成最終選擇。
第一步:理解。Source Analysis Agent先從原始碼中重建演算法語義,識別核心運算元、持久狀態、依賴關係和更新邏輯;Rule Retriever根據演算法結構檢索相關遷移規則;Blueprint Agent進一步生成共享的張量化藍圖,規定狀態如何對映、計算如何重構,以及目標框架需要滿足哪些約束。
第二步:張量化。k個Tensorization Agent在同一份藍圖下並行生成候選,分別側重廣播、einsum最佳化、掩碼操作、原地更新、高階張量運算元和迭代選擇張量化等。它們探索的是同一演算法的不同計算實現,而不是各自重新理解一遍原始碼。
第三步:驗證與選擇。候選程式先經過靜態檢查和執行驗證。執行中暴露出的介面、張量形狀、裝置、數值或控制流問題會反饋給Repair Agent繼續修復;透過驗證的候選再綜合最佳化結果、執行時間和張量化程度,由Selection Agent選出最終實現。
EvoCoCo的關鍵就在這裡,對源演算法的理解是共享的,但GPU上的程式碼實現可以是多樣的。
讓程式碼轉換在反饋中收斂
一次性翻譯的問題在於,語義理解、框架適配和張量化設計都被壓進一次生成中。某個環節判斷錯誤,問題往往直到真正執行時才會暴露,而且缺少繼續診斷和修復的機制。
EvoCoCo則把執行本身納入轉換過程。候選程式先在目標環境中執行,介面、張量形狀、數值行為和狀態更新等問題會轉化為具體反饋,再用於修復候選。多個張量化分支也提供了不同的實現路徑。程式碼生成由此從“一次猜中”,變成“生成—執行—修復—選擇”的閉環。
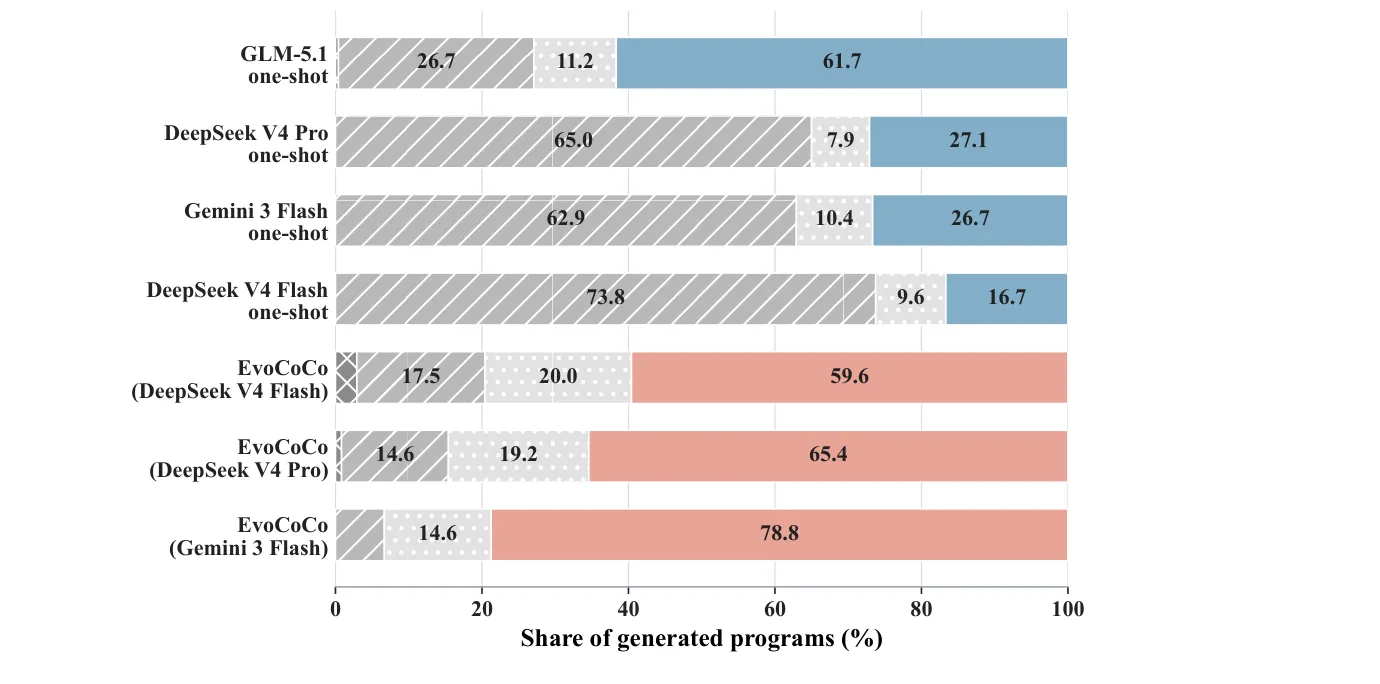
圖2:每個條件240次獨立轉換嘗試的階段分佈。三組匹配後端中,一次性翻譯的執行失敗佔62.9%–73.8%,EvoCoCo降至6.7%–17.5%,更多候選能夠進入後續最佳化評估。
這種失敗位置的變化說明,反饋閉環的作用不只是“修 bug”,而是讓目標環境參與判斷哪一種張量化實現真正可用。一次性翻譯的大量結果止步於執行階段,而EvoCoCo透過實際執行獲得診斷資訊,再據此修復和篩選候選,使更多實現能夠繼續進入最佳化層面的評估。
程式碼能跑,只是遷移的第一關
EvoCoCo的實驗主要回答三個問題:自動遷移能否穩定完成,遷移後的演算法能否保持可接受的最佳化表現,以及張量化之後能否真正釋放GPU並行能力。評估分別從遷移可靠性、最佳化保真度和計算擴充套件性三個方面展開。
1. 遷移可靠性
在匹配模型後端的比較中,每個條件包含240次獨立轉換嘗試。EvoCoCo (Gemini 3 Flash) 的執行透過率達到93.33%,收斂透過率達到78.75%,48個基準演算法全部至少得到一個收斂實現。相比同後端的一次性翻譯,收斂透過率提高52.08個百分點;相比所有一次性翻譯條件中表現最好的GLM-5.1,也高出17.08個百分點。
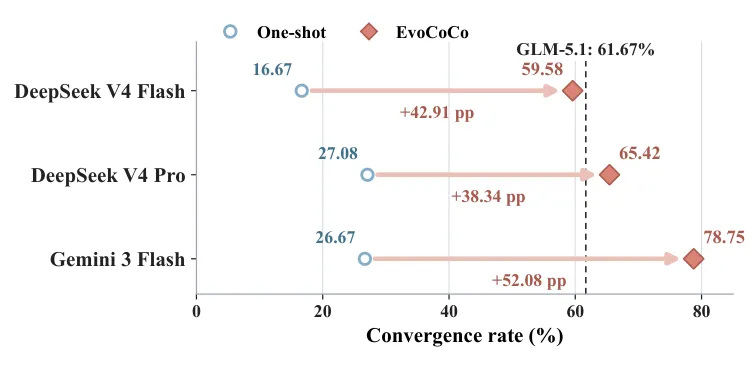
圖3:三組匹配後端比較中,EvoCoCo相對一次性翻譯均提高了收斂透過率。虛線表示表現最好的一次性翻譯基線GLM-5.1。
2. 最佳化保真度
演化演算法具有隨機性,因此不能僅靠一次執行的逐元素輸出判斷遷移是否保留了原有最佳化行為。評估採用獨立重複執行,在相同問題設定下比較PlatEMO與EvoX實現的最終IGD表現。DTLZ、WFG、LSMOP和MaF四個測試套件共得到1,904個有效比較,其中1,680個達到預設保真度標準,整體覆蓋率為88.2%。四個測試套件的覆蓋率均超過80%,其中WFG達到96.5%;48個演算法中有41個的演算法級覆蓋率達到80%以上。
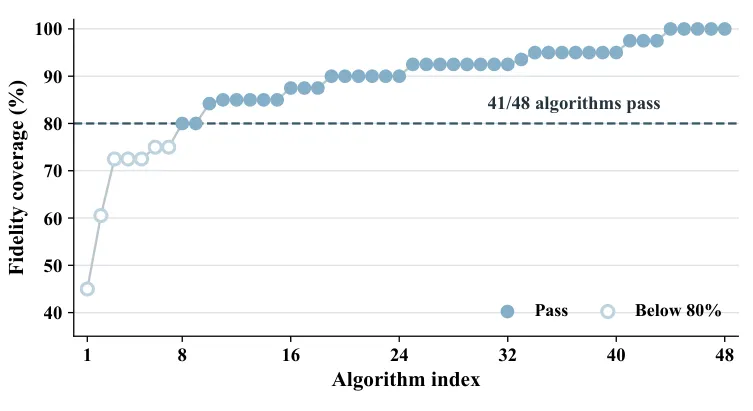
圖4:48個張量化演算法的最佳化保真度覆蓋率。41個演算法達到 80%閾值。
3. 計算擴充套件性
在有效的CPU–GPU對比中,種群規模擴充套件的中位加速為22.6×,決策變數維度擴充套件的中位加速為80.2×。隨著問題規模繼續擴大,GPU實現的執行優勢總體上進一步增加。
| 擴充套件方向 | 有效比較 | 中位加速 | 幾何平均 | 四分位區間 |
|---|---|---|---|---|
| 種群規模 | 289 | 22.6× | 29.9× | 4.5–163.5× |
| 決策維度 | 276 | 80.2× | 71.5× | 8.4–404.9× |
不同演算法的加速幅度差異很大,但總體趨勢較為明確:隨著種群規模或決策維度增加,語義引導的張量化能夠逐步釋放原本隱藏在CPU程式結構中的群體級並行性。代表性演算法的執行時間曲線進一步展示了這種擴充套件優勢。
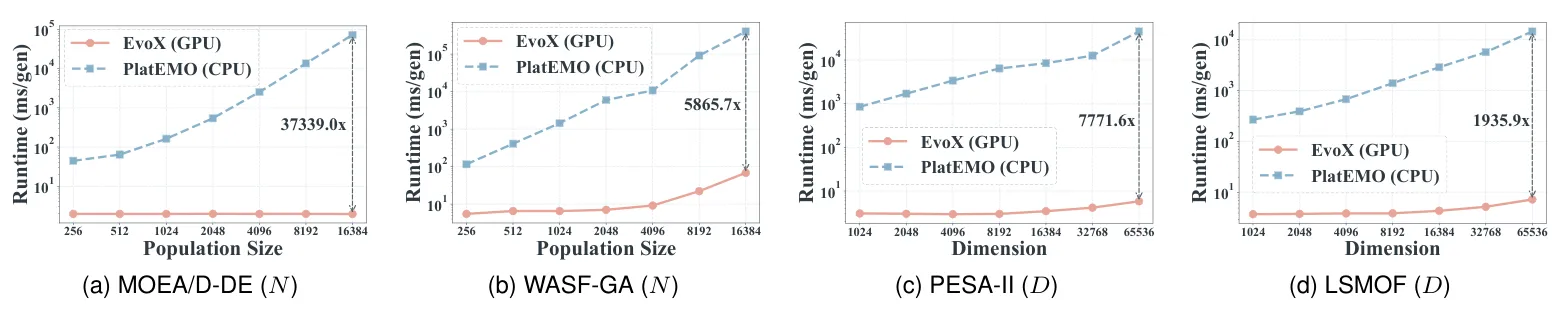
圖5:(a)(b)為種群規模擴充套件,(c)(d)為決策維度擴充套件。圖中標註最大測試規模下的加速比,其中MOEA/D-DE在 N = 16,384時達到37,339×。
除了三項核心評估,研究還透過元件消融和外部來源遷移進一步檢驗了EvoCoCo的關鍵機制與遷移能力。在12個演算法構成的診斷子集上,完整EvoCoCo的執行透過率為98.3%、收斂透過率為83.3%;去掉Repair Agent後,兩項指標分別降至60.0%和41.7%,改為單分支生成後則降至68.3%和40.0%,表明執行反饋與多分支生成對遷移可靠性尤為重要。與此同時,在PlatEMO之外的10個外部及遺留MATLAB/Octave實現上,EvoCoCo的執行透過率達到96%、收斂透過率達到62%,9個演算法至少得到一個收斂實現。一次性翻譯對應為34%、18%和2個,說明這套分階段自動張量化流程能夠適應不同來源和程式碼風格,但最佳化有效性仍是更難的一關。
程式碼會變,演算法不該變
從MATLAB到PyTorch,從CPU到GPU,改變的是語言、資料結構和執行方式,不該被改變的是演算法的核心機制。
EvoCoCo更值得關注的,是它改變了程式碼遷移所關注的問題。它把“如何復現這些語句”,轉向了“哪些東西必須被保留下來”。當計算平臺發生變化,好的遷移不必拘泥於原來的程式形態,而應該允許計算被重新組織,只要那些定義演算法的關係仍然成立。
程式語言只是演算法的一種表達,硬體也只是計算的一種載體。真正需要跨越語言與硬體遷移的,不是程式碼的形式,而是計算背後的結構。
開源與社群
論文:https://arxiv.org/abs/2609.02387
程式碼倉庫:https://github.com/EMI-Group/evococo
上游專案(EvoX):https://github.com/EMI-Group/evox
QQ 交流群: 297969717
QQ交流群|演化機器智慧