
¿Puede un algoritmo evolutivo multiobjetivo (MOEA) implementado en MATLAB entregarse directamente a un modelo de lenguaje de gran escala y reescribirse automáticamente como un programa acelerado por GPU? En apariencia, esto parece significar reemplazar MATLAB por PyTorch, los arreglos por tensores y los bucles por operaciones por lotes. La verdadera dificultad, sin embargo, reside en la semántica del algoritmo: qué cálculos pueden ejecutarse en paralelo, cuáles dependen de un orden que debe preservarse, qué variables son temporales y cuáles transportan estado entre generaciones. Si estas distinciones se equivocan, el código convertido puede ejecutarse y aun así implementar un algoritmo diferente.
El equipo de EvoX propone EvoCoCo (Evolutionary Code Conversion), un marco multiagente de tensorización automática guiada por semántica. Primero comprende el algoritmo fuente, luego explora distintas implementaciones tensorizadas y, por último, emplea la retroalimentación de ejecución para validar, reparar y seleccionar candidatos. EvoCoCo se evaluó en 48 MOEA según tres dimensiones: confiabilidad de la migración, fidelidad de optimización y escalabilidad computacional. La cobertura global de fidelidad de optimización alcanzó el 88.2%. Las aceleraciones medianas fueron de 22.6× al escalar el tamaño de la población y de 80.2× al escalar la dimensionalidad de las variables de decisión. A mayor escala, el algoritmo representativo MOEA/D-DE logró una aceleración de 37,339×.
Lo verdaderamente difícil de trasladar a las GPU no es la sintaxis
Los MOEA ofrecen un paralelismo sustancial a nivel de población. La evaluación de objetivos, la mutación, el ordenamiento, la selección ambiental y las operaciones de archivo suelen procesar lotes de soluciones candidatas o relaciones dentro de una población, lo que los hace idóneos para una ejecución paralela mediante cálculo tensorial en GPU.
Que un algoritmo presente paralelismo no significa que su implementación existente esté lista para ejecutarse en GPU. En PlatEMO, por ejemplo, el código MATLAB combina operaciones vectorizadas con bucles a nivel de individuo, contenedores dinámicos, bifurcaciones condicionales, extracción iterativa de frentes no dominados, segmentación de objetos y diversas funciones auxiliares. Trasladar este código a una GPU exige reorganizar las representaciones de datos, el flujo de control y las actualizaciones de estado. Esto va mucho más allá de sustituir sintaxis.
El reto consiste en identificar qué estructuras definen el algoritmo original:
- ¿Qué variables representan estado del algoritmo que persiste entre generaciones?
- ¿Qué cálculos pueden reescribirse mediante difusión (broadcasting), máscaras o indexación por lotes?
- ¿Qué bucles contienen dependencias secuenciales genuinas y deben conservarse?
- ¿Qué cambios en el estado y en las relaciones de actualización alterarían el mecanismo de optimización?
EvoCoCo aborda precisamente estas cuestiones. La conversión puede cambiar las disposiciones de datos, el flujo de control y las estrategias de ejecución, a la vez que preserva los operadores núcleo, el estado persistente, las dependencias y la lógica de actualización del algoritmo. Esto establece el límite entre lo que la tensorización automática puede reestructurar y lo que debe preservar.
La tensorización automática requiere más que una única generación de código
EvoCoCo divide la conversión de código en tres etapas: comprensión, tensorización, y validación y selección. Ningún agente único gestiona la conversión de principio a fin. El algoritmo fuente se analiza una sola vez para producir una representación semántica compartida. Los candidatos tensorizados posteriores se generan a partir de esa misma representación y plano. Así se separa la comprensión del algoritmo de la generación de implementaciones.
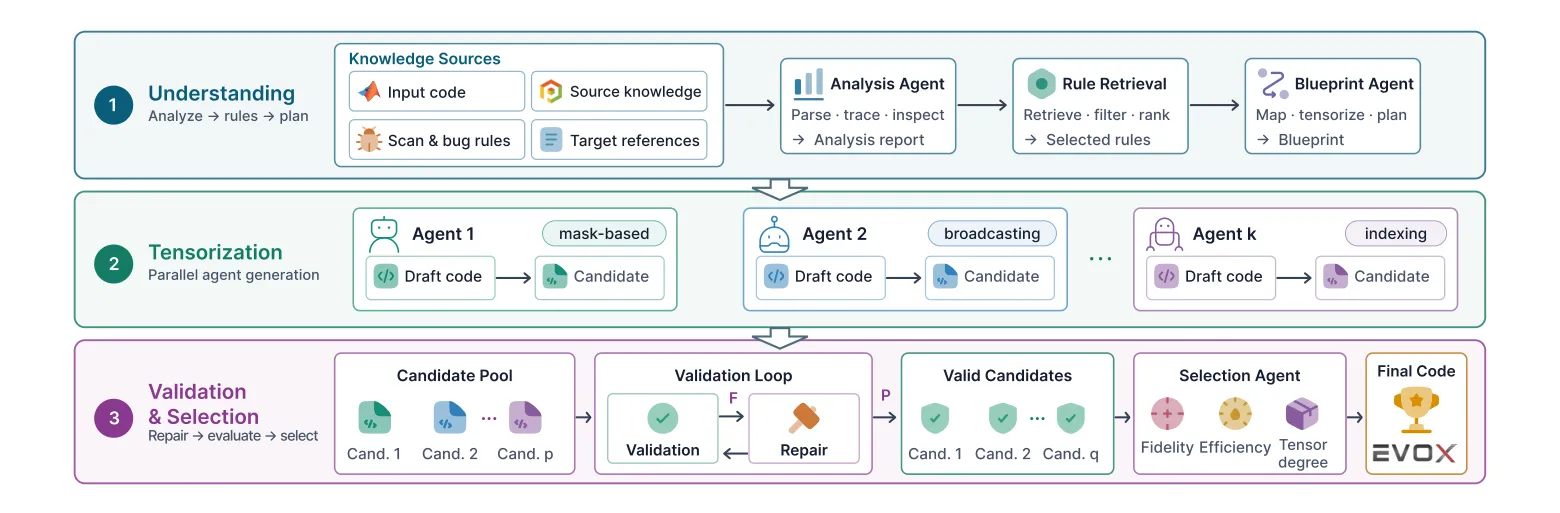
Figura 1. Arquitectura multiagente de EvoCoCo. El Source Analysis Agent reconstruye la semántica del algoritmo, el Rule Retriever recupera las reglas de migración y el Blueprint Agent crea un plano de tensorización. Varios Tensorization Agents generan candidatos en paralelo bajo restricciones compartidas. La retroalimentación de ejecución impulsa la reparación, y el Selection Agent realiza la selección final.
Etapa 1: comprensión. El Source Analysis Agent reconstruye la semántica del algoritmo fuente, identificando sus operadores núcleo, estado persistente, dependencias y lógica de actualización. El Rule Retriever recupera las reglas de migración pertinentes según la estructura del algoritmo. El Blueprint Agent crea entonces un plano de tensorización compartido que especifica cómo se mapea el estado, cómo se reestructura el cálculo y qué restricciones debe satisfacer el marco de destino.
Etapa 2: tensorización. Bajo el mismo plano, k Tensorization Agents generan candidatos en paralelo, con énfasis distintos en difusión, optimización con einsum, operaciones enmascaradas, actualizaciones in situ, operadores tensoriales avanzados y tensorización de la selección iterativa. Exploran distintas implementaciones computacionales del mismo algoritmo usando la comprensión compartida del código fuente; no reinterpretan cada uno el código fuente por su cuenta.
Etapa 3: validación y selección. Los programas candidatos se someten a comprobaciones estáticas y validación en ejecución. Los problemas de interfaz, forma de tensores, dispositivo, numéricos o de flujo de control que se revelan durante la ejecución se transmiten al Repair Agent para su reparación. Entre los candidatos que superan la validación, el Selection Agent elige la implementación definitiva considerando los resultados de optimización, el tiempo de ejecución y el grado de tensorización.
La idea clave es compartir la comprensión del algoritmo fuente mientras se permiten implementaciones GPU diversas.
La retroalimentación de ejecución hace converger el proceso de conversión
La traducción en un solo paso comprime la comprensión semántica, la adaptación al marco y el diseño de la tensorización en una única generación. Un error en cualquiera de estos ámbitos puede manifestarse solo cuando el programa se ejecuta realmente, sin mecanismo para un diagnóstico y reparación posteriores.
EvoCoCo incorpora la ejecución al proceso de conversión. Los programas candidatos se ejecutan en el entorno de destino; los problemas de interfaces, formas de tensores, comportamiento numérico y actualizaciones de estado se convierten en retroalimentación concreta para reparar los candidatos. Las múltiples ramas de tensorización ofrecen además rutas de implementación alternativas. La generación de código se convierte en un ciclo cerrado de generación, ejecución, reparación y selección.
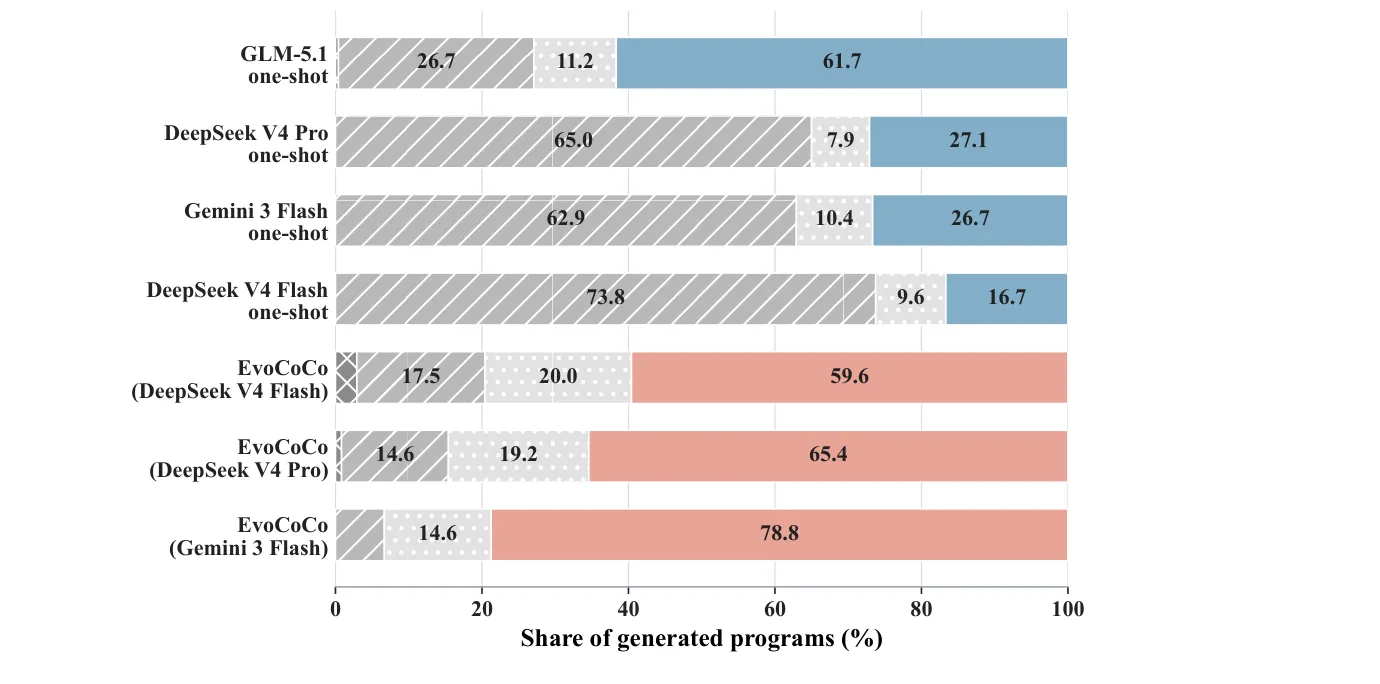
Figura 2. Resultados por etapa en 240 intentos de conversión independientes por condición. En tres comparaciones con el mismo modelo, los fallos de ejecución supusieron el 62.9%–73.8% de los intentos de traducción en un solo paso, frente al 6.7%–17.5% de EvoCoCo. Más candidatos pudieron avanzar a la evaluación de optimización.
Este cambio en el punto donde ocurren los fallos muestra que el ciclo de retroalimentación hace algo más que corregir errores: permite que el entorno de destino ayude a determinar qué implementaciones tensorizadas son realmente utilizables. Muchas traducciones en un solo paso se detienen en la etapa de ejecución. EvoCoCo obtiene información de diagnóstico mediante la ejecución real y, después, repara y filtra candidatos para que más implementaciones puedan pasar a la evaluación de su comportamiento de optimización.
Que el código se ejecute es solo el primer paso de la migración
Los experimentos de EvoCoCo responden a tres preguntas: si la conversión automática puede completarse de forma confiable, si los algoritmos convertidos conservan un rendimiento de optimización aceptable y si la tensorización puede liberar el paralelismo de las GPU. La evaluación cubre la confiabilidad de la migración, la fidelidad de optimización y la escalabilidad computacional.
1. Confiabilidad de la migración
En las comparaciones con el mismo modelo, cada condición incluyó 240 intentos de conversión independientes. EvoCoCo con Gemini 3 Flash alcanzó una tasa de aprobación de ejecución del 93.33% y una tasa de aprobación de convergencia del 78.75%. Para cada uno de los 48 algoritmos de referencia, EvoCoCo produjo al menos una implementación que superó la validación de convergencia. La tasa de aprobación de convergencia fue 52.08 puntos porcentuales superior a la de la traducción en un solo paso con el mismo modelo, y 17.08 puntos porcentuales superior a GLM-5.1, la mejor condición entre todas las traducciones en un solo paso.
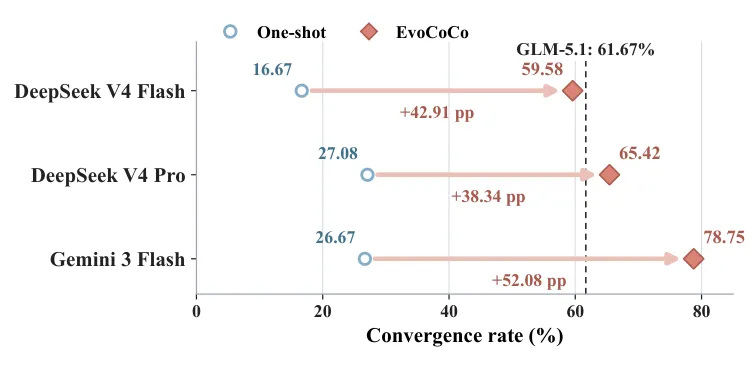
Figura 3. EvoCoCo mejoró la tasa de aprobación de convergencia frente a la traducción en un solo paso en las tres comparaciones con el mismo modelo. La línea discontinua representa a GLM-5.1, la referencia más fuerte de traducción en un solo paso.
2. Fidelidad de optimización
Los algoritmos evolutivos son estocásticos, por lo que la comparación elemento a elemento de la salida de una sola ejecución no puede establecer si la conversión preserva el comportamiento de optimización. La evaluación empleó ejecuciones repetidas e independientes para comparar los valores finales de distancia generacional inversa (IGD) de las implementaciones de PlatEMO y EvoX bajo configuraciones idénticas del problema. Las suites DTLZ, WFG, LSMOP y MaF aportaron 1,904 comparaciones válidas, de las cuales 1,680 cumplieron el criterio de fidelidad predefinido, con una cobertura global del 88.2%. La cobertura superó el 80% en las cuatro suites y alcanzó el 96.5% en WFG. De los 48 algoritmos, 41 lograron una cobertura a nivel de algoritmo de al menos el 80%.
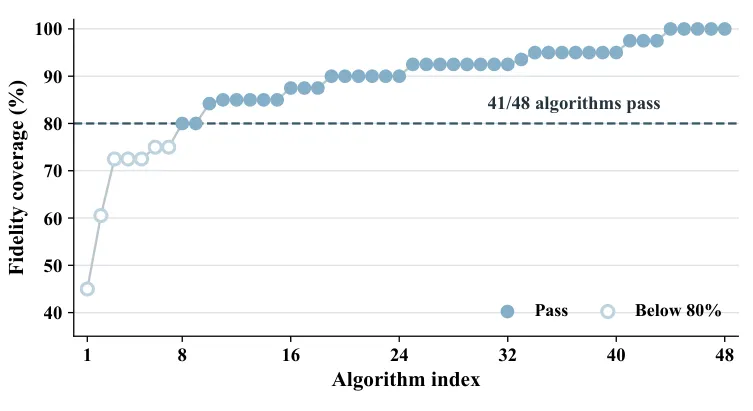
Figura 4. Cobertura de fidelidad de optimización para 48 algoritmos tensorizados. En total, 41 algoritmos alcanzaron el umbral del 80%.
3. Escalabilidad computacional
En el conjunto de comparaciones CPU–GPU válidas, la aceleración mediana fue de 22.6× al escalar el tamaño de la población y de 80.2× al escalar la dimensionalidad de las variables de decisión. A medida que el tamaño del problema aumentaba aún más, las implementaciones en GPU ganaron en general una mayor ventaja en tiempo de ejecución.
| Eje de escalado | Comparaciones válidas | Aceleración mediana | Media geométrica | Rango intercuartílico |
|---|---|---|---|---|
| Tamaño de la población | 289 | 22.6× | 29.9× | 4.5–163.5× |
| Dimensionalidad de las variables de decisión | 276 | 80.2× | 71.5× | 8.4–404.9× |
Las aceleraciones varían considerablemente entre algoritmos, pero la tendencia global es clara: a medida que aumentan el tamaño de la población o la dimensionalidad de las variables de decisión, la tensorización guiada por semántica libera progresivamente el paralelismo a nivel de población que permanecía oculto en las estructuras de los programas para CPU. Las curvas de tiempo de ejecución de algoritmos representativos ilustran aún más esta ventaja de escalabilidad.
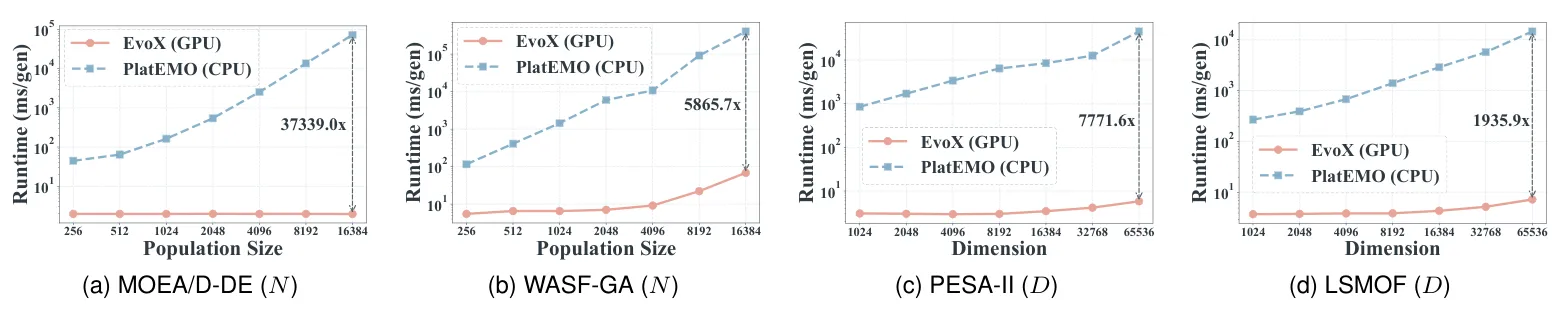
Figura 5. Los paneles (a) y (b) muestran el escalado del tamaño de la población; los paneles (c) y (d), el de la dimensionalidad de las variables de decisión. Las anotaciones indican las aceleraciones en las mayores escalas probadas. MOEA/D-DE alcanzó 37,339× con N = 16,384.
Más allá de las tres evaluaciones principales, las ablaciones de componentes y la conversión desde fuentes externas pusieron a prueba los mecanismos clave de EvoCoCo. En un subconjunto de diagnóstico de 12 algoritmos, el marco completo de EvoCoCo alcanzó tasas de aprobación de ejecución y convergencia del 98.3% y 83.3%, respectivamente. Eliminar el Repair Agent las redujo al 60.0% y 41.7%; usar una sola rama de generación las bajó al 68.3% y 40.0%. Estos resultados muestran que la retroalimentación de ejecución y la generación multirrama son especialmente importantes para la confiabilidad de la migración. En 10 implementaciones externas y heredadas de MATLAB/Octave fuera de PlatEMO, EvoCoCo logró una tasa de aprobación de ejecución del 96% y de convergencia del 62%. Nueve algoritmos obtuvieron al menos una implementación que superó la validación de convergencia. Los resultados correspondientes de la traducción en un solo paso fueron 34%, 18% y 2 algoritmos. Esto indica que el proceso por etapas de tensorización automática puede acomodar fuentes y estilos de código diversos, mientras que la eficacia de optimización sigue siendo la prueba más difícil.
El código puede cambiar; el algoritmo no
Pasar de MATLAB a PyTorch y de CPU a GPU cambia el lenguaje, las estructuras de datos y la estrategia de ejecución. Los mecanismos núcleo del algoritmo deben permanecer intactos.
EvoCoCo también es significativo por cómo replantea la conversión de código. Desplaza el foco de reproducir instrucciones a identificar qué debe preservarse. Cuando cambia la plataforma de cómputo, una conversión exitosa no necesita reproducir la estructura del programa original: debe permitir reorganizar el cálculo, siempre que se mantengan las relaciones que definen el algoritmo.
Un lenguaje de programación es una forma de expresar un algoritmo, y el hardware es una forma de ejecutar el cálculo. Lo que debe sobrevivir a la migración entre lenguajes y hardware es la estructura subyacente a ese cálculo.
Código abierto y recursos de la comunidad
Artículo: https://arxiv.org/abs/2609.02387
GitHub: https://github.com/EMI-Group/evococo
Proyecto upstream (EvoX): https://github.com/EMI-Group/evox
Grupo de QQ: 297969717
Grupo de QQ | Evolutionary Machine Intelligence