Lorsque l’évaluation des candidats domine le coût d’une recherche, la répartir peut ouvrir la voie à une expérience plus grande. Le guide expérimental EvoX du 23 avril 2025 explique le mécanisme introduit en mars : répartir la population entre processus, puis réunir les valeurs d’aptitude avant la mise à jour de l’algorithme.
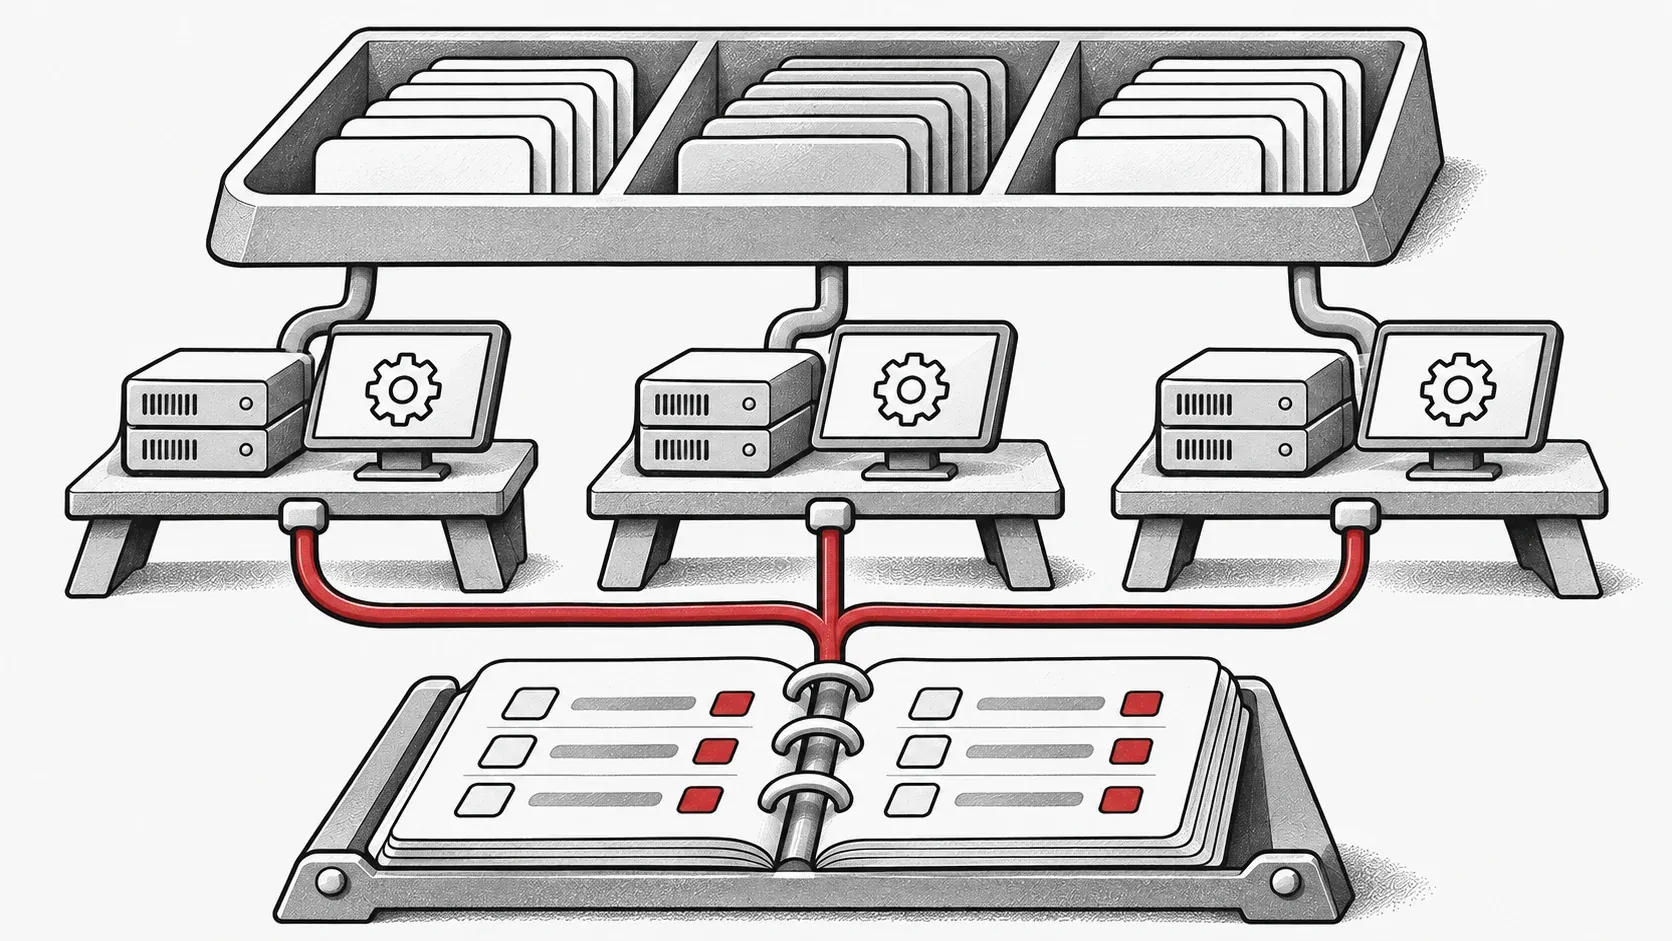
Évaluations séparées, retour commun à la population.
Répartir l’évaluation, réunir le retour
StdWorkflow reçoit des options d’exécution distribuée. La population est divisée sur la dimension des candidats selon le rang des processus. Chacun évalue sa part ; les valeurs d’adaptation sont ensuite rassemblées et concaténées avant de revenir à la mise à jour de l’algorithme. StdWorkflow
Il s’agit d’une évaluation distribuée dans un workflow coordonné, et non de recherches indépendantes dont on compare les résultats finaux. Une simulation coûteuse ou une fonction objectif lourde constitue un usage plausible, à condition d’accepter les lots attribués et de configurer correctement l’environnement.
La reproductibilité fait partie du réglage
Le guide insiste sur les graines aléatoires avant toute opération Torch ou NumPy et présente torch.distributed ou torchrun pour lancer les processus. L’implémentation isole l’état du générateur aléatoire autour de l’évaluation. Une initialisation cohérente permet de conserver des états de recherche compatibles tout en évaluant des candidats différents. 2025-04-23
Mesurer une génération entière
Comparez la référence à un processus et l’exécution distribuée avec les mêmes objectif, graine et budget de population. Mesurez une génération complète, communication comprise, et vérifiez l’ordre des candidats et des aptitudes. Le guide de démarrage présente le workflow à établir avant d’ajouter des périphériques.