当候选评估占据搜索的大部分成本时,把这部分工作分出去,就能为更大规模的实验打开空间。EvoX 于 2025 年 4 月 23 日发布的实验性指南,说明了当年 3 月引入的路径:按进程拆分种群,再在算法更新前汇总适应度。
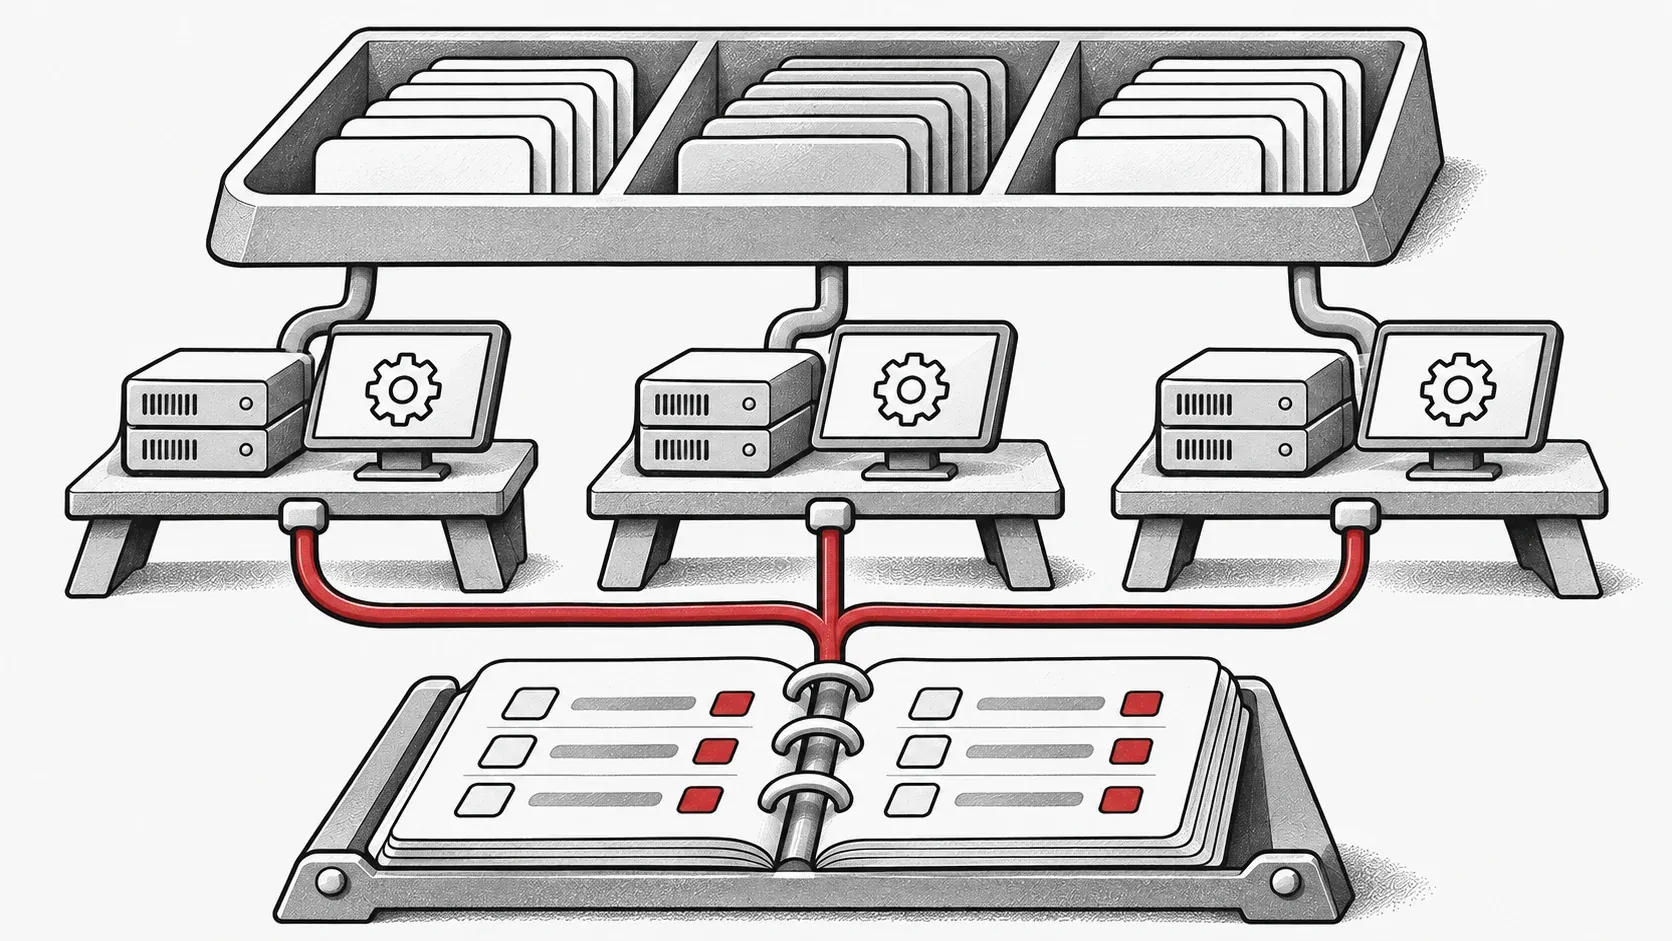
分开评估,汇合种群反馈。
分配评估,再汇合反馈
实现为 StdWorkflow 增加分布式执行选项。评估时,种群沿候选维度按进程 rank 切分;每个进程评估分配给自己的候选,随后收集并拼接适应度,再返回算法的更新路径。 StdWorkflow
这是协调工作流内部的分布式评估,与在不同机器上启动独立搜索、最后比较各自答案不同。高开销模拟或目标函数可以成为合理的应用场景,前提是评估能够处理分配的候选批量,且执行环境已正确配置。
可复现性是配置的一部分
指南强调在任何 Torch 或 NumPy 操作之前设置随机种子,并介绍通过 torch.distributed 或 torchrun 启动进程。实现会在问题评估周围隔离随机数生成器状态。一致初始化很重要,因为各进程在评估不同种群部分时,仍需要保持相容的搜索状态。 2025-04-23
衡量完整的一代计算
以相同目标、随机种子与种群预算,对比单进程基线和分布式运行。记录包含通信在内的完整一代耗时,并检查候选与适应度的顺序对应关系。可以先从快速入门建立完整工作流,再增加设备。