Wenn die Kandidatenbewertung den Großteil einer Suche kostet, kann ihre Verteilung größere Experimente ermöglichen. Der experimentelle EvoX-Leitfaden vom 23. April 2025 beschreibt den im März eingeführten Weg: die Population auf Prozesse aufteilen und Fitnesswerte vor dem Algorithmusupdate zusammenführen.
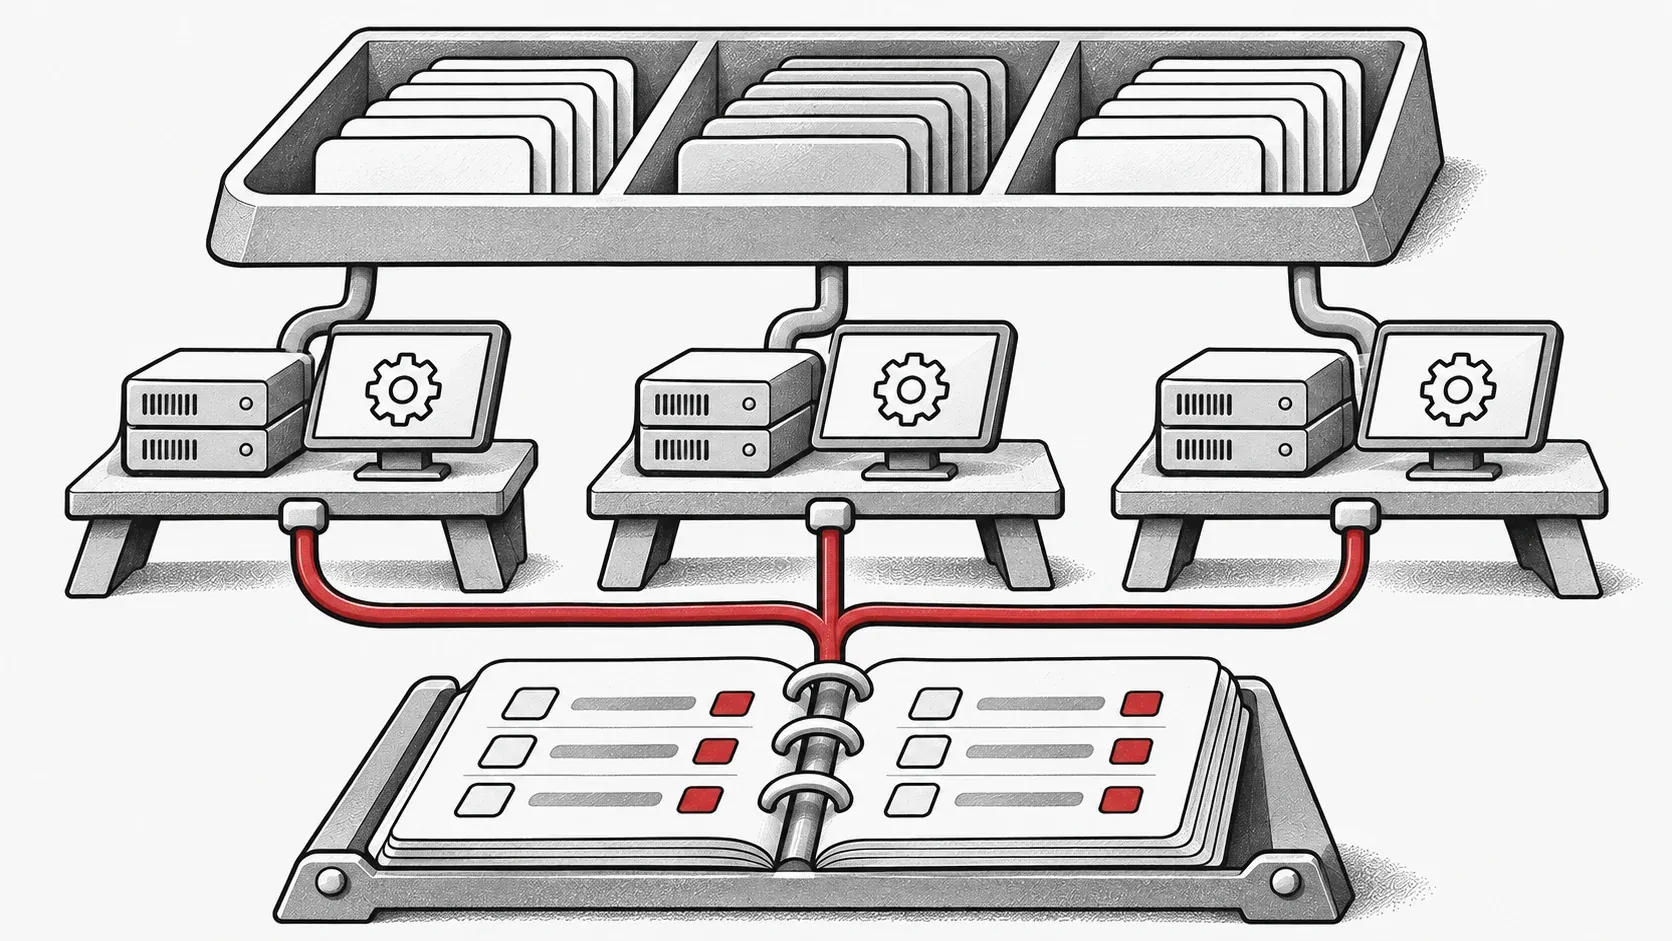
Getrennte Bewertungen, gemeinsames Populationsfeedback.
Auswertung verteilen, Rückmeldung zusammenführen
StdWorkflow erhält Optionen für verteilte Ausführung. Die Population wird entlang der Kandidatendimension nach Prozessrang geteilt. Jeder Prozess bewertet seinen Anteil; Fitnesswerte werden anschließend gesammelt und verkettet, bevor sie zur Aktualisierung des Algorithmus zurückkehren. StdWorkflow
Das ist verteilte Auswertung in einem koordinierten Workflow, nicht das Starten unabhängiger Suchen mit anschließendem Ergebnisvergleich. Teure Simulationen oder Zielfunktionen sind plausible Anwendungen, sofern sie zugeteilte Kandidatenbatches verarbeiten und die Umgebung korrekt eingerichtet ist.
Reproduzierbarkeit gehört zur Einrichtung
Der Leitfaden betont Zufallsseeds vor Torch- oder NumPy-Operationen und beschreibt Prozessstarts mit torch.distributed oder torchrun. Die Implementierung isoliert den Zufallsgeneratorzustand während der Problemauswertung. Konsistente Initialisierung hilft, kompatible Suchzustände trotz unterschiedlicher bewerteter Kandidaten zu erhalten. 2025-04-23
Die ganze Generation messen
Vergleichen Sie Einzelprozess-Basis und verteilten Lauf mit gleicher Zielfunktion, gleichem Seed und Populationsbudget. Erfassen Sie die vollständige Generationszeit einschließlich Kommunikation und prüfen Sie die Zuordnung von Kandidaten und Fitnesswerten. Der Schnelleinstieg erklärt den Workflow vor dem Hinzufügen weiterer Geräte.