La búsqueda científica y de ingeniería debe decidir repetidamente qué experimento realizar después. EvoGO estudia una versión computacional de esa pregunta: ¿pueden las evaluaciones enseñar a un generador a mejorar sus propuestas? Esto conecta la IA evolutiva de EvoX con una búsqueda que aprende de los candidatos ya comprobados. EvoGO
El problema: La optimización basada en datos aún no ha dado el paso definitivo
En los últimos años, los métodos de optimización evolutiva basados en datos se han desarrollado rápidamente. Los métodos asistidos por sustitutos y los basados en modelos generativos ya han impulsado la optimización evolutiva desde la búsqueda basada en operadores fijos hacia la búsqueda basada en el aprendizaje. Esto significa que los modelos de aprendizaje han comenzado a entrar en múltiples etapas del proceso, incluyendo la evaluación, el modelado e incluso la generación.
Sin embargo, esta transformación aún está incompleta. Los métodos existentes pueden haber aprendido a “evaluar” o “generar” en diferentes niveles, pero no han aprendido realmente a “optimizar”. Por un lado, la producción de la siguiente generación de soluciones candidatas sigue dependiendo a menudo de reglas heurísticas diseñadas manualmente para la coordinación. Por otro lado, el objetivo de generación y el objetivo de optimización suelen estar insuficientemente alineados. Al mismo tiempo, las muestras en línea extremadamente limitadas disponibles en la optimización de caja negra aún no se han transformado sistemáticamente en una experiencia de optimización que se pueda aprender y transferir.
Por lo tanto, lo que verdaderamente falta hoy en día no son más modelos per se, sino el paso final: permitir que los algoritmos de optimización aprendan directamente el proceso de pasar de peores soluciones a mejores a partir de datos históricos. Este es exactamente el paso que EvoGO busca impulsar.
El avance: Cómo EvoGO reescribe el proceso de optimización
Para abordar los problemas anteriores, EvoGO no continúa por la ruta tradicional de mejorar los operadores locales como el cruce y la mutación. En su lugar, intenta reescribir todo el proceso de optimización a un nivel más holístico. Su idea central es eliminar el proceso de “cómo generar la siguiente generación de soluciones candidatas” de las reglas escritas manualmente y entregarlo a un mecanismo generativo basado en datos para que lo aprenda. Específicamente, EvoGO organiza todo el proceso de optimización en tres etapas unificadas —preparación de datos, entrenamiento del modelo y generación de la población— de modo que la organización de la experiencia, el aprendizaje direccional y la actualización de la población ya no estén fragmentados, sino integrados en un único bucle de optimización.
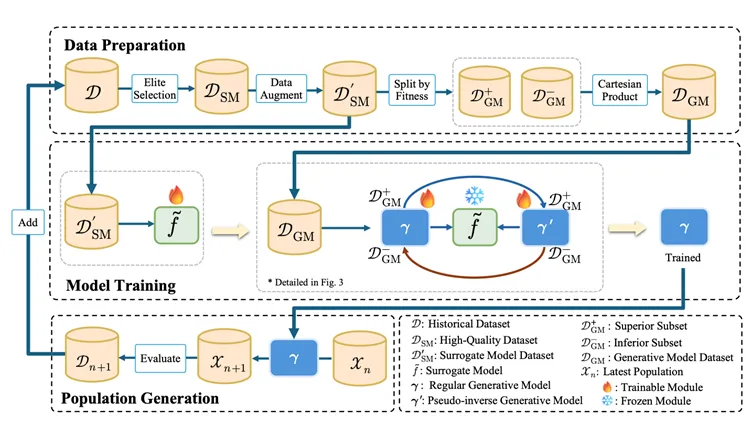
En la etapa de preparación de datos, EvoGO primero filtra muestras de alta calidad de las poblaciones históricas para construir una base de entrenamiento más confiable. Cuando las muestras son escasas, también se puede utilizar el aumento de datos aprendido para aliviar dicha escasez. Y lo que es más importante, las muestras se dividen aún más en soluciones superiores e inferiores y se organizan en relaciones emparejadas. Como resultado, lo que el modelo aprende ya no es solo una distribución estática de soluciones candidatas, sino más bien la relación direccional de pasar de soluciones inferiores a superiores.
En la etapa de entrenamiento del modelo, EvoGO adopta una estructura emparejada que consta de un modelo sustituto (surrogate model), un generador directo (forward generator) y un generador pseudoinverso (pseudo-inverse generator). El modelo sustituto proporciona una caracterización aproximada del panorama del objetivo; el generador directo aprende el mapeo de las soluciones inferiores a las superiores; y el generador pseudoinverso mantiene la estabilidad del entrenamiento mediante una restricción de consistencia de reconstrucción. A diferencia de las tareas de generación general, el objetivo de entrenamiento aquí no es simplemente ajustarse a la distribución de los datos, sino asegurar que el proceso de generación se mueva hacia regiones mejores bajo la guía del panorama del objetivo.
En la etapa de generación de la población, el modelo generativo entrenado actúa directamente sobre la población actual para producir una nueva generación de soluciones candidatas en paralelo. Estas soluciones luego son evaluadas por la función objetivo real, y el estado de la población se actualiza en consecuencia antes de entrar en la siguiente iteración. En este punto, la forma en que se realizan las actualizaciones de la población cambia fundamentalmente. La optimización evolutiva tradicional se basa principalmente en reglas de cruce, mutación y selección especificadas manualmente para explorar gradualmente el espacio de búsqueda, mientras que EvoGO convierte este proceso en un mecanismo de actualización en paralelo impulsado por datos históricos e implementado por un modelo generativo.
El paralelismo de EvoGO opera en dos niveles. Por un lado, la población puede representarse en forma tensorial, lo que permite que la generación y evaluación de los individuos se ejecute en paralelo en la GPU. Por otro lado, EvoGO también puede ejecutar múltiples modelos generativos simultáneamente en una sola GPU, lo que permite la optimización paralela en diferentes semillas aleatorias o diferentes instancias de problemas. Por lo tanto, su capacidad paralela existe tanto dentro de las poblaciones como entre múltiples poblaciones.
Desde esta perspectiva, la contribución clave de EvoGO no es simplemente la introducción de un modelo generativo, sino la unificación de la organización de muestras, la alineación de objetivos y la actualización de la población dentro de un único marco metodológico. La optimización evolutiva tradicional enfatiza la búsqueda impulsada por reglas preescritas, mientras que EvoGO va un paso más allá al intentar que el sistema aprenda el proceso de búsqueda en sí directamente a partir de datos históricos.
Validación: Análisis de rendimiento y mecanicista
Para evaluar rigurosamente la eficacia de este nuevo paradigma totalmente basado en datos, el artículo se centra en tres preguntas clave: ¿Es EvoGO lo suficientemente potente y eficiente? ¿Cuáles son las decisiones de diseño cruciales detrás de su éxito? ¿Qué comportamiento de búsqueda inteligente exhibe?
1. Comparación de rendimiento: La “convergencia en 10 generaciones” lidera en las pruebas de referencia
El artículo lleva a cabo una evaluación sistemática en tres categorías de tareas —optimización numérica, control clásico y control robótico de alta dimensión— que abarcan 25 pruebas de referencia con dimensiones de problemas que van de 10 a 1000. EvoGO se compara de forma exhaustiva con la optimización bayesiana, las estrategias de evolución clásicas, los métodos heurísticos y los métodos avanzados asistidos por sustitutos.
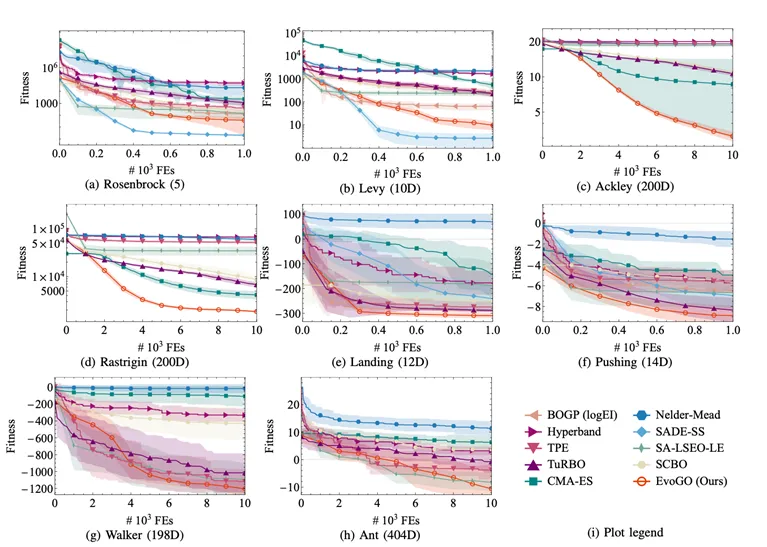
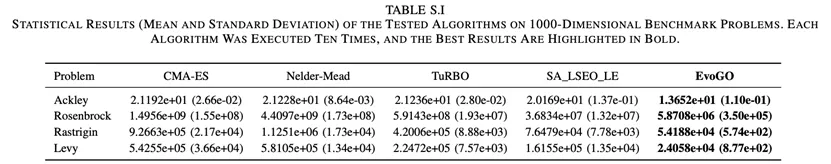
En general, EvoGO muestra claras ventajas en la mayoría de las tareas. En particular, esta ventaja no se limita a problemas de baja dimensión o relativamente regulares. Por el contrario, a medida que aumentan la dimensionalidad del problema y la complejidad de la tarea, la ventaja de EvoGO a menudo se vuelve más pronunciada. En condiciones de baja dimensión y muestras pequeñas, algunos de los métodos asistidos por sustitutos más potentes siguen siendo muy competitivos. Pero una vez que los problemas se vuelven de alta dimensión, complejos y dependientes de la computación en paralelo, el mecanismo generativo de EvoGO puede desplegarse más plenamente, y en la mayoría de las tareas a gran escala puede converger en aproximadamente 10 generaciones. Esto sugiere que el valor de EvoGO no radica en lograr la superioridad local en un solo tipo de problema, sino en estar mejor adaptado a la utilización de la experiencia a gran escala y la búsqueda paralela requeridas por la optimización compleja de caja negra.
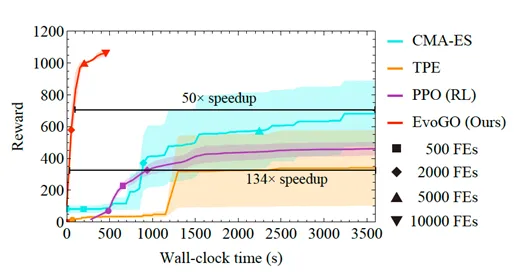
Esto es especialmente evidente en el entorno de control robótico de alta dimensión Hopper en Brax. Bajo el mismo presupuesto de evaluación de funciones y presupuesto de tiempo de ejecución, EvoGO supera significativamente a los algoritmos de optimización tradicionales como CMA-ES y TPE, y también supera al algoritmo de aprendizaje por refuerzo PPO, que requiere una interacción en línea con el entorno. Y lo que es más importante, gracias a la potencia de cálculo paralelo del hardware moderno, como las GPU, EvoGO puede alcanzar un alto nivel de recompensa en unos 500 segundos. Cuando CMA-ES finalmente converge a su mejor nivel de rendimiento, el tiempo real requerido por EvoGO para alcanzar el mismo rendimiento es mucho más corto, con una aceleración de hasta 134 veces. Este resultado muestra que la ventaja de EvoGO no radica simplemente en reducir el número de generaciones, sino en el hecho de que su propio proceso de búsqueda se adapta mejor a los recursos de computación en paralelo, comprimiendo las acciones de optimización que de otro modo se distribuirían en muchas generaciones en un proceso de actualización generativa de alto rendimiento.
2. Estudio de ablación: Analizando las claves del éxito
Para verificar la necesidad de los componentes centrales en el diseño “totalmente basado en datos” de EvoGO, el equipo de investigación llevó a cabo ablaciones sistemáticas centradas en la arquitectura generativa emparejada, el mecanismo de guía del sustituto y el diseño de objetivos orientado a la optimización. Se construyeron cinco variantes: una versión de un solo generador, una versión sin sustituto, una versión con objetivo adversarial, una versión con sustituto MLP y una versión con sustituto heurístico.
Los resultados experimentales muestran que la arquitectura generativa emparejada, el mecanismo de guía del sustituto y el diseño del objetivo orientado a la optimización son cruciales para la eficacia de EvoGO. La eliminación del generador pseudoinverso conduce a una estabilidad de convergencia notablemente peor y a una menor diversidad de la población, lo que indica que la estructura emparejada formada por la generación directa y las restricciones inversas es necesaria para mantener la estabilidad del entrenamiento y evitar el colapso de modo (mode collapse). La eliminación del modelo sustituto, o la sustitución del objetivo de optimización original por un objetivo adversarial general, también causa una degradación significativa del rendimiento, lo que demuestra que la guía del sustituto y la alineación del objetivo son fundamentales para la ventaja del método. Reemplazar el proceso gaussiano (Gaussian process) por un perceptrón multicapa (MLP) o por reglas heurísticas deja el método funcional, pero con un ligero declive general, lo que indica que EvoGO no depende de una forma específica de sustituto, aunque el modelado explícito de la incertidumbre es más beneficioso para el rendimiento. En general, las mejoras de rendimiento de EvoGO no provienen de un solo módulo, sino de la sinergia entre la arquitectura generativa emparejada, el mecanismo de guía del sustituto y el diseño del objetivo orientado a la optimización.
3. Visualización del comportamiento: Revelando un proceso dinámico basado en datos
Para analizar de forma más intuitiva la dinámica de búsqueda de EvoGO, el artículo presenta un experimento de visualización en la función bidimensional de Ackley, con el tamaño de la población establecido en 100. Específicamente, en diferentes generaciones evolutivas, se registran los resultados de transformación del generador directo entrenado en las soluciones de entrada; es decir, se rastrea el proceso de mapeo de las soluciones de entrada a las soluciones de salida. En la figura, las flechas representan vectores desde las soluciones de entrada a las de salida, y sus colores corresponden a las longitudes de los vectores. La estrella marca el óptimo global, y los cuadros de líneas discontinuas indican las regiones cubiertas por las soluciones generadas en diferentes generaciones. Para mayor claridad, las configuraciones de traslación y rotación del panorama de la función se omiten en esta visualización.
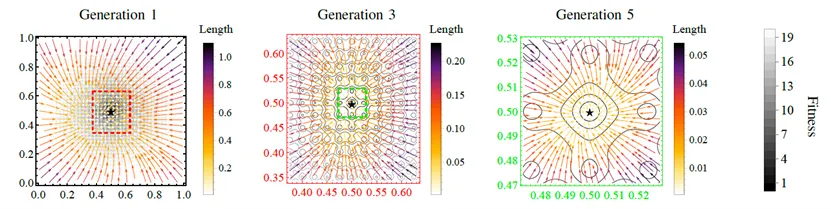
Los resultados de la visualización muestran que lo que EvoGO aprende no es una perturbación aleatoria sin dirección, sino un patrón de actualización que se adapta a la etapa de la búsqueda. En la etapa inicial, los vectores generados son generalmente más largos, lo que indica que el algoritmo tiende a una exploración global de gran amplitud. A medida que avanza la evolución, las longitudes de los vectores disminuyen gradualmente y las regiones generadas continúan contrayéndose, lo que demuestra que la búsqueda se desplaza hacia una explotación (exploitation) local más fina. Al mismo tiempo, los vectores en su conjunto se agrupan hacia la región óptima, lo que indica que el generador directo ya ha extraído una dirección de búsqueda con significado práctico de las muestras históricas. A nivel de comportamiento, este fenómeno respalda la propiedad central de EvoGO: no solo aprende la distribución de las soluciones candidatas, sino la ley de actualización que se mueve del estado actual hacia un estado mejor.
De los benchmarks a los flujos científicos
La búsqueda generativa puede explorarse en el diseño de ingeniería, pero los benchmarks no prueban la precisión del diseño de perfiles alares ni su despliegue aeronáutico. Se necesitan datos definidos, casos de prueba independientes, comprobaciones de restricciones y validación independiente por simulación o experimentación. El artículo EvoGO enlazado presenta benchmarks numéricos, de control y robótica; no valida los porcentajes de rendimiento aerodinámico.
Conclusión y perspectivas
Conserve un benchmark y su historial de evaluaciones. Compare propuestas aprendidas y referencia con el mismo presupuesto, registrando el tiempo de entrenamiento por separado. EvoGM: fusión autónoma de modelos de gran escala mediante evolución poblacional sin reentrenamiento
Recursos
Título y autores del artículo