La ricerca scientifica e ingegneristica deve decidere ripetutamente quale esperimento eseguire dopo. EvoGO ne studia una versione computazionale: le valutazioni possono insegnare a un generatore a migliorare le proposte? Questo collega l’IA evolutiva di EvoX a un processo di ricerca che impara dai candidati già verificati. EvoGO
L’Ostacolo: L’Ottimizzazione Guidata dai Dati Non Ha Ancora Compiuto il Passo Finale
Negli ultimi anni, i metodi di ottimizzazione evolutiva guidati dai dati si sono sviluppati rapidamente. I metodi assistiti da surrogati e quelli basati su modelli generativi hanno già spinto l’ottimizzazione evolutiva dalla ricerca guidata da operatori fissi verso la ricerca guidata dall’apprendimento. Ciò significa che i modelli di apprendimento hanno iniziato a entrare in molteplici fasi della pipeline, tra cui valutazione, modellazione e persino generazione.
Eppure questa trasformazione è ancora incompleta. I metodi esistenti potrebbero aver appreso come “valutare” o “generare” a diversi livelli, ma non hanno ancora appreso veramente come “ottimizzare”. Da un lato, la produzione della generazione successiva di soluzioni candidate dipende ancora spesso da regole euristiche progettate manualmente per il coordinamento. Dall’altro, l’obiettivo di generazione e l’obiettivo di ottimizzazione sono spesso insufficientemente allineati. Allo stesso tempo, i campioni online estremamente limitati disponibili nell’ottimizzazione black-box non sono ancora stati trasformati sistematicamente in un’esperienza di ottimizzazione apprendibile e trasferibile.
Pertanto, ciò che manca veramente oggi non sono più modelli di per sé, ma il passo finale: consentire agli algoritmi di ottimizzazione di apprendere direttamente il processo di passaggio da soluzioni peggiori a soluzioni migliori a partire dai dati storici. Questo è esattamente il passo che EvoGO cerca di compiere.
La Svolta: Come EvoGO Riscrive la Pipeline di Ottimizzazione
Per affrontare le problematiche sopra descritte, EvoGO non prosegue lungo il percorso tradizionale di miglioramento degli operatori locali come il crossover e la mutazione. Al contrario, tenta di riscrivere la pipeline di ottimizzazione a un livello più olistico. La sua idea centrale è rimuovere il processo di “come generare la successiva generazione di soluzioni candidate” dalle regole scritte manualmente per affidarlo a un meccanismo generativo guidato dai dati affinché lo apprenda. Nello specifico, EvoGO organizza l’intero processo di ottimizzazione in tre fasi unificate — preparazione dei dati, addestramento del modello e generazione della popolazione — in modo che l’organizzazione dell’esperienza, l’apprendimento direzionale e l’aggiornamento della popolazione non siano più frammentati, ma integrati in un singolo ciclo di ottimizzazione.
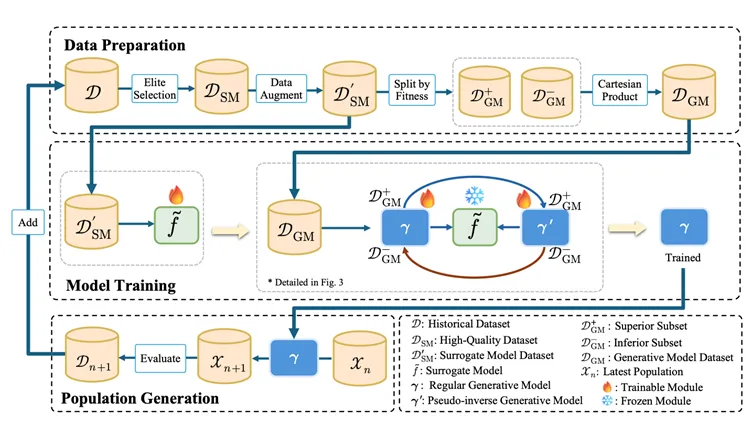
Nella fase di preparazione dei dati, EvoGO filtra innanzitutto campioni di alta qualità dalle popolazioni storiche per costruire una base di addestramento più affidabile. Quando i campioni sono scarsi, è possibile utilizzare anche un’augmentazione appresa per alleviare la carenza di dati. Ancora più importante, i campioni vengono ulteriormente suddivisi in soluzioni superiori e inferiori e organizzati in relazioni accoppiate. Di conseguenza, ciò che il modello apprende non è più solo una distribuzione statica di soluzioni candidate, ma piuttosto la relazione direzionale del passaggio da soluzioni inferiori a soluzioni superiori.
Nella fase di addestramento del modello, EvoGO adotta una struttura accoppiata composta da un modello surrogato, un generatore in avanti (forward generator) e un generatore pseudo-inverso (pseudo-inverse generator). Il modello surrogato fornisce una caratterizzazione approssimativa del panorama dell’obiettivo; il generatore in avanti apprende la mappatura dalle soluzioni inferiori a quelle superiori; e il generatore pseudo-inverso mantiene la stabilità dell’addestramento attraverso un vincolo di coerenza della ricostruzione. A differenza dei compiti di generazione generale, l’obiettivo di addestramento qui non è semplicemente adattare la distribuzione dei dati, ma garantire che il processo di generazione si muova verso regioni migliori sotto la guida del panorama dell’obiettivo.
Nella fase di generazione della popolazione, il modello generativo addestrato agisce direttamente sulla popolazione attuale per produrre parallelamente una nuova generazione di soluzioni candidate. Queste soluzioni vengono poi valutate dalla funzione obiettivo reale e lo stato della popolazione viene aggiornato di conseguenza prima di entrare nell’iterazione successiva. A questo punto, il modo in cui vengono eseguiti gli aggiornamenti della popolazione cambia radicalmente. L’ottimizzazione evolutiva tradizionale si affida principalmente a regole di crossover, mutazione e selezione specificate manualmente per sondare gradualmente lo spazio di ricerca, mentre EvoGO trasforma questo processo in un meccanismo di aggiornamento parallelo guidato dai dati storici e implementato da un modello generativo.
Il parallelismo di EvoGO opera su due livelli. Da un lato, la popolazione può essere rappresentata in forma tensoriale, consentendo alla generazione e alla valutazione degli individui di essere eseguite in parallelo sulla GPU. Dall’altro lato, EvoGO può anche eseguire contemporaneamente più modelli generativi su un’unica GPU, abilitando l’ottimizzazione parallela su diversi seed casuali o diverse istanze del problema. La sua capacità parallela esiste quindi sia all’interno delle popolazioni sia attraverso più popolazioni.
Da questa prospettiva, il contributo chiave di EvoGO non è semplicemente l’introduzione di un modello generativo, ma l’unificazione dell’organizzazione dei campioni, dell’allineamento degli obiettivi e dell’aggiornamento della popolazione all’interno di un singolo framework metodologico. L’ottimizzazione evolutiva tradizionale enfatizza la ricerca guidata da regole pre-scritte, mentre EvoGO fa un passo ulteriore cercando di far apprendere al sistema il processo di ricerca stesso direttamente dai dati storici.
Validazione: Analisi delle Prestazioni e del Meccanismo
Per valutare rigorosamente l’efficacia di questo nuovo paradigma completamente guidato dai dati, il documento si concentra su tre domande chiave: EvoGO è sufficientemente potente ed efficiente? Quali sono le scelte progettuali cruciali alla base del suo successo? Quale comportamento di ricerca intelligente esibisce?
1. Confronto delle Prestazioni: La “Convergenza in 10 Generazioni” Primeggia nei Benchmark
Il documento conduce una valutazione sistematica su tre categorie di compiti — ottimizzazione numerica, controllo classico e controllo robotico ad alta dimensionalità — coprendo 25 test benchmark con dimensioni del problema che vanno da 10 a 1000. EvoGO viene confrontato in modo completo con l’ottimizzazione bayesiana, le strategie di evoluzione classiche, i metodi euristici e i metodi avanzati assistiti da surrogati.
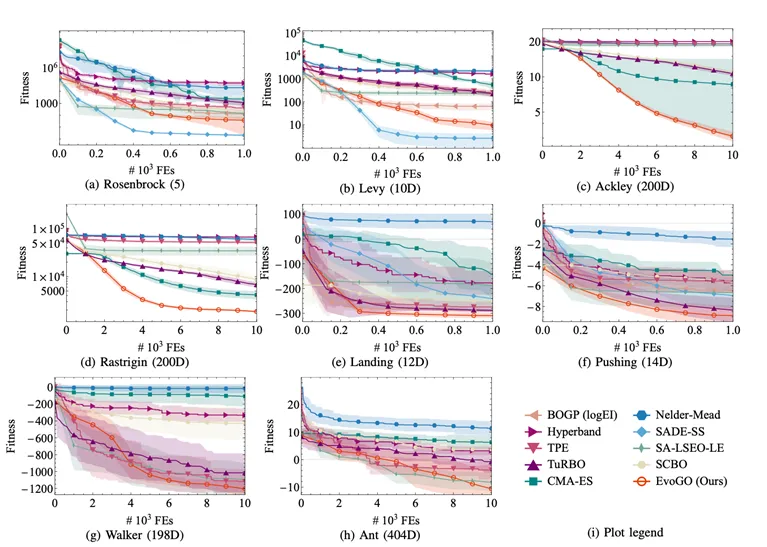
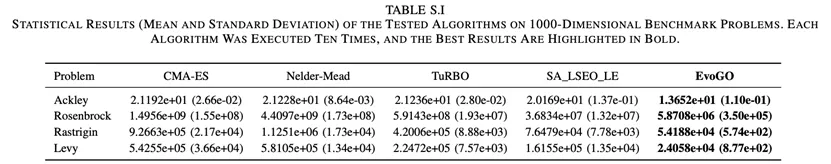
Nel complesso, EvoGO mostra chiari vantaggi sulla maggior parte dei compiti. Da notare che questo vantaggio non è limitato a problemi di bassa dimensionalità o relativamente regolari. Al contrario, all’aumentare della dimensionalità del problema e della complessità del compito, il vantaggio di EvoGO diventa spesso più pronunciato. In condizioni di bassa dimensionalità e piccoli campioni, alcuni dei più forti metodi assistiti da surrogati rimangono altamente competitivi. Ma una volta che i problemi diventano ad alta dimensionalità, complessi e dipendenti dal calcolo parallelo, il meccanismo generativo di EvoGO è in grado di dispiegarsi in modo più completo e sulla maggior parte dei compiti su larga scala può convergere in circa 10 generazioni. Ciò suggerisce che il valore di EvoGO non risiede nell’ottenere una superiorità locale su un singolo tipo di problema, ma nell’essere più adatto all’utilizzo dell’esperienza su larga scala e alla ricerca parallela richiesti dalla complessa ottimizzazione black-box.
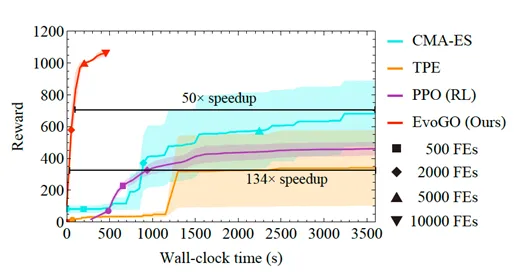
Ciò è particolarmente evidente nell’ambiente di controllo robotico ad alta dimensionalità Hopper in Brax. A parità di budget per la valutazione delle funzioni e di budget per il tempo di esecuzione, EvoGO supera significativamente gli algoritmi di ottimizzazione tradizionali come CMA-ES e TPE, e supera anche l’algoritmo di apprendimento per rinforzo PPO, che richiede l’interazione online con l’ambiente. Più importante, grazie alla potenza di calcolo parallelo di hardware moderno come le GPU, EvoGO può raggiungere un livello di ricompensa elevato in circa 500 secondi. Quando CMA-ES raggiunge infine la sua convergenza al miglior livello di prestazioni, il tempo effettivo (wall-clock time) richiesto da EvoGO per raggiungere le stesse prestazioni è molto più breve — con un’accelerazione fino a 134 volte. Questo risultato dimostra che il vantaggio di EvoGO non risiede solo nella riduzione del numero di generazioni, ma nel fatto che il suo stesso processo di ricerca è meglio adattato alle risorse di calcolo parallelo, comprimendo le azioni di ottimizzazione, che altrimenti sarebbero distribuite su molte generazioni, in un processo di aggiornamento generativo ad alto rendimento.
2. Studio di Ablazione: Analisi delle Chiavi del Successo
Per verificare la necessità dei componenti fondamentali nella progettazione “completamente guidata dai dati” di EvoGO, il team di ricerca ha condotto ablazioni sistematiche incentrate sull’architettura generativa accoppiata, sul meccanismo di guida del surrogato e sulla progettazione dell’obiettivo orientata all’ottimizzazione. Sono state costruite cinque varianti: una versione a generatore singolo, una versione senza surrogato, una versione con obiettivo avversario, una versione con surrogato MLP e una versione con surrogato euristico.
I risultati sperimentali mostrano che l’architettura generativa accoppiata, il meccanismo di guida del surrogato e la progettazione dell’obiettivo orientata all’ottimizzazione sono tutti cruciali per l’efficacia di EvoGO. La rimozione del generatore pseudo-inverso porta a una stabilità di convergenza notevolmente peggiore e a una ridotta diversità della popolazione, indicando che la struttura accoppiata formata dalla generazione in avanti e dai vincoli inversi è necessaria per mantenere la stabilità dell’addestramento ed evitare il collasso della modalità (mode collapse). La rimozione del modello surrogato, o la sostituzione dell’obiettivo di ottimizzazione originale con un obiettivo avversario generale, causa anche un degrado significativo delle prestazioni, dimostrando che la guida del surrogato e l’allineamento dell’obiettivo sono fondamentali per il vantaggio del metodo. Sostituendo il processo gaussiano (Gaussian process) con un percettrone multistrato (MLP) o con regole euristiche, il metodo rimane funzionante, ma con un leggero declino complessivo, indicando che EvoGO non dipende da una forma specifica di surrogato, sebbene la modellazione esplicita dell’incertezza sia più vantaggiosa per le prestazioni. Nel complesso, i guadagni in termini di prestazioni di EvoGO non derivano da un singolo modulo, ma dalla sinergia tra l’architettura generativa accoppiata, il meccanismo di guida del surrogato e la progettazione dell’obiettivo orientata all’ottimizzazione.
3. Visualizzazione del Comportamento: Rivelazione di un Processo Dinamico Guidato dai Dati
Per analizzare in modo più intuitivo le dinamiche di ricerca di EvoGO, il documento presenta un esperimento di visualizzazione sulla funzione bidimensionale di Ackley, con la dimensione della popolazione impostata a 100. Nello specifico, a diverse generazioni evolutive, vengono registrati i risultati della trasformazione del generatore in avanti addestrato sulle soluzioni di input, ovvero viene tracciato il processo di mappatura dalle soluzioni di input a quelle di output. Nella figura, le frecce rappresentano i vettori dalle soluzioni di input a quelle di output e i loro colori corrispondono alle lunghezze dei vettori. La stella segna l’ottimo globale e i riquadri tratteggiati indicano le regioni coperte dalle soluzioni generate nelle diverse generazioni. Per chiarezza, le impostazioni di traslazione e rotazione del panorama della funzione sono omesse in questa visualizzazione.
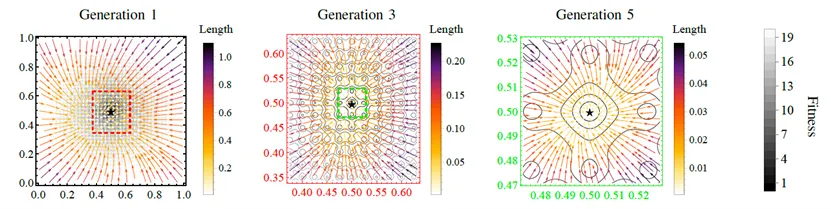
I risultati della visualizzazione mostrano che ciò che EvoGO apprende non è una perturbazione casuale senza direzione, ma un modello di aggiornamento che si adatta allo stadio della ricerca. Nelle fasi iniziali, i vettori generati sono generalmente più lunghi, indicando che l’algoritmo tende a un’esplorazione globale di ampia ampiezza. Procedendo con l’evoluzione, le lunghezze dei vettori diminuiscono gradualmente e le regioni generate continuano a contrarsi, mostrando che la ricerca si sposta verso uno sfruttamento locale più fine. Allo stesso tempo, i vettori nel loro insieme si raggruppano verso la regione ottimale, indicando che il generatore in avanti ha già estratto una direzione di ricerca dotata di significato pratico dai campioni storici. A livello comportamentale, questo fenomeno supporta la proprietà centrale di EvoGO: esso apprende non solo la distribuzione delle soluzioni candidate, ma la legge di aggiornamento che muove dallo stato attuale verso uno stato migliore.
Dai benchmark ai workflow scientifici
La ricerca generativa può essere esplorata nella progettazione, ma i benchmark non provano la precisione dei profili alari né un impiego aeronautico. Servono dati definiti, casi di test indipendenti, verifiche dei vincoli e validazione mediante simulazioni o esperimenti indipendenti. Il lavoro EvoGO citato presenta benchmark numerici, di controllo e robotica, senza convalidare le percentuali aerodinamiche.
Conclusione e Prospettive
Conservi un benchmark e la cronologia delle valutazioni. Confronti proposte apprese e riferimento con lo stesso budget, registrando separatamente il tempo di addestramento. EvoGM: fusione autonoma di grandi modelli tramite evoluzione di popolazione, senza ri-addestramento
Risorse
Titolo e autori dello studio