科学与工程搜索需要反复回答:下一次应当尝试什么?EvoGO 研究这个问题的计算实现——能否让评价结果教会生成器改进候选方案?它将 EvoX 的演化式 AI 方向推进到搜索过程自身的学习,让已经完成的试验参与指导下一轮探索。 EvoGO
困境:数据驱动优化仍未迈出最后一步
近年来,数据驱动的演化优化方法发展迅速。代理辅助方法和基于生成模型的方法已经将演化优化从固定算子驱动搜索推向了学习驱动搜索。这意味着学习模型已开始进入包括评估、建模甚至生成在内的多个流水线阶段。
然而,这种转变仍不彻底。现有方法可能在不同层面上学习了如何“评估”或“生成”,但并未真正学习如何“优化”。一方面,下一代候选解的产生通常仍依赖人工设计的启发式规则进行协调。另一方面,生成目标与优化目标往往不够一致。同时,黑盒优化中极其有限的在线样本尚未被系统地转化为可学习、可迁移的优化经验。
因此,当前真正缺失的不是更多的模型本身,而是最后一步:使优化算法能够直接从历史数据中学习从较差解向更好解演进的过程。这正是 EvoGO 试图推动的一步。
突破:EvoGO 如何重写优化流水线
为了解决上述问题,EvoGO 没有继续沿着改进交叉和变异等局部算子的传统路线走下去。相反,它试图在更整体的层面上重写优化流水线。其核心思想是将“如何生成下一代候选解”的过程从人工编写的规则中剥离出来,交给数据驱动的生成机制去学习。具体而言,EvoGO 将整个优化过程组织为三个统一的阶段——数据准备、模型训练和种群生成——从而使经验组织、方向学习和种群更新不再割裂,而是被整合到一个单一的优化循环中。
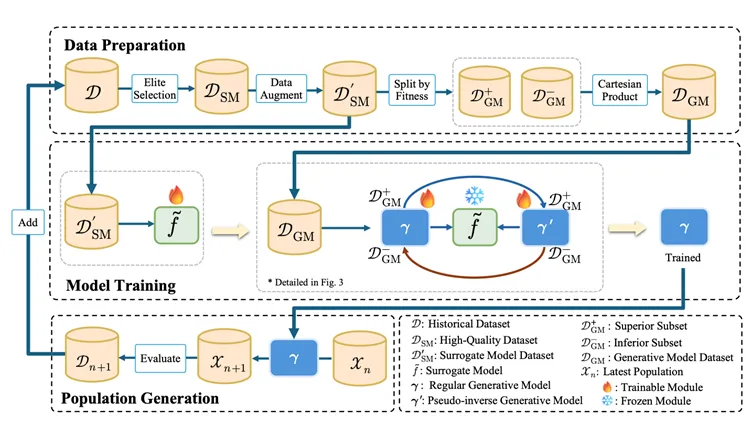
在数据准备阶段,EvoGO 首先从历史种群中筛选出高质量样本,以构建更可靠的训练基础。当样本稀缺时,还可以利用学习到的数据增强方法来缓解数据不足的问题。更重要的是,样本被进一步划分为优势解和劣势解,并组织成配对关系。结果,模型学习的不再仅仅是候选解的静态分布,而是从劣质解向优质解移动的方向关系。
在模型训练阶段,EvoGO 采用由代理模型、前向生成器和伪逆向生成器组成的配对结构。代理模型提供目标地形的近似表征;前向生成器学习从劣质解到优质解的映射;而伪逆向生成器通过重建一致性约束来保持训练的稳定性。与一般的生成任务不同,这里的训练目标不仅仅是拟合数据分布,而是在目标地形的引导下,确保生成过程向更好的区域移动。
在种群生成阶段,训练好的生成模型直接作用于当前种群,并行产生新一代的候选解。这些解随后由真实目标函数进行评估,并在进入下一次迭代之前更新种群状态。此时,种群更新的方式发生了根本性变化。传统的演化优化主要依赖人工指定的交叉、变异和选择规则来逐步探测搜索空间,而 EvoGO 则将这一过程转变为由历史数据驱动、由生成模型实现的并行更新机制。
EvoGO 的并行性体现在两个层面。一方面,种群可以用张量化形式表示,允许个体的生成和评估在 GPU 上并行运行。另一方面,EvoGO 也可以在单个 GPU 上同时运行多个生成模型,从而实现跨不同随机种子或不同问题实例的并行优化。因此,它的并行能力既存在于种群内部,也存在于多个种群之间。
从这个角度来看,EvoGO 的关键贡献不仅在于引入了生成模型,更在于将样本组织、目标对齐和种群更新统一在一个单一的方法论框架内。传统的演化优化强调由预写规则驱动的搜索,而 EvoGO 更进一步,试图让系统直接从历史数据中学习搜索过程本身。
验证:性能与机制分析
为了严格评估这种新的完全数据驱动范式的有效性,论文聚焦于三个关键问题:EvoGO 是否足够强大和高效?其成功背后的关键设计选择是什么?它展现出怎样的智能搜索行为?
1. 性能对比:“10代收敛”领跑基准测试
论文在数值优化、经典控制和高维机器人控制三大类任务上进行了系统评估,涵盖25个基准测试,问题维度从10到1000不等。EvoGO 与贝叶斯优化、经典演化策略、启发式方法以及先进的代理辅助方法进行了全面比较。
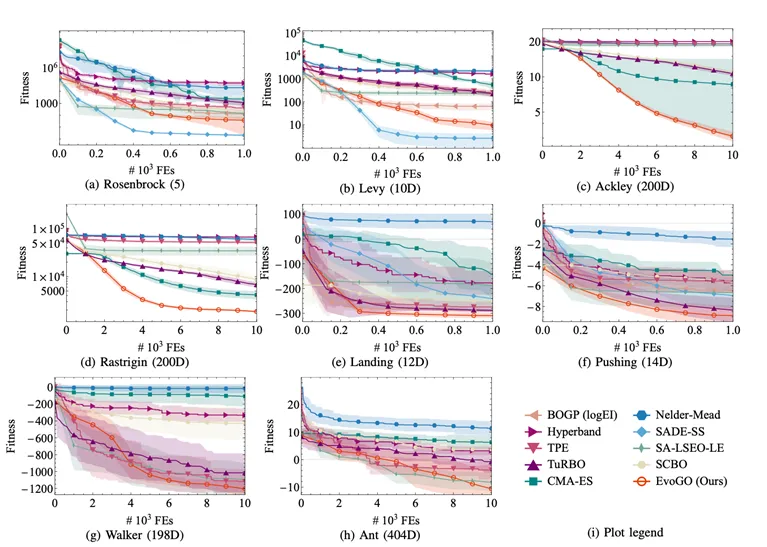
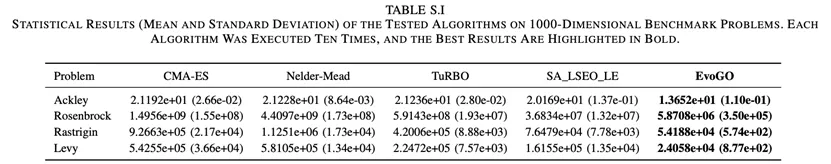
总体而言,EvoGO 在绝大多数任务上都展现出了明显的优势。值得注意的是,这种优势并不局限于低维或相对规则的问题。相反,随着问题维度和任务复杂度的增加,EvoGO 的优势往往变得更加明显。在低维和小样本条件下,一些最强的代理辅助方法仍然极具竞争力。但一旦问题变成高维、复杂且依赖于并行计算,EvoGO 的生成机制就能更充分地发挥作用,在大多数大规模任务上它可以在大约10代内收敛。这表明 EvoGO 的价值并不在于在某一种类型的问题上取得局部优势,而在于更适合复杂黑盒优化所需的大规模经验利用和并行搜索。
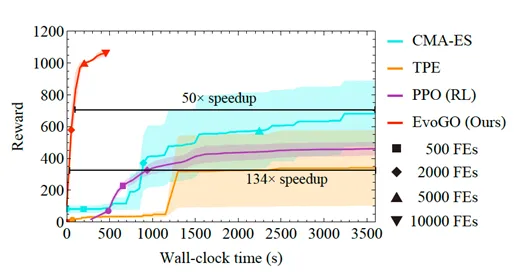
这在 Brax 中的高维机器人控制环境 Hopper 中表现得尤为明显。在相同的函数评估预算和运行时间预算下,EvoGO 显著优于 CMA-ES 和 TPE 等传统优化算法,同时也超越了需要与环境进行在线交互的 PPO 强化学习算法。更重要的是,得益于 GPU 等现代硬件的并行计算能力,EvoGO 可以在大约 500 秒内达到很高的奖励水平。当 CMA-ES 最终收敛到其最佳性能水平时,EvoGO 达到相同性能所需的实际时钟时间要短得多——最多可实现134倍的加速。这一结果表明,EvoGO 的优势不仅在于减少了迭代代数,更在于其搜索过程本身能更好地匹配并行计算资源,将原本分散在许多代中的优化动作压缩为高吞吐量的生成更新过程。
2. 消融实验:剖析成功的关键
为了验证 EvoGO“完全数据驱动”设计中核心组件的必要性,研究团队围绕配对生成架构、代理引导机制和面向优化的目标设计进行了系统的消融实验。构建了五个变体:单生成器版本、无代理版本、对抗目标版本、MLP代理版本和启发式代理版本。
实验结果表明,配对生成架构、代理引导机制和面向优化的目标设计对 EvoGO 的有效性都至关重要。移除伪逆向生成器会导致收敛稳定性明显变差、种群多样性降低,这表明由前向生成和逆向约束形成的配对结构对于保持训练稳定性和避免模式崩溃是必要的。移除代理模型,或将原始优化目标替换为通用对抗目标,也会导致显著的性能下降,说明代理引导和目标对齐是该方法优势的核心。将高斯过程替换为多层感知机或启发式规则后,方法仍能发挥作用,但整体性能略有下降,这表明 EvoGO 并不依赖特定的代理形式,尽管显式的不确定性建模对性能更有利。总体而言,EvoGO 的性能提升并非来自任何单一模块,而是源于配对生成架构、代理引导机制和面向优化的目标设计之间的协同作用。
3. 行为可视化:揭示数据驱动的动态过程
为了更直观地分析 EvoGO 的搜索动态,论文在二维 Ackley 函数上进行了可视化实验,种群规模设为 100。具体来说,在不同的演化代数中,记录了训练好的前向生成器对输入解的变换结果——即追踪了从输入解到输出解的映射过程。图中,箭头表示从输入解到输出解的向量,其颜色对应于向量长度。星号标记全局最优解,虚线框指示不同代数中生成的解所覆盖的区域。为了清晰起见,此可视化中省略了函数地形的平移和旋转设置。
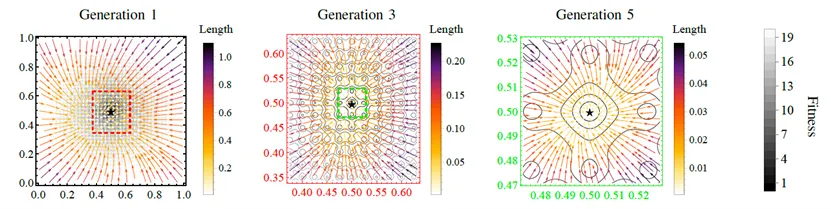
可视化结果显示,EvoGO 学到的并不是无方向的随机扰动,而是随搜索阶段自适应变化的更新模式。在早期阶段,生成的向量通常较长,表明算法倾向于大幅度的全局探索。随着演化的进行,向量长度逐渐减小,生成的区域继续收缩,表明搜索转向更精细的局部利用。与此同时,向量整体上向最优区域聚集,这表明前向生成器已经从历史样本中提取出了具有实际意义的搜索方向。在行为层面上,这一现象支持了 EvoGO 的核心属性:它学习的不仅是候选解的分布,而是从当前状态向更好状态移动的更新规律。
从基准走向科学工作流
生成式搜索可以作为工程设计的探索方向,但基准结果不能直接证明翼型设计精度或飞机应用效果。工程评估需要明确数据集、独立测试样本、约束检查,以及独立仿真或实验验证。本文链接的 EvoGO 论文报告了数值优化、控制与机器人基准,尚不足以支持具体的翼型设计百分比指标。
结论与展望
选择一个基准任务并保存评估历史。在相同评估预算下比较学习得到的候选方案与基线,单独记录模型训练时间。 EvoGM:无需重新训练,通过群体演化实现大模型自主合并
相关资源
论文标题与作者