La recherche scientifique et technique doit sans cesse décider quelle expérience mener ensuite. EvoGO étudie une version informatique de cette question : les évaluations peuvent-elles apprendre à un générateur à améliorer ses propositions ? Cette approche inscrit la démarche d’IA évolutionnaire d’EvoX dans un processus de recherche qui apprend des candidats déjà testés. EvoGO
La Situation : L’Optimisation Pilotée par les Données N’a Toujours Pas Franchi l’Étape Finale
Ces dernières années, les méthodes d’optimisation évolutionnaire pilotées par les données se sont développées rapidement. Les méthodes assistées par des modèles de substitution et les méthodes basées sur des modèles génératifs ont déjà poussé l’optimisation évolutionnaire de la recherche pilotée par des opérateurs fixes vers la recherche pilotée par l’apprentissage. Cela signifie que les modèles d’apprentissage ont commencé à entrer dans de multiples étapes du pipeline, y compris l’évaluation, la modélisation et même la génération.
Pourtant, cette transformation est encore incomplète. Les méthodes existantes ont peut-être appris à « évaluer » ou à « générer » à différents niveaux, mais elles n’ont pas vraiment appris à « optimiser ». D’une part, la production de la prochaine génération de solutions candidates dépend encore souvent de règles heuristiques conçues manuellement pour la coordination. D’autre part, l’objectif de génération et l’objectif d’optimisation sont souvent insuffisamment alignés. Dans le même temps, les échantillons en ligne extrêmement limités disponibles dans l’optimisation en boîte noire n’ont pas encore été systématiquement transformés en une expérience d’optimisation apprenable et transférable.
Par conséquent, ce qui manque vraiment aujourd’hui n’est pas davantage de modèles en soi, mais l’étape finale : permettre aux algorithmes d’optimisation d’apprendre directement le processus de passage de pires solutions à de meilleures solutions à partir de données historiques. C’est exactement l’étape qu’EvoGO cherche à faire avancer.
La Percée : Comment EvoGO Réécrit le Pipeline d’Optimisation
Pour résoudre les problèmes ci-dessus, EvoGO ne poursuit pas la voie traditionnelle consistant à améliorer les opérateurs locaux tels que le croisement et la mutation. Au lieu de cela, il tente de réécrire le pipeline d’optimisation à un niveau plus holistique. Son idée principale est de retirer le processus de « comment générer la prochaine génération de solutions candidates » des règles écrites manuellement pour le confier à un mécanisme génératif piloté par les données afin de l’apprendre. Plus précisément, EvoGO organise l’ensemble du processus d’optimisation en trois étapes unifiées — la préparation des données, l’entraînement du modèle et la génération de la population — de sorte que l’organisation de l’expérience, l’apprentissage directionnel et la mise à jour de la population ne soient plus fragmentés, mais plutôt intégrés dans une seule boucle d’optimisation.
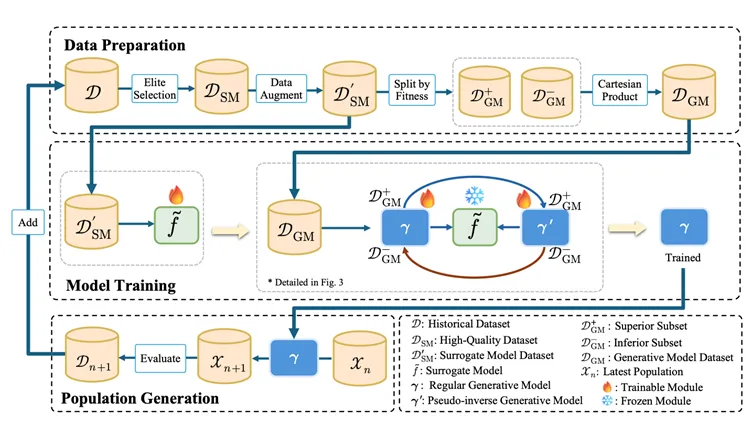
Lors de l’étape de préparation des données, EvoGO filtre d’abord des échantillons de haute qualité à partir des populations historiques pour construire une base d’entraînement plus fiable. Lorsque les échantillons sont rares, l’augmentation apprise (learned augmentation) peut également être utilisée pour atténuer la pénurie de données. Plus important encore, les échantillons sont ensuite divisés en solutions supérieures et inférieures et organisés en relations appariées. En conséquence, ce que le modèle apprend n’est plus seulement une distribution statique de solutions candidates, mais plutôt la relation directionnelle permettant de passer de solutions inférieures à des solutions supérieures.
Lors de l’étape d’entraînement du modèle, EvoGO adopte une structure appariée composée d’un modèle de substitution (surrogate model), d’un générateur direct (forward generator) et d’un générateur pseudo-inverse. Le modèle de substitution fournit une caractérisation approximative du paysage de l’objectif ; le générateur direct apprend la cartographie (mapping) des solutions inférieures vers les solutions supérieures ; et le générateur pseudo-inverse maintient la stabilité de l’entraînement via une contrainte de cohérence de reconstruction. Contrairement aux tâches de génération générales, l’objectif d’entraînement ici n’est pas simplement de s’ajuster à la distribution des données, mais de s’assurer que le processus de génération se dirige vers de meilleures régions sous la direction du paysage de l’objectif.
Lors de l’étape de génération de la population, le modèle génératif entraîné agit directement sur la population actuelle pour produire une nouvelle génération de solutions candidates en parallèle. Ces solutions sont ensuite évaluées par la véritable fonction objectif, et l’état de la population est mis à jour en conséquence avant d’entrer dans la prochaine itération. À ce stade, la façon dont les mises à jour de la population sont effectuées change fondamentalement. L’optimisation évolutionnaire traditionnelle repose principalement sur des règles de croisement, de mutation et de sélection spécifiées manuellement pour sonder progressivement l’espace de recherche, tandis qu’EvoGO transforme ce processus en un mécanisme de mise à jour parallèle piloté par des données historiques et implémenté par un modèle génératif.
Le parallélisme d’EvoGO opère à deux niveaux. D’une part, la population peut être représentée sous une forme tensorisée, ce qui permet de générer et d’évaluer les individus en parallèle sur le GPU. D’autre part, EvoGO peut également exécuter plusieurs modèles génératifs simultanément sur un seul GPU, permettant une optimisation parallèle à travers différentes graines aléatoires (random seeds) ou différentes instances de problèmes. Sa capacité parallèle existe donc à la fois au sein des populations et à travers de multiples populations.
De ce point de vue, la contribution clé d’EvoGO n’est pas simplement l’introduction d’un modèle génératif, mais l’unification de l’organisation des échantillons, de l’alignement des objectifs et de la mise à jour de la population au sein d’un cadre méthodologique unique. L’optimisation évolutionnaire traditionnelle met l’accent sur la recherche pilotée par des règles pré-écrites, tandis qu’EvoGO va un pas plus loin en tentant de laisser le système apprendre le processus de recherche lui-même directement à partir de données historiques.
Validation : Analyse des Performances et des Mécanismes
Pour évaluer rigoureusement l’efficacité de ce nouveau paradigme entièrement piloté par les données, l’article se concentre sur trois questions clés : EvoGO est-il suffisamment puissant et efficace ? Quels sont les choix de conception cruciaux derrière son succès ? Quel comportement de recherche intelligent présente-t-il ?
1. Comparaison des Performances : La « Convergence en 10 Générations » en Tête des Benchmarks
L’article mène une évaluation systématique sur trois catégories de tâches — l’optimisation numérique, le contrôle classique et le contrôle robotique à haute dimension — couvrant 25 tests de référence avec des dimensions de problèmes allant de 10 à 1000. EvoGO est comparé de manière exhaustive avec l’optimisation bayésienne, les stratégies d’évolution classiques, les méthodes heuristiques et les méthodes avancées assistées par des modèles de substitution.
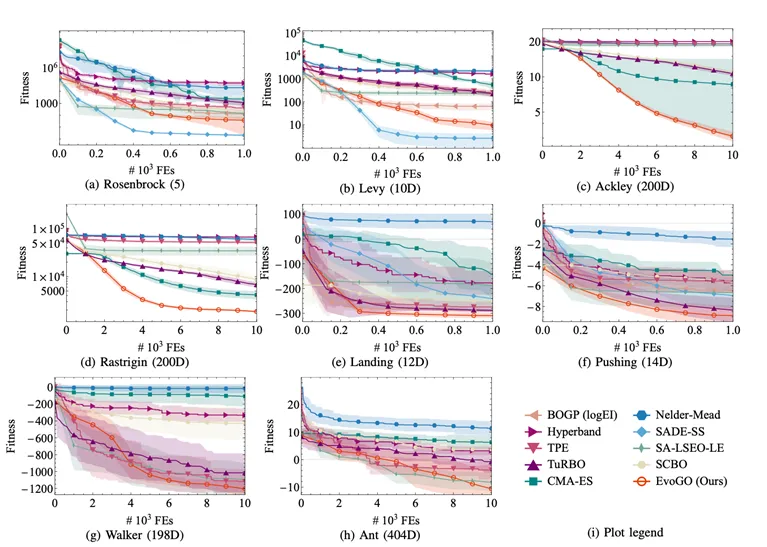
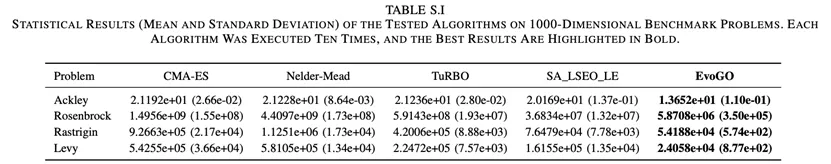
Dans l’ensemble, EvoGO montre des avantages évidents sur la plupart des tâches. Fait notable, cet avantage ne se limite pas aux problèmes de faible dimension ou relativement réguliers. Au contraire, à mesure que la dimensionnalité du problème et la complexité de la tâche augmentent, l’avantage d’EvoGO devient souvent plus prononcé. Dans des conditions de faible dimension et de petits échantillons, certaines des méthodes assistées par des modèles de substitution les plus solides restent très compétitives. Mais une fois que les problèmes deviennent hautement dimensionnels, complexes et dépendants du calcul parallèle, le mécanisme génératif d’EvoGO est capable de se déployer plus pleinement, et sur la plupart des tâches à grande échelle, il peut converger en environ 10 générations. Cela suggère que la valeur d’EvoGO ne réside pas dans l’obtention d’une supériorité locale sur un seul type de problème, mais dans le fait qu’il est mieux adapté à l’utilisation d’expériences à grande échelle et à la recherche parallèle requises par l’optimisation en boîte noire complexe.
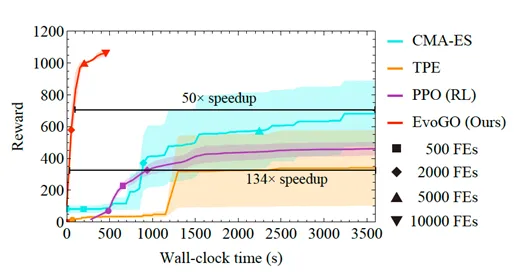
Ceci est particulièrement évident dans l’environnement de contrôle robotique à haute dimension Hopper dans Brax. Sous le même budget d’évaluation de fonction et le même budget de temps d’exécution, EvoGO surpasse de manière significative les algorithmes d’optimisation traditionnels tels que CMA-ES et TPE, et surpasse également l’algorithme d’apprentissage par renforcement PPO, qui nécessite une interaction en ligne avec l’environnement. Plus important encore, grâce à la puissance de calcul parallèle du matériel moderne tel que les GPU, EvoGO peut atteindre un niveau de récompense élevé en environ 500 secondes. Lorsque CMA-ES finit par converger vers son meilleur niveau de performance, le temps réel (wall-clock time) nécessaire pour qu’EvoGO atteigne la même performance est beaucoup plus court — jusqu’à 134 fois plus rapide. Ce résultat montre que l’avantage d’EvoGO n’est pas seulement de réduire le nombre de générations, mais réside dans le fait que son processus de recherche lui-même est mieux adapté aux ressources de calcul parallèle, compressant les actions d’optimisation qui seraient autrement réparties sur de nombreuses générations en un processus de mise à jour génératif à haut débit.
2. Étude d’Ablation : Décrypter les Clés du Succès
Afin de vérifier la nécessité des composants de base dans la conception « entièrement pilotée par les données » d’EvoGO, l’équipe de recherche a mené des études d’ablation systématiques centrées sur l’architecture générative appariée, le mécanisme de guidage par modèle de substitution et la conception de l’objectif orientée vers l’optimisation. Cinq variantes ont été construites : une version à générateur unique, une version sans modèle de substitution, une version à objectif antagoniste, une version de modèle de substitution basé sur MLP, et une version de modèle de substitution heuristique.
Les résultats expérimentaux montrent que l’architecture générative appariée, le mécanisme de guidage par modèle de substitution et la conception de l’objectif orientée vers l’optimisation sont tous cruciaux pour l’efficacité d’EvoGO. La suppression du générateur pseudo-inverse entraîne une stabilité de convergence nettement pire et une diversité de population réduite, ce qui indique que la structure appariée formée par la génération directe et les contraintes inverses est nécessaire pour maintenir la stabilité de l’entraînement et éviter l’effondrement de mode (mode collapse). La suppression du modèle de substitution, ou le remplacement de l’objectif d’optimisation d’origine par un objectif antagoniste général, entraîne également une dégradation significative des performances, montrant que le guidage par le modèle de substitution et l’alignement des objectifs sont au cœur de l’avantage de la méthode. Le remplacement du processus gaussien par un perceptron multicouche (MLP) ou des règles heuristiques laisse toujours la méthode fonctionnelle, mais avec un léger déclin global, ce qui indique qu’EvoGO ne dépend pas d’une forme spécifique de modèle de substitution, bien qu’une modélisation explicite de l’incertitude soit plus bénéfique pour les performances. Dans l’ensemble, les gains de performance d’EvoGO ne proviennent d’aucun module unique, mais de la synergie entre l’architecture générative appariée, le mécanisme de guidage par modèle de substitution et la conception de l’objectif orientée vers l’optimisation.
3. Visualisation du Comportement : Révéler un Processus Dynamique Piloté par les Données
Afin d’analyser plus intuitivement la dynamique de recherche d’EvoGO, l’article présente une expérience de visualisation sur la fonction bidimensionnelle de Ackley, avec une taille de population fixée à 100. Plus précisément, à différentes générations évolutives, les résultats de la transformation du générateur direct entraîné sur les solutions d’entrée sont enregistrés — c’est-à-dire que le processus de cartographie des solutions d’entrée vers les solutions de sortie est suivi. Sur la figure, les flèches représentent des vecteurs allant des solutions d’entrée aux solutions de sortie, et leurs couleurs correspondent aux longueurs de vecteur. L’étoile marque l’optimum global, et les boîtes en pointillés indiquent les régions couvertes par les solutions générées à différentes générations. Par souci de clarté, les paramètres de translation et de rotation du paysage de la fonction sont omis dans cette visualisation.
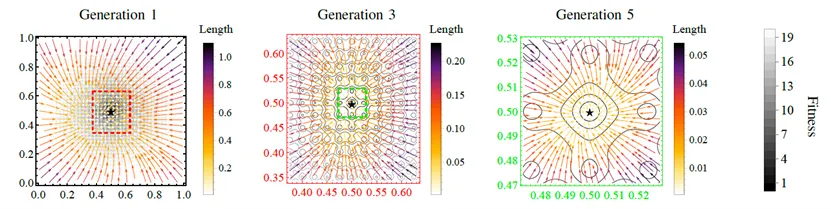
Les résultats de la visualisation montrent que ce qu’EvoGO apprend n’est pas une perturbation aléatoire sans direction, mais un modèle de mise à jour qui s’adapte en fonction de l’étape de recherche. Au stade initial, les vecteurs générés sont généralement plus longs, ce qui indique que l’algorithme tend vers une exploration globale à grande amplitude. À mesure que l’évolution progresse, la longueur des vecteurs diminue progressivement et les régions générées continuent de se contracter, ce qui montre que la recherche se déplace vers une exploitation (exploitation) locale plus fine. Dans le même temps, les vecteurs dans leur ensemble se rassemblent vers la région optimale, ce qui indique que le générateur direct a déjà extrait une direction de recherche concrètement significative à partir des échantillons historiques. Au niveau comportemental, ce phénomène soutient la propriété centrale d’EvoGO : il n’apprend pas seulement la distribution des solutions candidates, mais la loi de mise à jour qui fait passer de l’état actuel vers un meilleur état.
Des benchmarks aux workflows scientifiques
La recherche générative peut être explorée en conception technique, mais les benchmarks ne prouvent ni la précision de conception d’un profil aérodynamique ni un déploiement aéronautique. Il faudrait définir les données, réserver des cas de test, contrôler les contraintes et réaliser une validation indépendante par simulation ou expérimentation. L’article EvoGO cité présente des benchmarks numériques, de contrôle et de robotique ; il ne fournit pas de validation des pourcentages de performance aérodynamique.
Conclusion et Perspectives
Conservez un benchmark et son historique d’évaluations. Comparez les propositions apprises à une référence à budget égal, en enregistrant séparément le temps d’entraînement. EvoGM : fusion de grands modèles autonome via l’évolution de population, sans réentraînement
Ressources
Titre et auteurs de l’article