科学や工学の探索では、次に何を試すかを繰り返し決めます。EvoGO はその計算上の実現を研究します。評価結果から、生成器は提案を改善できるでしょうか。この問いを通じて、EvoX の進化型 AI を、試した候補から学ぶ探索プロセスへとつなぎます。 EvoGO
課題:データ駆動型最適化はまだ最後の一歩を踏み出していない
近年、データ駆動型の進化最適化手法は急速に発展しています。サロゲート支援手法や生成モデルベースの手法により、進化最適化はすでに固定オペレータ駆動の探索から学習駆動の探索へと押し上げられています。これは、評価、モデリング、さらには生成を含むパイプラインの複数の段階に学習モデルが入り込み始めていることを意味します。
しかし、この変革はまだ不完全です。既存の手法は、異なるレベルで「評価」または「生成」する方法を学習しているかもしれませんが、「最適化」する方法を真に学習してはいません。一方で、次世代の候補解の生成は、依然として手動で設計されたヒューリスティックなルールによる調整に依存することが多いです。他方で、生成目標と最適化目標が十分に一致していないことがよくあります。同時に、ブラックボックス最適化で利用できる極めて限られたオンラインサンプルは、まだ学習可能で転移可能な最適化経験へと体系的に変換されていません。
したがって、現在本当に欠けているのは、単により多くのモデルではなく、最適化アルゴリズムが劣悪な解からより良い解へと向かうプロセスを履歴データから直接学習できるようにするという最後の一歩です。これこそが、EvoGO が推し進めようとしているステップです。
突破口:EvoGO はいかに最適化パイプラインを書き換えるか
上記の問題に対処するため、EvoGO は交叉や突然変異などの局所的オペレータを改善するという従来のルートをたどりません。代わりに、最適化パイプラインをより全体的なレベルで書き換えることを試みます。その核となるアイデアは、「次世代の候補解をどのように生成するか」というプロセスを手書きのルールから取り除き、それをデータ駆動型の生成メカニズムに学習させることです。具体的には、EvoGO は最適化プロセス全体をデータ準備、モデル学習、集団生成という3つの統一された段階に構成し、経験の整理、方向性学習、および集団の更新が分断されることなく、単一の最適化ループに統合されるようにします。
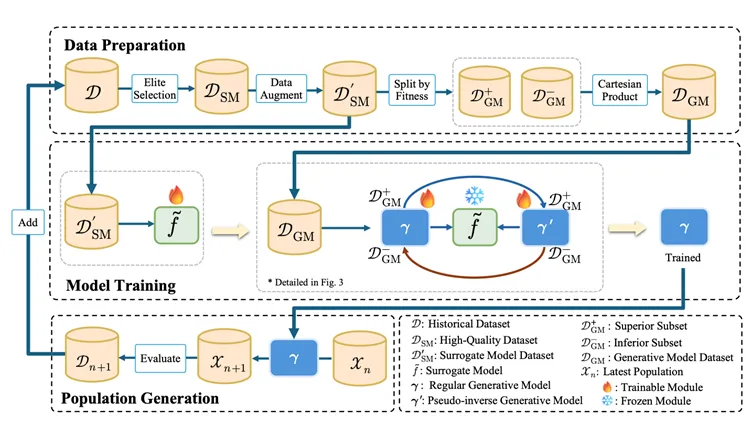
データ準備段階において、EvoGO はまず履歴集団から高品質なサンプルをフィルタリングし、より信頼性の高い学習基盤を構築します。サンプルが不足している場合は、学習されたデータ拡張を用いてデータ不足を緩和することもできます。さらに重要なことに、サンプルは優良解と劣悪解に分類され、ペアの関係として構成されます。結果として、モデルが学習するのはもはや候補解の静的な分布ではなく、劣悪な解から優れた解へ移行するという方向性を持った関係性です。
モデル学習段階では、EvoGO はサロゲートモデル、フォワード生成器、および擬似逆生成器からなるペア構造を採用しています。サロゲートモデルは目的関数の地形の近似表現を提供し、フォワード生成器は劣悪な解から優れた解へのマッピングを学習し、擬似逆生成器は再構成の一貫性制約によって学習の安定性を維持します。一般的な生成タスクとは異なり、ここでの学習目標は単にデータの分布に適合することではなく、目的関数の地形の導きの下で、生成プロセスがより良い領域に向かって進むことを確実にすることです。
集団生成段階では、学習済みの生成モデルが現在の集団に直接作用し、次世代の候補解を並列に生成します。これらの解は次に実際の目的関数によって評価され、集団の状態が更新されてから次の反復に入ります。この時点で、集団の更新が行われる方法が根本的に変わります。従来の進化最適化は、手動で指定された交叉、突然変異、および選択ルールに主に依存して探索空間を徐々に探っていましたが、EvoGO はこのプロセスを履歴データに駆動され生成モデルによって実装される並列更新メカニズムへと変えます。
EvoGO の並列性は2つのレベルで動作します。一方で、集団はテンソル化された形式で表現でき、個体の生成と評価を GPU 上で並列に実行できます。他方で、EvoGO は単一の GPU 上で複数の生成モデルを同時に実行することもでき、異なるランダムシードまたは異なる問題インスタンス間での並列最適化を可能にします。したがって、その並列能力は集団内と複数の集団間の両方に存在します。
この観点から見ると、EvoGO の重要な貢献は単なる生成モデルの導入ではなく、サンプル構成、目的の整合、および集団の更新を単一の方法論的枠組みの中に統合したことです。従来の進化最適化は事前に書かれたルールに基づく探索を強調しますが、EvoGO はさらに一歩進んで、システムが探索プロセス自体を履歴データから直接学習できるようにしようとします。
検証:パフォーマンスとメカニズムの分析
この新しい完全データ駆動型パラダイムの有効性を厳密に評価するために、論文では3つの重要な問題に焦点を当てています。EvoGO は十分に強力で効率的か?その成功の背後にある重要な設計上の選択は何か?どのようなインテリジェントな探索行動を示すか?
1. パフォーマンス比較:「10世代収束」がベンチマーク全体をリード
論文では、数値最適化、古典的制御、および高次元ロボット制御の3つのタスクカテゴリについて体系的な評価を実施し、10から1000の範囲の問題次元を持つ25のベンチマークテストをカバーしています。EvoGO は、ベイズ最適化、古典的な進化戦略、ヒューリスティック手法、および高度なサロゲート支援手法と包括的に比較されています。
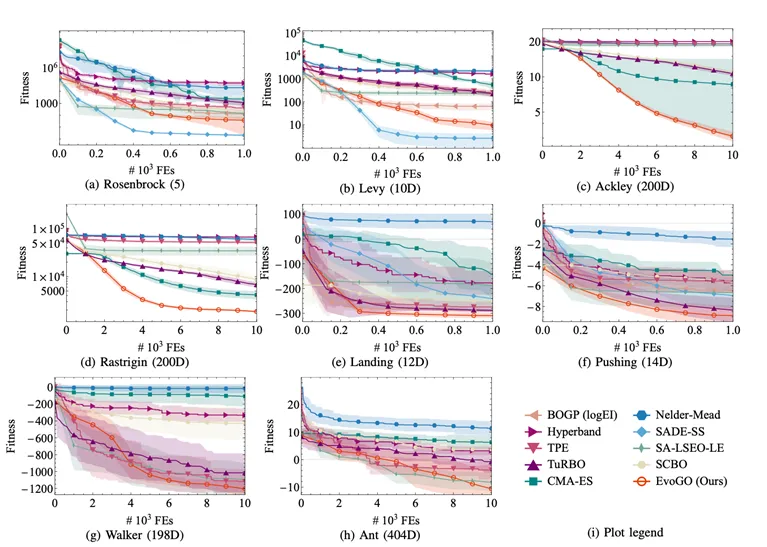
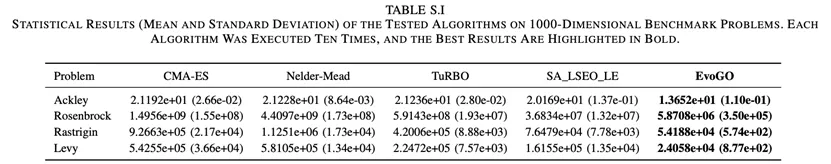
全体として、EvoGO はほとんどのタスクで明確な優位性を示しています。特に、この優位性は低次元または比較的規則的な問題に限定されません。逆に、問題の次元とタスクの複雑さが増すにつれて、EvoGO の優位性はさらに顕著になることがよくあります。低次元かつ小サンプルの条件下では、いくつかの最強のサロゲート支援手法が依然として高い競争力を維持しています。しかし、問題が高次元で複雑になり、並列計算に依存するようになると、EvoGO の生成メカニズムがより十分に展開され、ほとんどの大規模タスクにおいて約10世代で収束することができます。これは、EvoGO の価値が単一のタイプの問題で局所的な優位性を達成することにあるのではなく、複雑なブラックボックス最適化で必要とされる大規模な経験の活用と並列探索により適していることにあることを示唆しています。
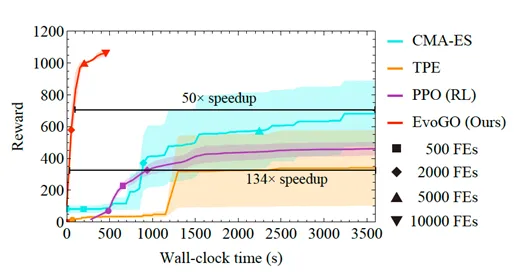
これは、Brax の高次元ロボット制御環境 Hopper で特に顕著です。同じ関数評価バジェットと実行時間バジェットの下で、EvoGO は CMA-ES や TPE などの従来の最適化アルゴリズムを大幅に上回り、環境とのオンラインインタラクションを必要とする PPO 強化学習アルゴリズムも凌駕します。さらに重要なことに、GPU などの最新のハードウェアの並列計算能力のおかげで、EvoGO は約500秒で高い報酬レベルに達することができます。CMA-ES が最終的に最高のパフォーマンスレベルに収束したとき、EvoGO が同じパフォーマンスに達するために必要な実際の実行時間ははるかに短く、最大134倍のスピードアップとなります。この結果は、EvoGO の優位性が単に世代数を減らすことにあるのではなく、その探索プロセス自体が並列計算リソースにより良く適合しており、多くの世代に分散される最適化アクションを高スループットの生成更新プロセスに圧縮している点にあることを示しています。
2. アブレーション調査:成功の鍵を解剖する
EvoGO の「完全データ駆動型」設計におけるコアコンポーネントの必要性を検証するために、研究チームはペア生成アーキテクチャ、サロゲートガイダンスメカニズム、および最適化指向の目的設計を中心とした体系的なアブレーションを実施しました。単一生成器バージョン、サロゲートなしバージョン、敵対的目的バージョン、MLPサロゲートバージョン、およびヒューリスティックサロゲートバージョンの5つのバリアントが構築されました。
実験結果は、ペア生成アーキテクチャ、サロゲートガイダンスメカニズム、および最適化指向の目的設計がすべて、EvoGO の有効性にとって重要であることを示しています。擬似逆生成器を削除すると、収束の安定性が顕著に悪化し、集団の多様性が減少します。これは、フォワード生成と逆制約によって形成されるペア構造が、学習の安定性を維持しモード崩壊を回避するために必要であることを示しています。サロゲートモデルを削除したり、元の最適化目標を一般的な敵対的目標に置き換えたりした場合も、大幅なパフォーマンスの低下を引き起こし、サロゲートガイダンスと目的の整合がこの手法の優位性の核心であることを示しています。ガウス過程を多層パーセプトロンやヒューリスティックなルールに置き換えても手法は機能しますが、全体的にわずかな低下が見られます。これは、EvoGO が特定のサロゲート形式に依存しているわけではないものの、明示的な不確実性モデリングがパフォーマンスに有利であることを示しています。全体として、EvoGO のパフォーマンス向上は単一のモジュールによるものではなく、ペア生成アーキテクチャ、サロゲートガイダンスメカニズム、および最適化指向の目的設計の間の相乗効果から生じています。
3. 行動の可視化:データ駆動の動的プロセスを明らかにする
EvoGO の探索のダイナミクスをより直感的に分析するために、論文では2次元の Ackley 関数での可視化実験が提示されており、集団サイズは100に設定されています。具体的には、さまざまな進化の世代において、学習済みのフォワード生成器による入力解の変換結果、つまり入力解から出力解へのマッピングプロセスが記録されています。図では、矢印は入力解から出力解へのベクトルを表し、その色はベクトルの長さに対応しています。星印はグローバル最適解を示し、破線のボックスはさまざまな世代で生成された解がカバーする領域を示しています。わかりやすくするために、この可視化では関数の地形の平行移動と回転の構成は省略されています。
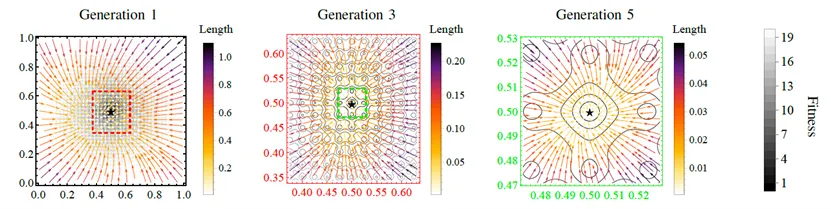
可視化の結果は、EvoGO が学習したのが方向性のないランダムな摂動ではなく、探索の段階に適応する更新パターンであることを示しています。初期段階では生成されるベクトルが全体的に長く、アルゴリズムが振幅の大きい大域的な探索に向かう傾向があることを示しています。進化が進むにつれてベクトルの長さは徐々に減少し、生成される領域は収縮し続け、探索がより細かい局所的な活用へと移行していることを示しています。同時に、ベクトル全体が最適領域に向かって集まっており、フォワード生成器がすでに履歴サンプルから実用的な意味のある探索方向を抽出していることを示しています。行動レベルにおいて、この現象は EvoGO の中心的な特性を裏付けています。つまり、候補解の分布だけでなく、現在の状態からより良い状態へ移行する更新法則を学習しているということです。
ベンチマークから科学ワークフローへ
生成的探索は設計応用の候補ですが、ベンチマークだけで翼型精度や航空機への適用を証明できません。データセット、独立テスト、制約確認、別のシミュレーションや実験が必要です。リンク先の論文は数値・制御・ロボット基準を報告しており、翼型設計の定量的な成果を裏付けるものではありません。
結論と展望
一つのベンチマークと評価履歴を保存します。同じ評価予算で学習による提案を基準手法と比較し、モデル訓練時間は別に記録します。 EvoGM:再トレーニング不要で、集団進化による大規模モデルの自律的マージ
関連資料
論文タイトルと著者