Mit einer AMD-GPU sollte sich EvoGPs baumbasierte genetische Programmierung ohne separaten Suchmotor nutzen lassen. PR #12, am 17. Juni 2026 UTC zusammengeführt (18. Juni in Peking), eröffnet diesen Weg über ROCm/HIP. Die Änderung betrifft sowohl den Bau der Erweiterung als auch die Bedeutung jedes ausgeführten Programms.
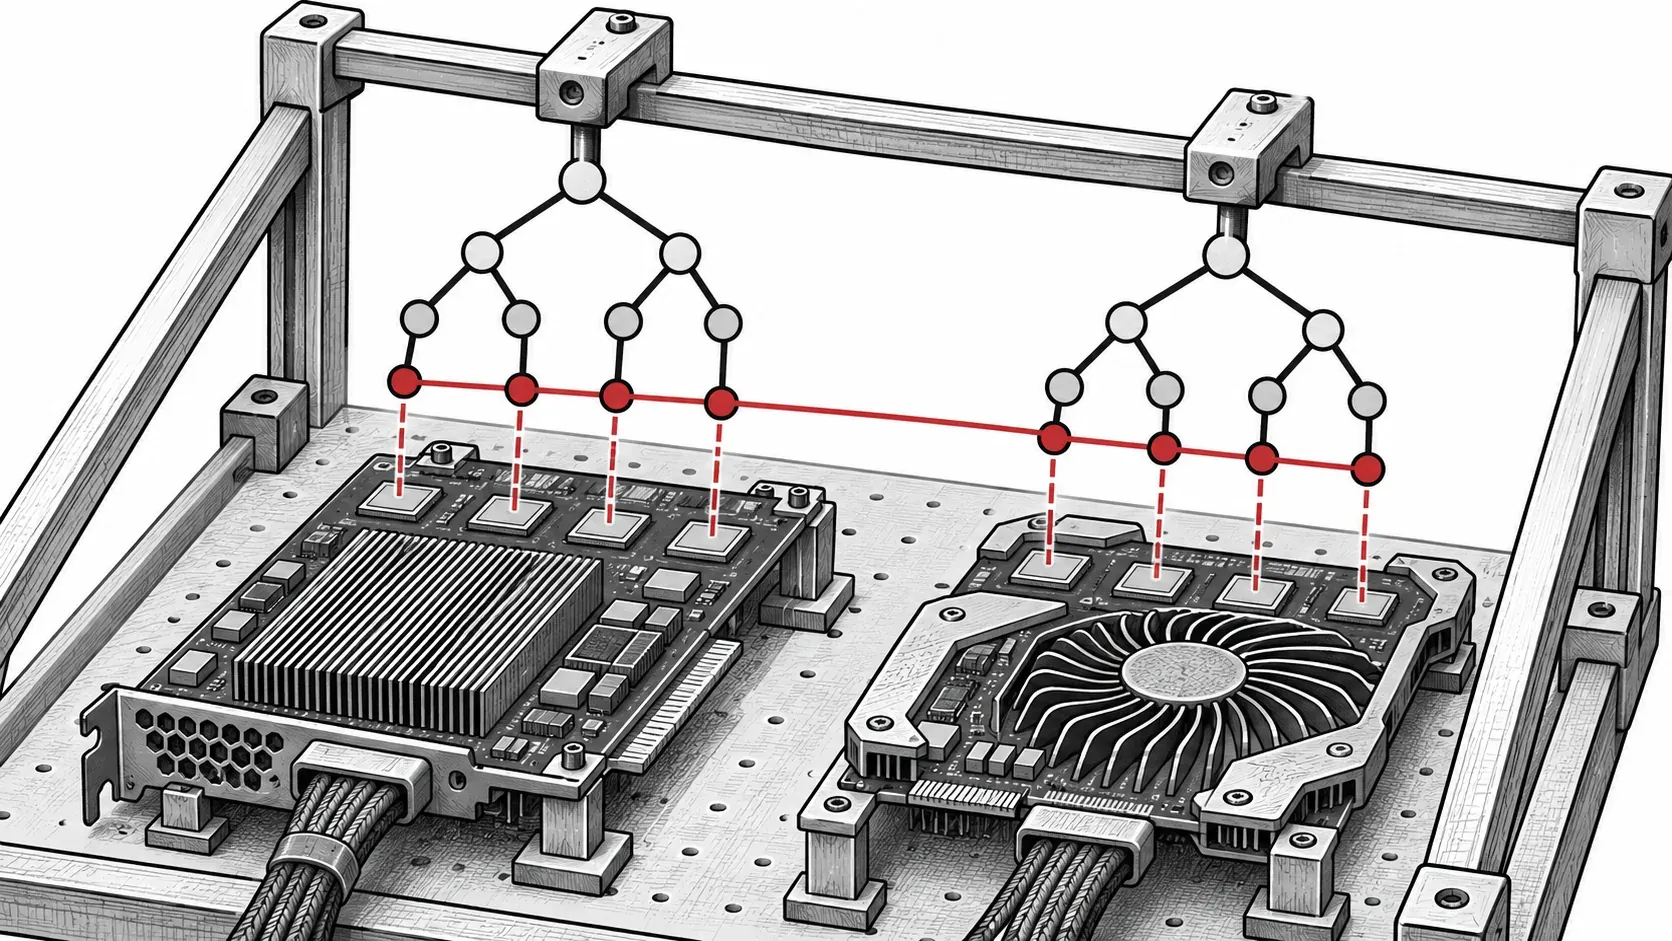
Konzeptillustration: Dieselbe Programmdarstellung überschreitet GPU-Backend-Grenzen.
Eine Quellbasis für CUDA und ROCm
Die Juni-Integration verwendet PyTorchs HIP-Konvertierung beim Build für AMD. Compileroptionen richten sich nach dem Backend, ein CUDA-spezifischer Header wird geschützt. Mit ROCm-PyTorch lässt sich die Erweiterung bauen, ohne einen zweiten Algorithmusbestand zu pflegen.
Dynamische Gerätestacks in den Bauminterpretern werden durch lokale Arrays fester Größe ersetzt. Der Beitrag führt falsche AMD-Ergebnisse auf Speicher-Aliasing zwischen gleichzeitig aktiven Wavefronts zurück. Getrennte Threadstacks sind entscheidend: Fremder temporärer Zustand kann Fitnesswerte verfälschen und damit die Auswahl beeinträchtigen.
Kernelquellen zu übersetzen reicht nicht aus
PyTorchs HIP-Konvertierung übersetzt CUDA-Quellen, doch Compilerargumente gelangen weiterhin zum Gerätecompiler. NVIDIA-Optionen lassen sich nicht einfach an hipcc übergeben. Der Build behält die CUDA-Liste und verwendet im ROCm-Zweig -O3; ein CUDA-spezifischer Header wird gesondert geschützt. ROCm PyTorch stellt die Konvertierung bereit, aber EvoGP muss auch seine Build-Konfiguration anpassen. Build-Änderungen
Die Build-Umgebung an das Backend anpassen
Die Quellanleitung verlangt GPU-Werkzeuge, C++-Compiler und ein passendes PyTorch. Für AMD sind dies ROCm mit hipcc und ROCm-PyTorch. --no-build-isolation nutzt beim Erweiterungsbau die installierte PyTorch-Umgebung.
Die Beispiele behalten unter ROCm die Gerätezeichenfolge cuda, entsprechend der PyTorch-Schnittstelle. PYTORCH_ROCM_ARCH wählt eine konkrete AMD-Architektur. Dies ist eine Build-Entscheidung, keine Neuschreibung der Baumdarstellung oder evolutionären Operatoren.
Dieselbe Suche auf einem geprüften Backend ausführen
Der Beitrag berichtet symbolische Regression auf MI250X, W7800, RX 9070 XT und PRO V710; Betriebssysteme und ROCm-Versionen stehen im PR. Verwendet wurden 1.000 Individuen, 100 Generationen und ein fester Seed. Das sind gemeldete Prüfungen dieser Konfigurationen, keine hardwareunabhängige Leistungszusage.
python -m evogp.sr_testPrüfen Sie für symbolische Regression zuerst den Build und den erfolgreichen Abschluss des kleinen Regressionstests mit endlicher Fitness. Die Prüfungen des Beitrags decken wave32 und wave64 ab und berichten übereinstimmende Verläufe bei festem Seed, keine neue allgemeine Beschleunigungszusage. Halten Sie bei eigenen Hardwarevergleichen Datensatz, Population und Seed konstant. Der EvoGP-Überblick erklärt die Programmrepräsentation; die spätere Reporting-Korrektur betrifft eine andere Ursache von Generationskosten.