使用 AMD GPU 的研究者,无需另行维护搜索引擎,也能探索 EvoGP 的树式遗传编程。PR #12 于 2026 年 6 月 17 日 UTC(北京时间 6 月 18 日)合入,通过 ROCm/HIP 打通这条路径。变化既涉及扩展如何构建,也涉及程序执行时如何保持原有语义。
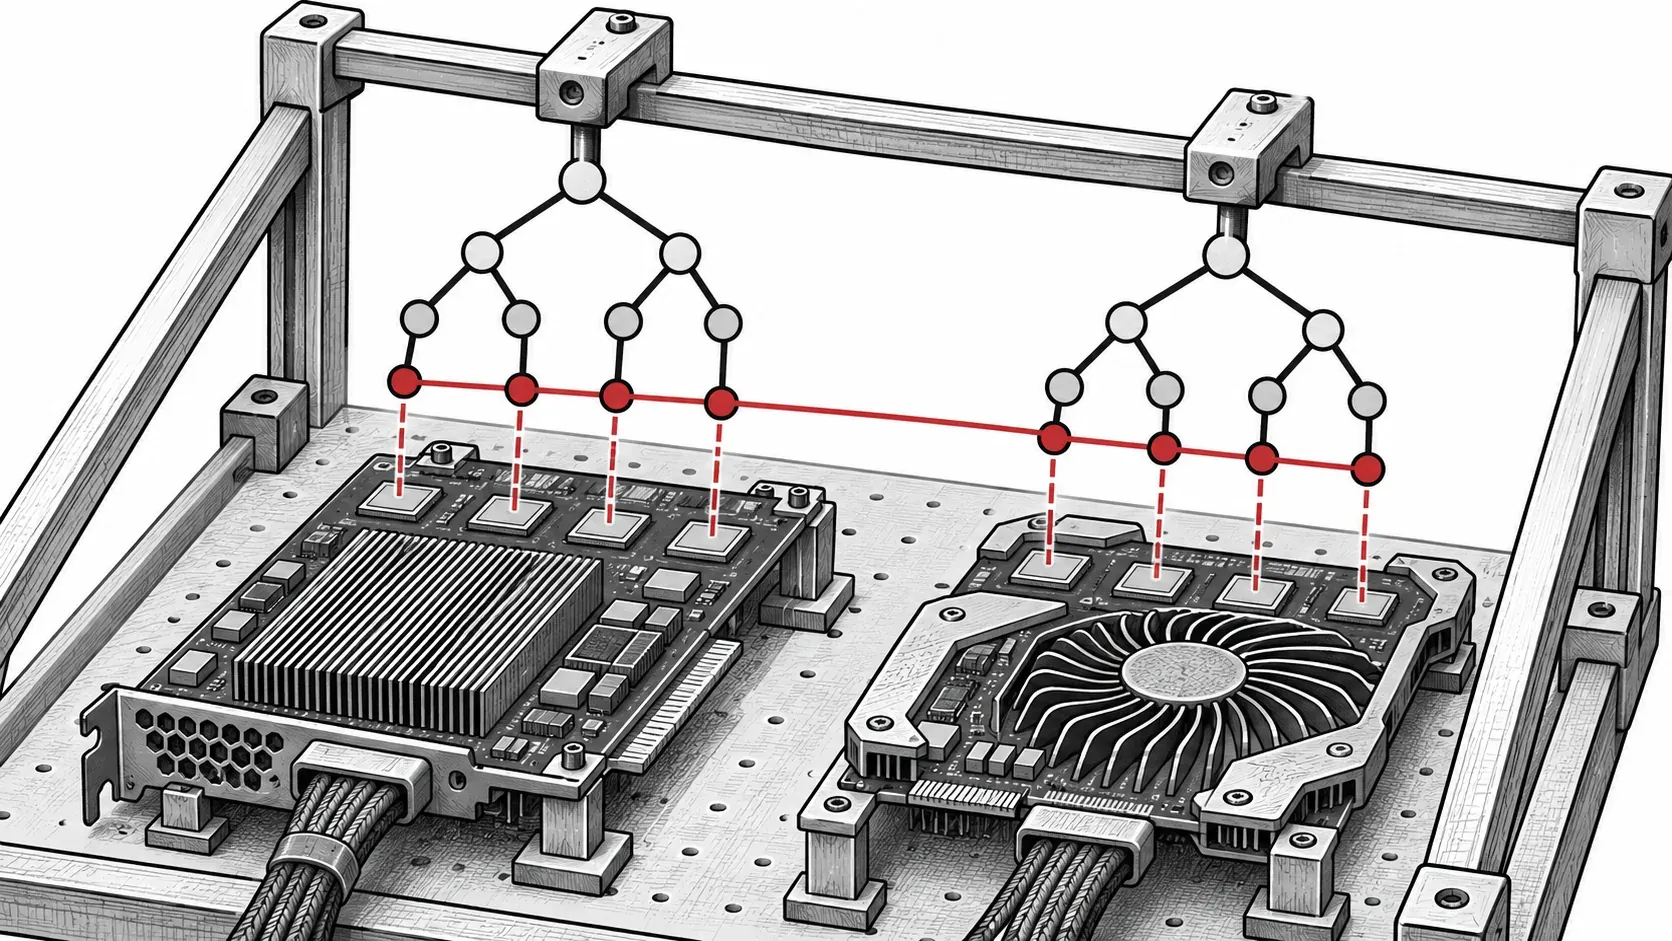
概念插画:同一种程序表示跨越 GPU 后端边界。
CUDA 与 ROCm 共用源码
6 月的集成使用 PyTorch 在构建时进行 HIP 转换,将 EvoGP 的 CUDA 扩展源码编译到 AMD GPU。编译参数按后端选择,并保护仅属于 CUDA 的头文件,避免破坏 HIP 构建。安装 ROCm 版 PyTorch 后,用户无需维护另一套算法实现即可构建扩展。
该工作还将树解释器中的动态设备栈分配替换为固定大小的局部数组。贡献者将 AMD 上的错误执行追溯到驻留 wavefront 之间的分配别名问题。每个线程的栈必须独立:若一棵程序树使用了其他线程的临时状态,适应度可能错误,继而影响选择。
转换内核源码只是构建的一部分
PyTorch 的 HIP 转换会处理 CUDA 源码,但编译参数仍会传给设备编译器,面向 NVIDIA 编译器的选项不能直接交给 hipcc。合入后的构建按后端选择参数:CUDA 保留原列表,ROCm 分支采用 -O3,并单独保护仅属于 CUDA 的头文件。这些是具体的构建边界:ROCm PyTorch 提供转换路径,EvoGP 仍需让自身构建配置与之兼容。构建改动
按后端准备构建环境
源码安装说明 要求适合的 GPU 工具链、C++ 编译器和匹配的 PyTorch。AMD 路径使用包含 hipcc 的 ROCm 及 ROCm PyTorch,然后以 --no-build-isolation 从源码构建 EvoGP,让扩展使用已安装的 PyTorch 环境。
ROCm 下的示例仍使用 cuda 设备字符串,这是 PyTorch 对这些设备提供的接口。需要指定 AMD 架构时,使用 PYTORCH_ROCM_ARCH 控制目标。这个选择属于构建配置,无需重写树表示或演化算子。
在已验证的后端运行同一搜索
贡献者报告在 AMD MI250X、W7800、RX 9070 XT 和 PRO V710 上完成符号回归检查,具体操作系统及 ROCm 版本列于 PR。检查采用 1,000 个体、100 代和固定种子,属于这些配置下的项目报告结果,不能外推为与硬件无关的性能保证。
python -m evogp.sr_test开展符号回归实验前,先确认扩展能够构建、小型回归检查能以有限适应度正常完成。贡献者的检查覆盖 wave32 和 wave64 设备,报告的是固定种子轨迹吻合,而非新的通用加速结论。此后比较自己的硬件时,应保留相同数据集、种群和种子。EvoGP 介绍 解释程序表示,后续的种群报告修正 则针对另一类整代开销。