AMD GPU を使う研究者も、別の探索エンジンを維持せずに EvoGP の木構造遺伝的プログラミングを試せます。2026 年 6 月 17 日 UTC(北京時間 6 月 18 日)にマージされた PR #12 は、ROCm/HIP による経路を追加しました。拡張のビルドと、実行時に各プログラムの意味を保つことの両方が対象です。
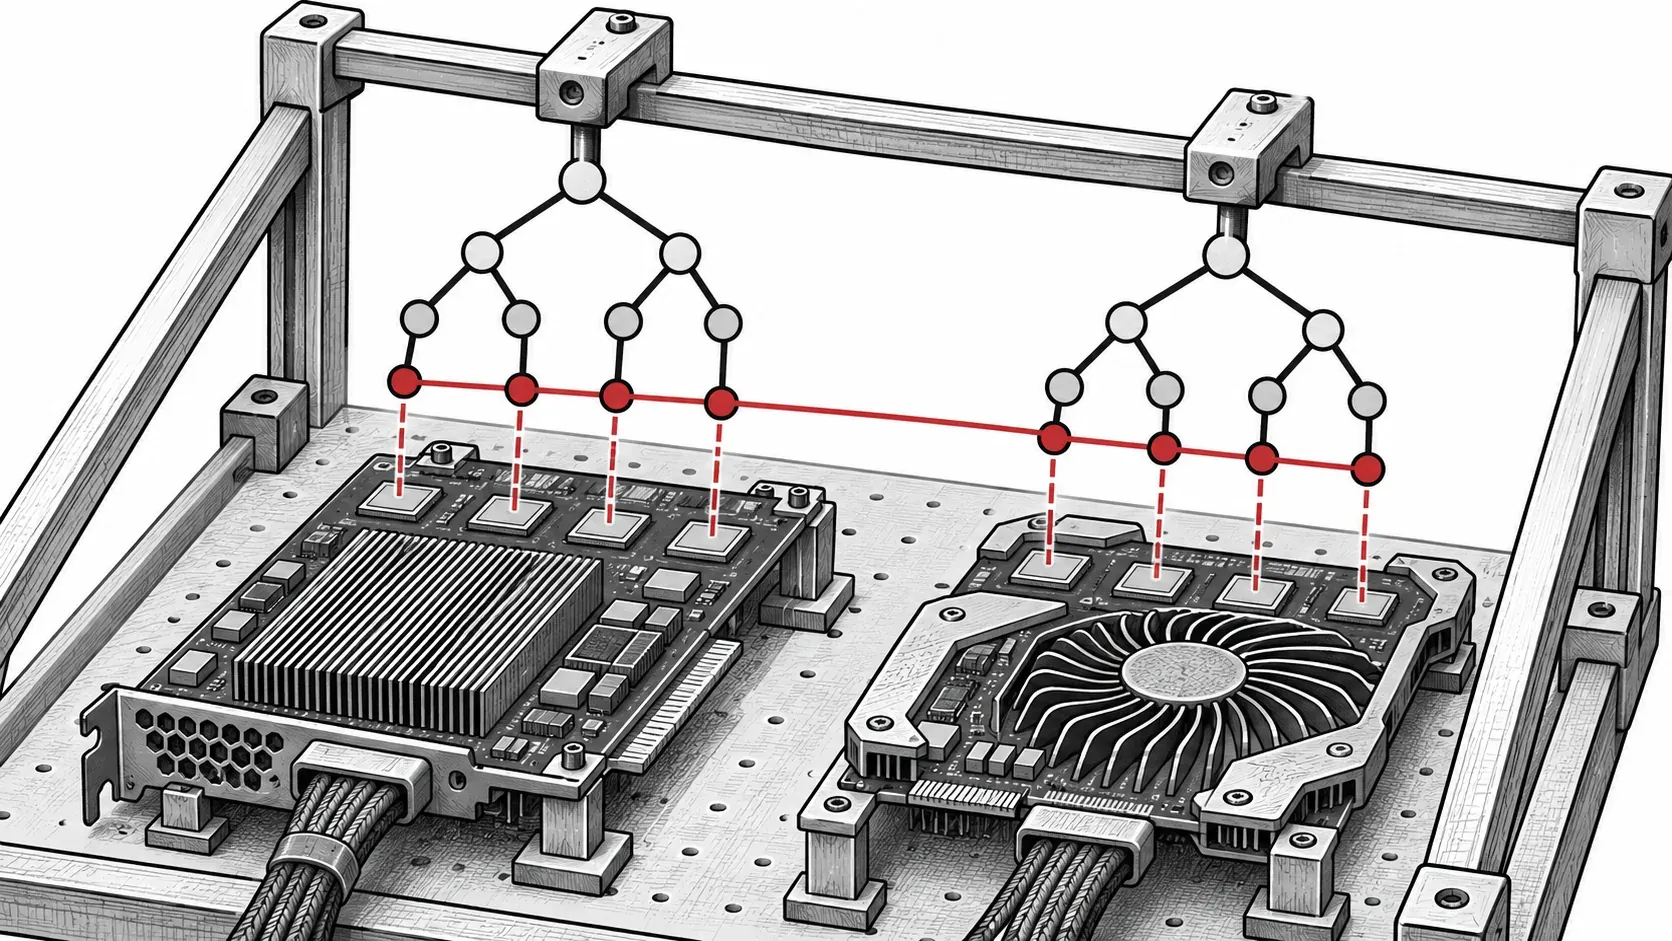
概念図:同じプログラム表現が GPU バックエンドをまたぎます。
CUDA と ROCm で同じソースを使う
6 月の統合は PyTorch のビルド時 HIP 変換を使い、CUDA 拡張ソースを AMD GPU 向けにコンパイルします。バックエンド別のコンパイル設定と CUDA 専用ヘッダーの保護により、HIP ビルドを可能にします。ROCm 版 PyTorch があれば別のアルゴリズム実装を維持する必要がありません。
木インタープリターの動的デバイススタック割当ても固定長のローカル配列に変更しました。貢献者は AMD の誤動作を、同時常駐する wavefront 間の割当ての別名化に追跡しました。他スレッドの一時状態を使えば適応度が誤り、選択も損なわれるため、スレッドごとの分離が重要です。
カーネルの変換だけではビルドは完結しない
PyTorch の HIP 変換は CUDA ソースを処理しますが、コンパイル引数はデバイスコンパイラーに届きます。NVIDIA 向けのオプションをそのまま hipcc に渡すことはできません。変更後は CUDA の引数リストを維持し、ROCm 側には -O3 を使い、CUDA 専用ヘッダーも個別に保護します。ROCm PyTorch が変換経路を提供しても、EvoGP のビルド設定を対応させる必要があります。ビルド変更
バックエンドに合わせてビルドする
ソース導入説明 は GPU ツールチェーン、C++ コンパイラー、対応する PyTorch を要求します。AMD では hipcc を含む ROCm と ROCm PyTorch を使います。--no-build-isolation でソースから構築すると、導入済み PyTorch 環境で拡張をビルドできます。
ROCm でも例のデバイス文字列は cuda のままです。これは PyTorch のインターフェースです。特定の AMD アーキテクチャーは PYTORCH_ROCM_ARCH で指定します。これはビルド設定であり、木表現や進化演算子を書き換える要求ではありません。
確認したバックエンドで同じ探索を動かす
PR は AMD MI250X、W7800、RX 9070 XT、PRO V710 での記号回帰検証を報告し、OS と ROCm 版を記載しています。1,000 個体、100 世代、固定シードの実行であり、その構成についてのプロジェクト報告です。全ハードウェアでの性能保証ではありません。
python -m evogp.sr_test数式回帰では、まず拡張がビルドでき、小規模な回帰チェックが有限の適応度で完了することを確認します。投稿者の確認は wave32 と wave64 の両方を含み、固定シードの軌跡の一致を報告しています。一般的な高速化の新たな主張ではありません。自身のハードウェアを比較する際もデータ、集団、シードを維持してください。EvoGP の概要 はプログラム表現を、後の集団レポート修正は別の世代処理コストを説明します。