Chi usa una GPU AMD può esplorare la programmazione genetica ad albero di EvoGP senza mantenere un altro motore di ricerca. La PR #12, integrata il 17 giugno 2026 UTC (18 giugno a Pechino), apre questa strada tramite ROCm/HIP. Riguarda sia la compilazione dell’estensione sia il significato dei programmi durante l’esecuzione.
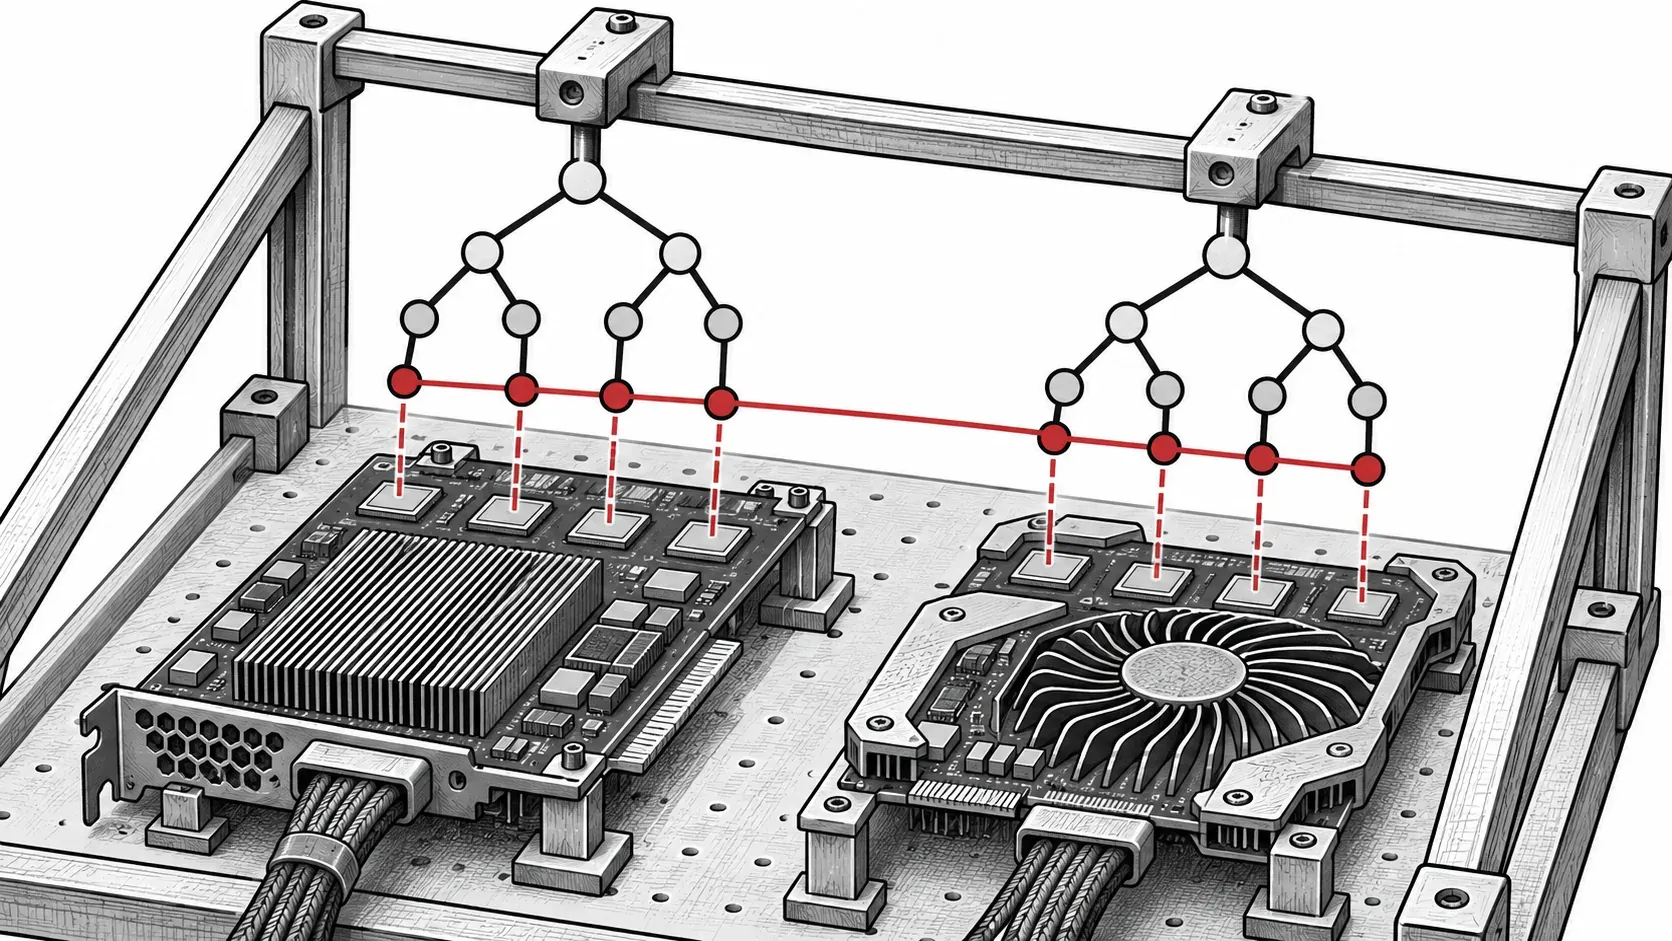
Illustrazione concettuale: la stessa rappresentazione attraversa i backend GPU.
Una base sorgente per CUDA e ROCm
L’integrazione di giugno sfrutta la conversione HIP di PyTorch durante il build per compilare le estensioni CUDA su AMD. Seleziona le opzioni per backend e protegge un header esclusivo di CUDA. Con PyTorch ROCm non serve mantenere un’altra implementazione degli algoritmi.
L’allocazione dinamica degli stack degli interpreti viene sostituita da array locali fissi. Il contributore collega gli errori AMD all’aliasing delle allocazioni tra wavefront residenti. Separare gli stack è essenziale: usare lo stato temporaneo di un altro thread può falsare fitness e selezione.
Tradurre i kernel è solo una parte del lavoro
La conversione HIP di PyTorch traduce i sorgenti CUDA, ma gli argomenti arrivano comunque al compilatore del dispositivo. Le opzioni NVIDIA non possono passare direttamente a hipcc. La configurazione mantiene la lista CUDA e usa -O3 nel ramo ROCm; protegge inoltre un header esclusivo di CUDA. ROCm PyTorch fornisce la conversione, mentre EvoGP deve rendere compatibile anche la configurazione di compilazione. Modifiche alla compilazione
Preparare l’ambiente del backend
Le istruzioni sorgente richiedono strumenti GPU, compilatore C++ e PyTorch compatibili. Su AMD servono ROCm con hipcc e PyTorch ROCm. Il build con --no-build-isolation usa l’ambiente PyTorch già installato.
Gli esempi mantengono le stringhe dispositivo cuda sotto ROCm perché è l’interfaccia PyTorch. PYTORCH_ROCM_ARCH seleziona un’architettura AMD precisa. È una configurazione di build, non una riscrittura degli alberi o degli operatori evolutivi.
Eseguire la stessa ricerca su un backend verificato
Il contributore riporta controlli di regressione simbolica su MI250X, W7800, RX 9070 XT e PRO V710, con sistemi e versioni ROCm elencati nella PR. Usano 1.000 individui, 100 generazioni e seme fisso: sono verifiche riferite a tali configurazioni, non garanzie generali sulle prestazioni.
python -m evogp.sr_testPer la regressione simbolica, verifichi prima che l’estensione compili e che il piccolo test termini con fitness finita. Le verifiche del contributore coprono dispositivi wave32 e wave64 e riportano traiettorie coincidenti a seme fisso, non un nuovo aumento universale di velocità. Mantenga poi dati, popolazione e seme per confrontare il proprio hardware. La presentazione di EvoGP spiega la rappresentazione; la successiva correzione del reporting affronta un costo diverso della generazione.