Ein Netz kann während der Suche gewinnen und nach eigenständigem Training enttäuschen. Für evolutionäre Suche ist das teuer: Jede Generation nutzt frühere Bewertungen, um die nächsten Kandidaten auszuwählen. Verzerrte Rangfolgen können eine längere Suche in die falsche Richtung führen. EvoNAS verbindet das Lernen des Supernetzes, die Bewertung der Kandidaten und die Abwägung von Genauigkeit und Rechenaufwand.
Die Suche braucht verlässliche Bewertungen
Jeden Kandidaten einzeln zu trainieren wäre kostspielig. Gemeinsame Gewichte ersparen den Neustart, koppeln aber auch das Lernen. Die Architektur, die am stärksten von geteilten Parametern profitiert, muss nach eigenständigem Training nicht die beste sein. Da die Auswahl die nächste Generation bestimmt, kann ein verzerrter Vergleich die gesamte Suche umlenken.
Ein Supernetz teilt Parameter zwischen Architekturen. Die Leistung mit übernommenen Gewichten muss jedoch nicht das Potenzial eines Kandidaten widerspiegeln. Die am 20. März 2026 eingereichte Arbeit schlägt ein hybrides VSS–ViT-Supernetz und CA-DDKD vor, das Repräsentationen im Raum- und Frequenzbereich ausrichtet. PST erweitert das Training schrittweise von großen zu kompakten Konfigurationen.
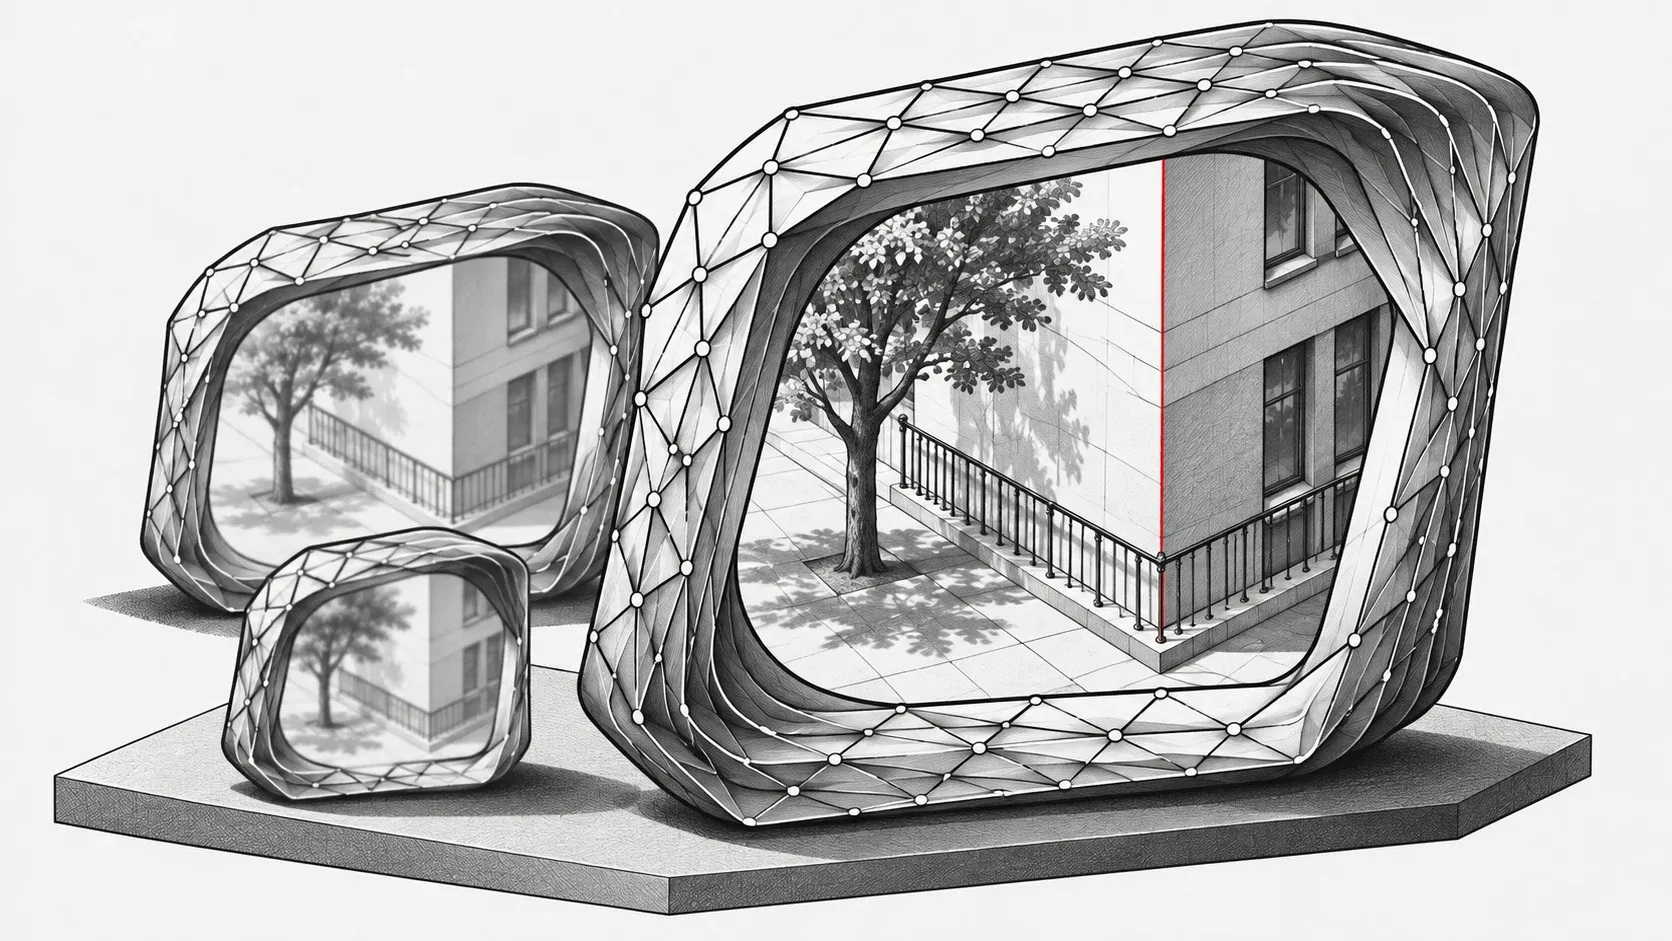
Ein Gebäude zu erkennen ist etwas anderes, als seine Grenze genau zu bestimmen. Bei Tiefenschätzung und Segmentierung können ein dünnes Geländer, eine Mauerecke oder die Grenze zum Hintergrund entscheidend sein. CA-DDKD nutzt Bedingungen auf Basis der diskreten Kosinustransformation, um solche geometrischen Details zu erhalten. Räumliche Position und die Veränderungen, die Kanten und Texturen bilden, ergänzen sich.
Damit wird die Trainingsstrategie Teil der Suchmethode. Bessere gemeinsame Repräsentationen verbessern die Vergleichsgrundlage. Allein mehr Kandidaten zu prüfen repariert keine unzuverlässige Rangfolge.
Kandidaten unter gleichen Bedingungen vergleichen
Bei der Tiefenschätzung kann ein Genauigkeitskompromiss helfen, eine Latenzgrenze einzuhalten. Die Mehrzielsuche liefert dafür mehrere Optionen. DMMPE bewertet mehrere Modelle mit einem GPU-Ressourcenpool und asynchroner Planung. Für die Auswahl sind die konkrete Hardware, der Datensatz und das Messverfahren maßgeblich.
Kandidaten müssen unter vergleichbaren Hardware- und Laufzeitbedingungen gemessen werden. Die Suchkonfiguration bestimmt, was vielversprechend erscheint; erneutes Training zeigt, was die gewählte Architektur lernen kann. Diese Verbindung führt zurück zum Rangfolgeproblem von EvoNAS.
Vor dem ersten Experiment
Der Ablauf umfasst Vortraining auf ImageNet-1k, PST-Anpassung an die Zieldaten, evolutionäre Suche und erneutes Training des ausgewählten Teilnetzes. Dokumentiert sind KITTI und NYU Depth v2 für Tiefenschätzung, COCO für Erkennung und ADE20K für Segmentierung. Prüfen Sie für einen Datensatz Datenpfade, Trainingskonfigurationen und Suchziele gemeinsam, um Suchbewertung und endgültiges Modell zu verbinden.
Das README kündigt den benötigten vortrainierten Supernetz-Download weiterhin an. Prüfen Sie vor dem Start die Verfügbarkeit der Gewichte und passen Sie das Mamba-SSM-Wheel an die dokumentierte Python-, CUDA- und PyTorch-Umgebung an.