适应既可以发生在解的层面,也可以发生在系统寻找解的方式上。MetaDE 通过两个相互连接的演化层次,将这一思路带入 EvoX:内层解决目标问题,外层评价哪些 DE 配置能够让搜索更有效。 MetaDE
背景
在演化计算领域,算法的性能往往受到超参数选择的显著影响。确定针对特定问题的最合适参数设置一直是一个长期的研究挑战。差分演化(DE)作为一种经典的演化算法,因其简单性和强大的全局搜索能力而广受青睐;然而,其性能对超参数的选择高度敏感。传统方法通常依赖于基于经验的调优或自适应机制来提高性能。但是,面对多样化的问题场景,这些方法往往难以在效率和广泛适用性之间取得平衡。
“元演化”(Meta-Evolution)的概念早在上个世纪就已被提出,旨在利用演化算法本身来优化这些算法的超参数配置。虽然元演化已存在多年,但其实际应用一直受到高计算需求的限制。GPU 计算的最新进展缓解了这些限制,为演化算法提供了强大的硬件支持。特别是分布式 GPU 加速 EvoX 框架的推出,极大地促进了基于 GPU 的演化算法的发展。在此背景下,我们的研究团队提出了一种新颖的元演化方法,利用 DE 来演化其自身的超参数和策略,从而为解决演化算法中长期存在的参数调优问题提供了一条新途径。
什么是元演化?
元演化用演化算法搜索另一层演化算法的配置。
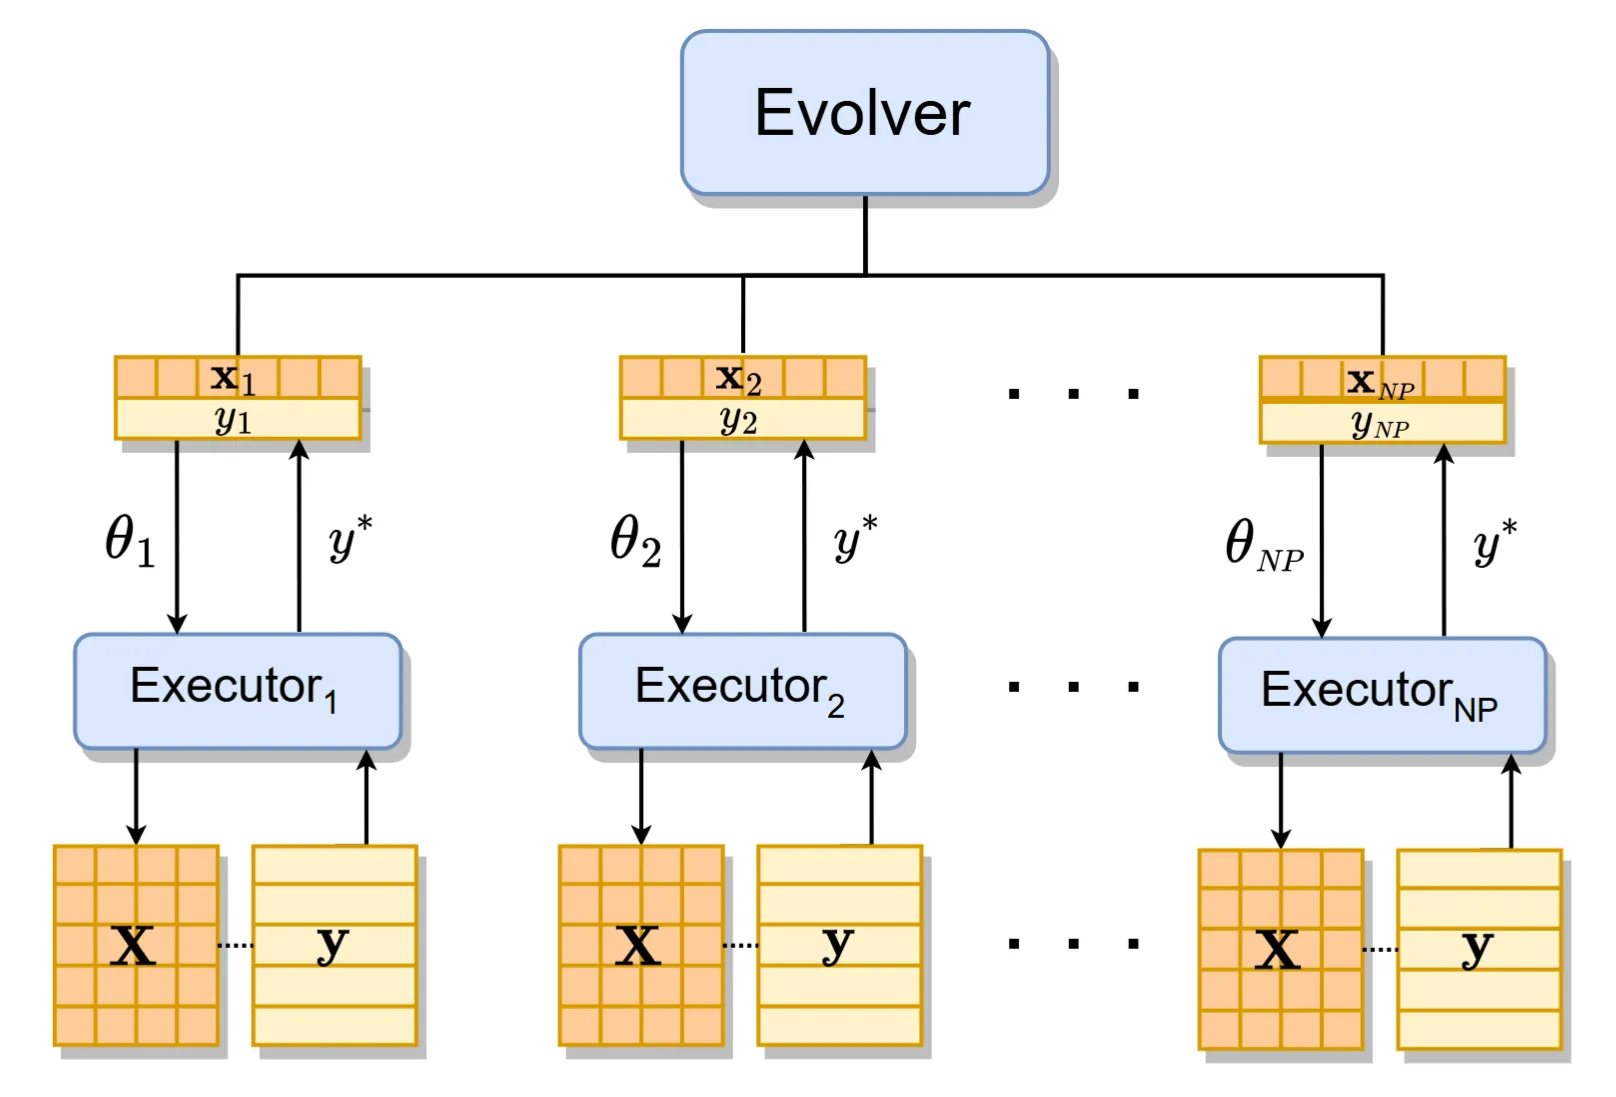
MetaDE 采用双层结构:下层的**执行器(executor)使用参数化 DE 求解目标问题,上层的演化器(evolver)**使用 DE 搜索执行器的参数与策略。执行器的优化表现为上层搜索提供反馈,GPU 批量计算则用于并行评价多组配置。
算法实现
MetaDE 采用基于张量的技术和 GPU 加速来实现高效的并行计算。通过同时处理种群中的许多个体,整体计算效率得到显著提高,这在单目标黑盒优化和大规模优化问题中尤为有利。通过对关键参数和数据结构(如种群、适应度、策略参数)进行张量化,MetaDE 不仅实现了更高的计算效率,还增强了其应对复杂优化挑战的能力。与经典 DE 和其他演化算法(EAs)相比,MetaDE 在解决大规模问题时表现出卓越的性能。得益于基于张量的方法,MetaDE 能更有效地利用计算资源,产生比传统方法更快的解决方案和更精确的优化结果。
PDE 架构
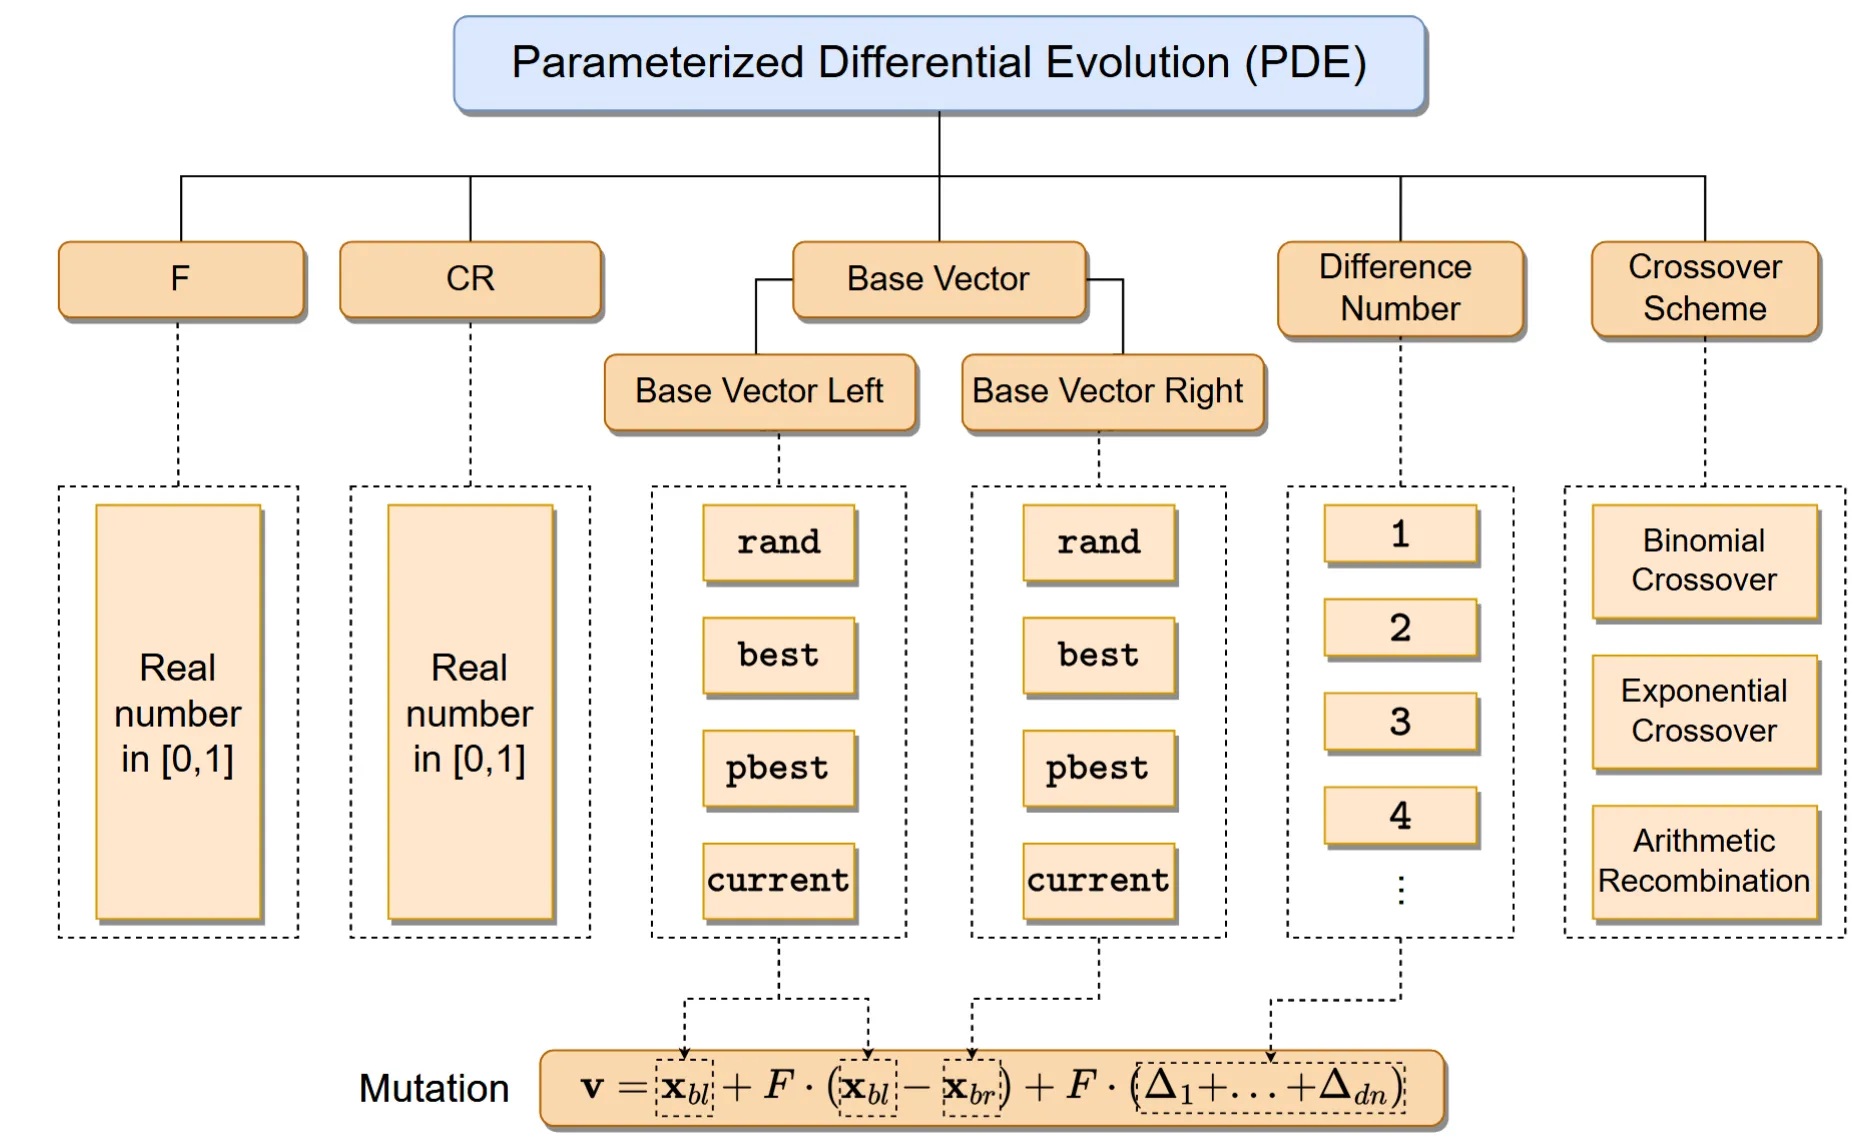
研究团队首先提出了一个完全支持参数和策略修改的参数化 DE 算法框架(PDE)。在这个框架中,F 和 CR 是连续参数,而其他参数是离散的。虚线框表示允许的参数值范围。变异函数源自左右基向量,以及控制差分向量数量的参数。
MetaDE 架构
MetaDE 采用双层结构,包含一个演化器(上层)和多个执行器(下层)。演化器是一个 DE(或者是其他演化算法),负责优化 PDE 的参数。演化器种群中的每个个体 x_i 对应一个唯一的参数配置 θ_i。这些配置被传递给 PDE 以实例化不同的 DE 变体,每个变体由一个执行器管理,并在给定的优化任务上独立运行。每个执行器将其最佳适应度值 y^* 返回给演化器,演化器将该适应度值 y_i 分配给相应的个体 x_i。
实验性能
为了全面评估 MetaDE 的有效性,研究团队在多个基准测试和现实场景中进行了系统实验。每个实验都使用了一个演化器(采用 rand/1/bin 策略的 DE)和多个执行器(种群大小为 100 的 PDE)。关键实验部分包括:
CEC2022 基准测试
在单目标优化任务中将 MetaDE 与各种 DE 变体进行比较。
与 CEC2022 前四名算法的比较
在相同的函数评估次数(FEs)预算下,评估 MetaDE 与 CEC2022 竞赛中表现最好的四种算法的性能。
固定物理时间下的函数评估次数(FEs)
分析 MetaDE 在 GPU 加速下的计算效率。
机器人控制任务
将 MetaDE 应用于 Brax 平台环境中的机器人控制任务,以验证其实际效用。
CEC2022 基准测试:与主流 DE 变体的比较
团队在 CEC2022 基准测试集上将 MetaDE 与几种具有代表性的 DE 变体进行了比较,包括:
- 标准 DE (rand/1/bin)
- SaDE 和 JaDE (自适应 DE 算法)
- CoDE (策略集成 DE)
- SHADE 和 LSHADE-RSP (基于成功历史的自适应 DE)
- EDEV (集成 DE 变体)
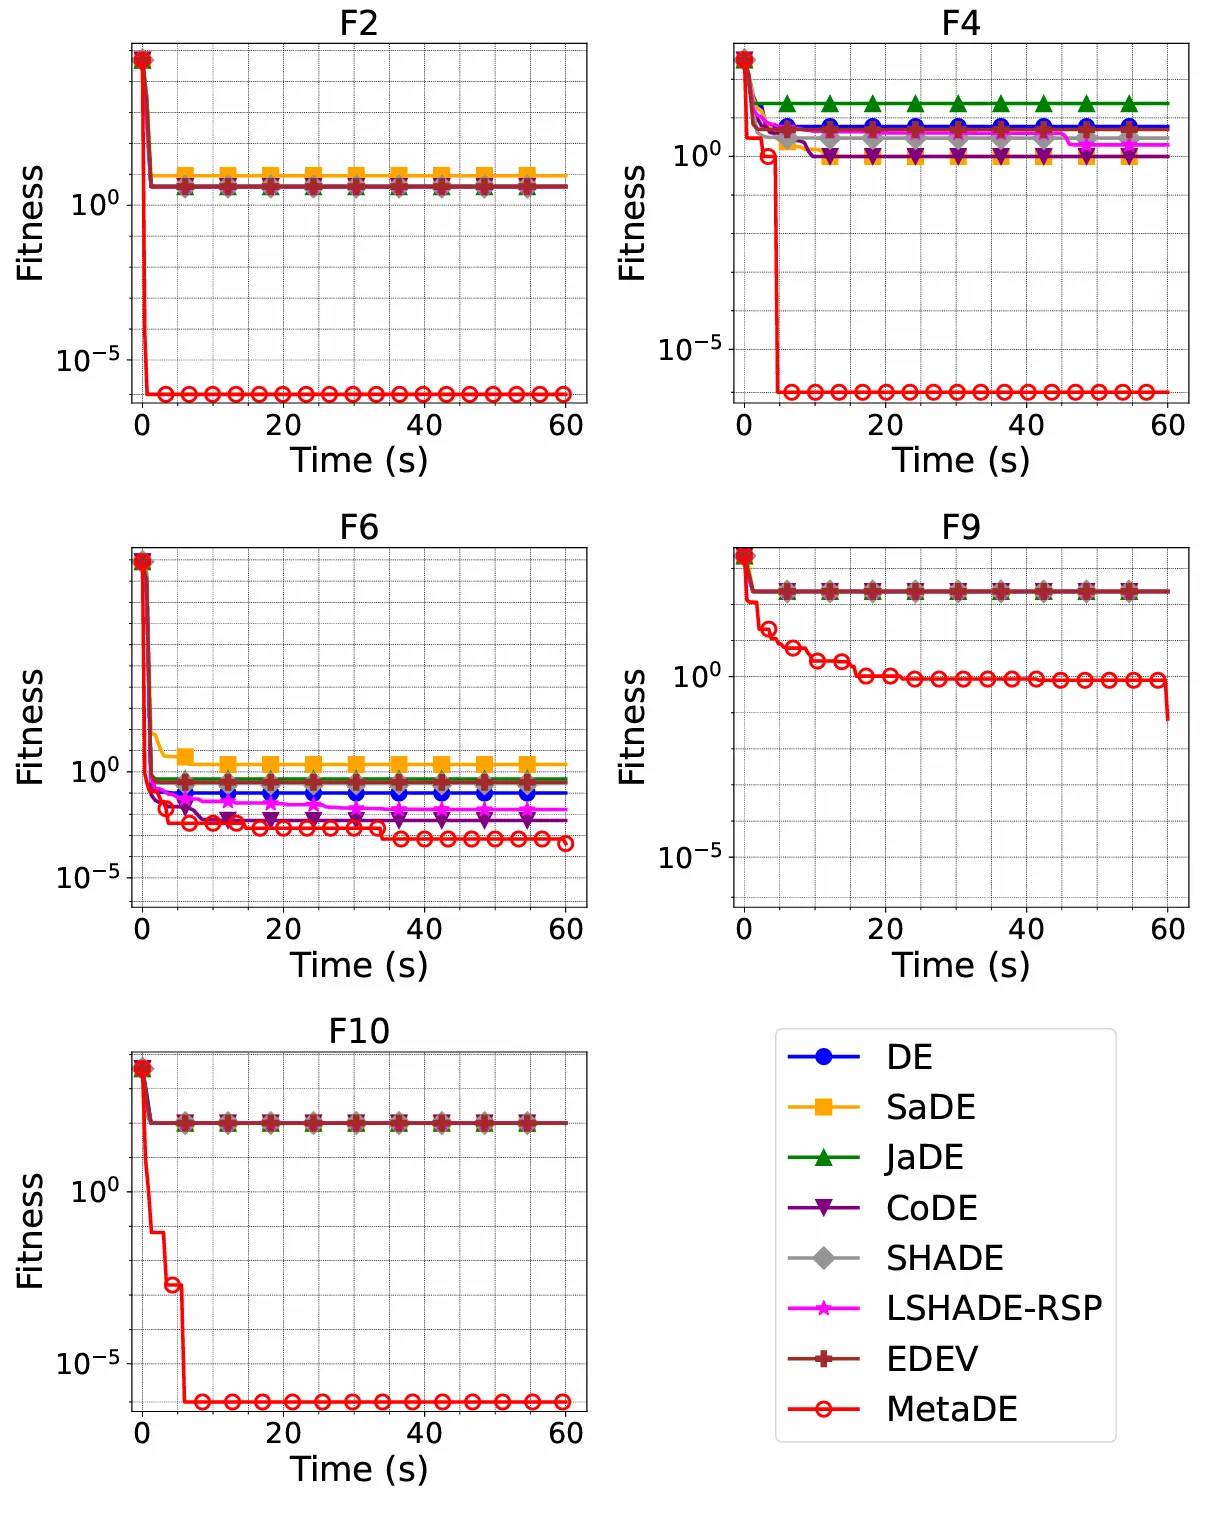
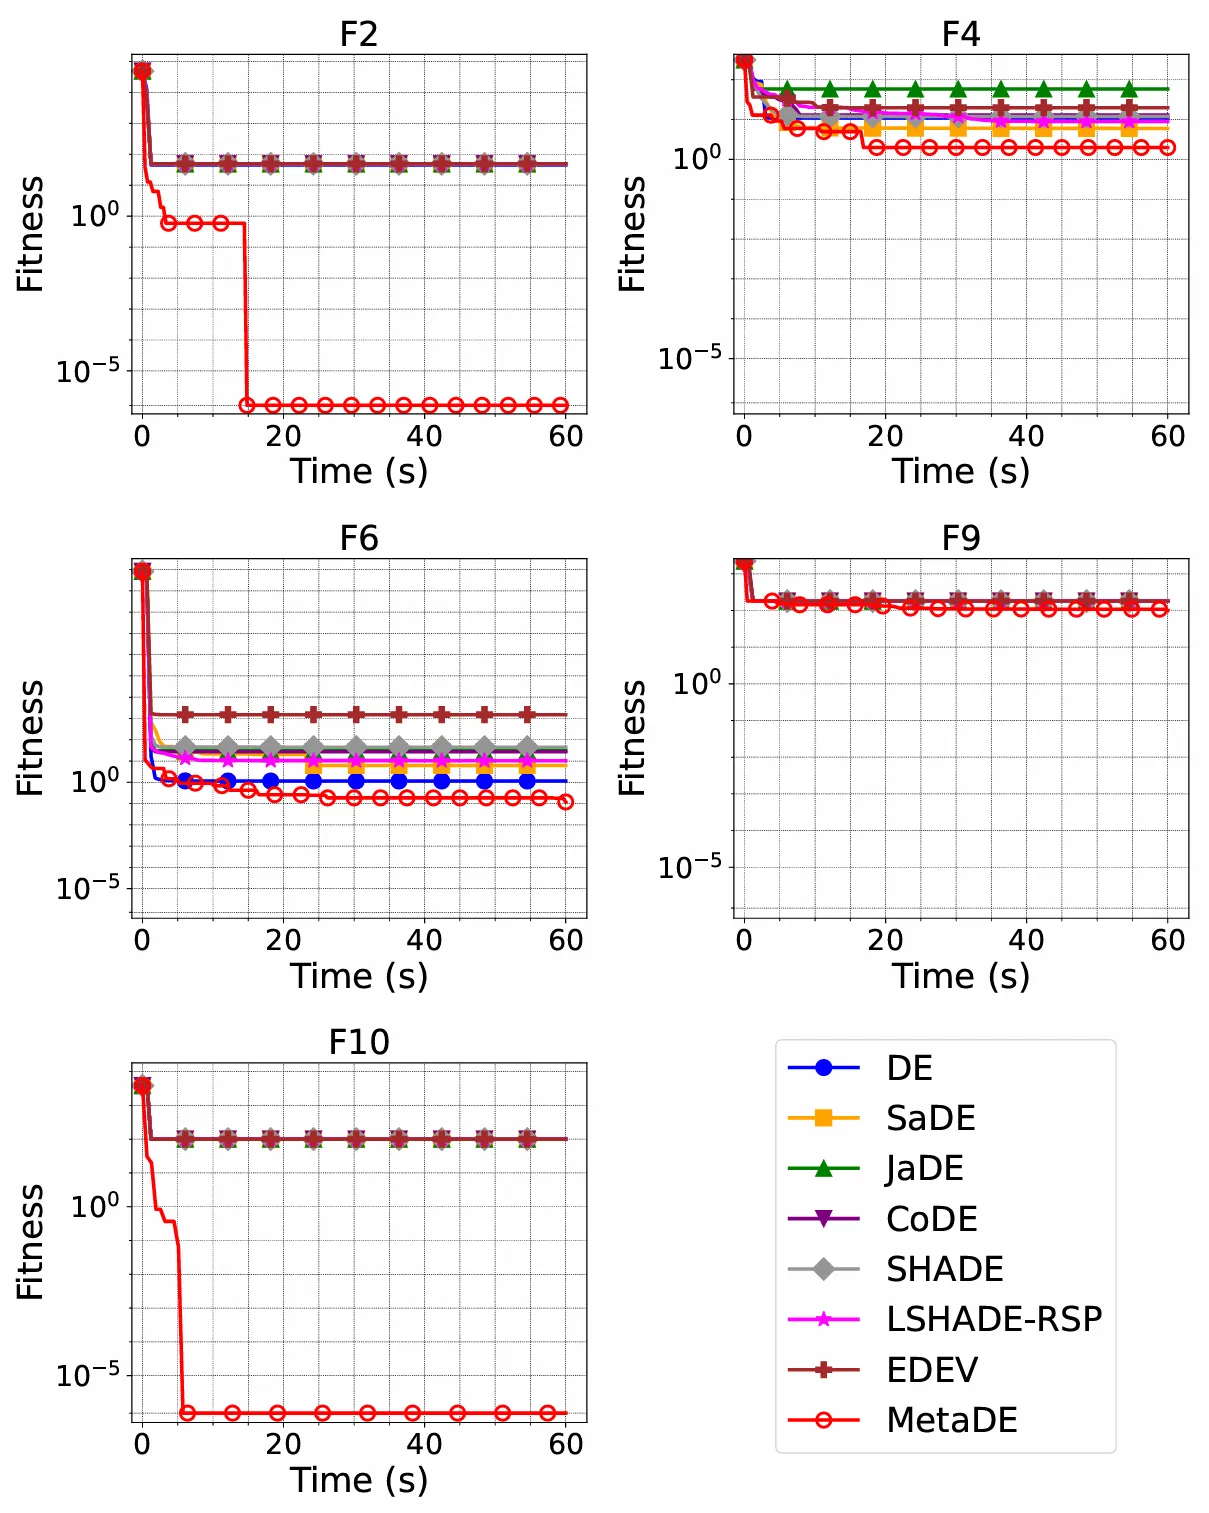
所有算法均在 EvoX 平台上实现,利用 GPU 加速,且为了公平起见,种群大小均为 100。实验在不同维度(10D 和 20D)下进行,并受到相同的计算时间限制(60 秒)。
10D CEC2022 优化结果
20D CEC2022 优化结果
MetaDE 在大多数测试函数上通常能实现更快速和稳定的收敛。其参数化 DE(PDE)结合上层优化,使其能够动态适应不同的问题空间,从而提高了整体鲁棒性和搜索性能。
与 CEC2022 前四名算法的比较(相同 FEs 下)
为了进一步评估 MetaDE 的优化能力,我们在相同的函数评估预算内将其与 CEC2022 竞赛的前四名算法进行了比较:
- EA4eig:一种集成多种 EA 的混合方法
- NL-SHADE-LBC:一种改进的自适应 DE
- NL-SHADE-RSP-MID:一种带有中点估计的增强型 SHADE
- S-LSHADE-DP:一种通过动态扰动保持种群多样性的 DE 变体
这些算法均使用其官方参数设置和源代码在相同的 FE 约束下运行。我们在 CEC2022 测试套件上对 MetaDE 和每个基线算法进行了统计比较(Wilcoxon 秩和检验,显著性水平 0.05)。
表格的最后一行显示了各算法在不同测试函数上与 MetaDE 相比的性能:+(显著更好),≈(无显著差异),和 −(显著更差)。
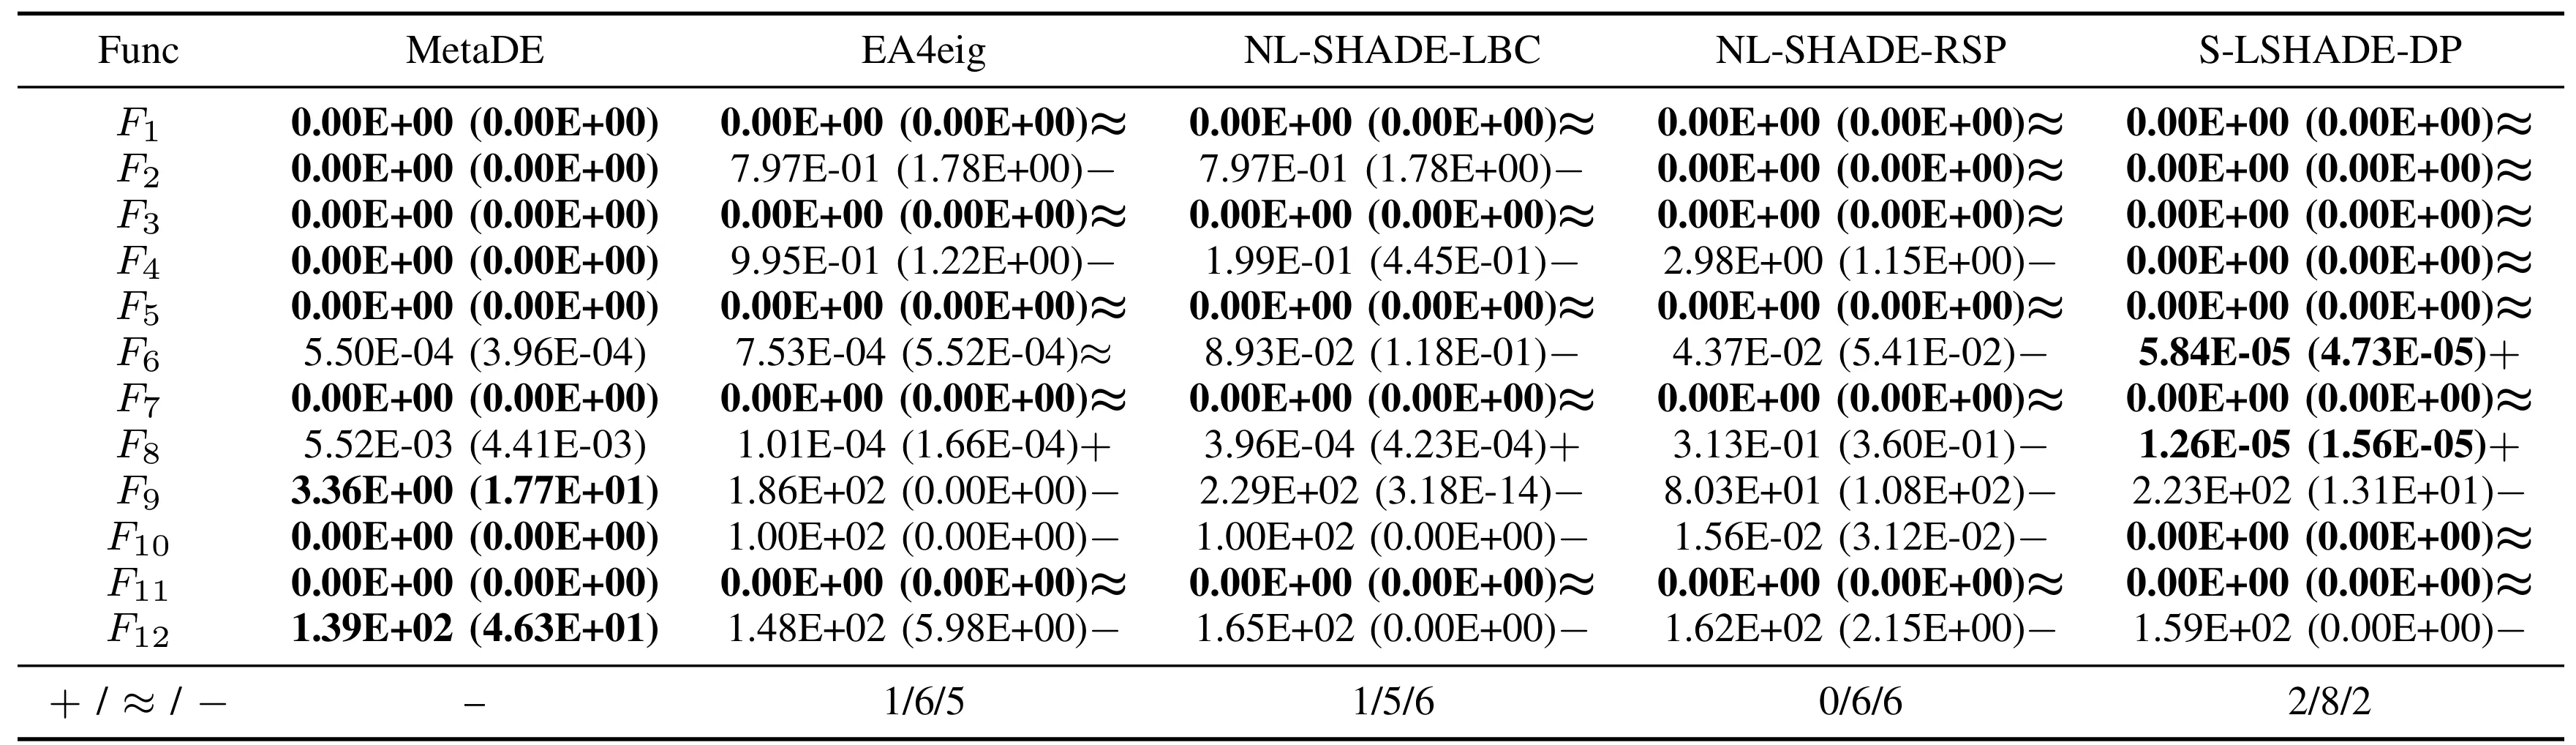
10D CEC2022 竞赛算法比较(相同 FEs)
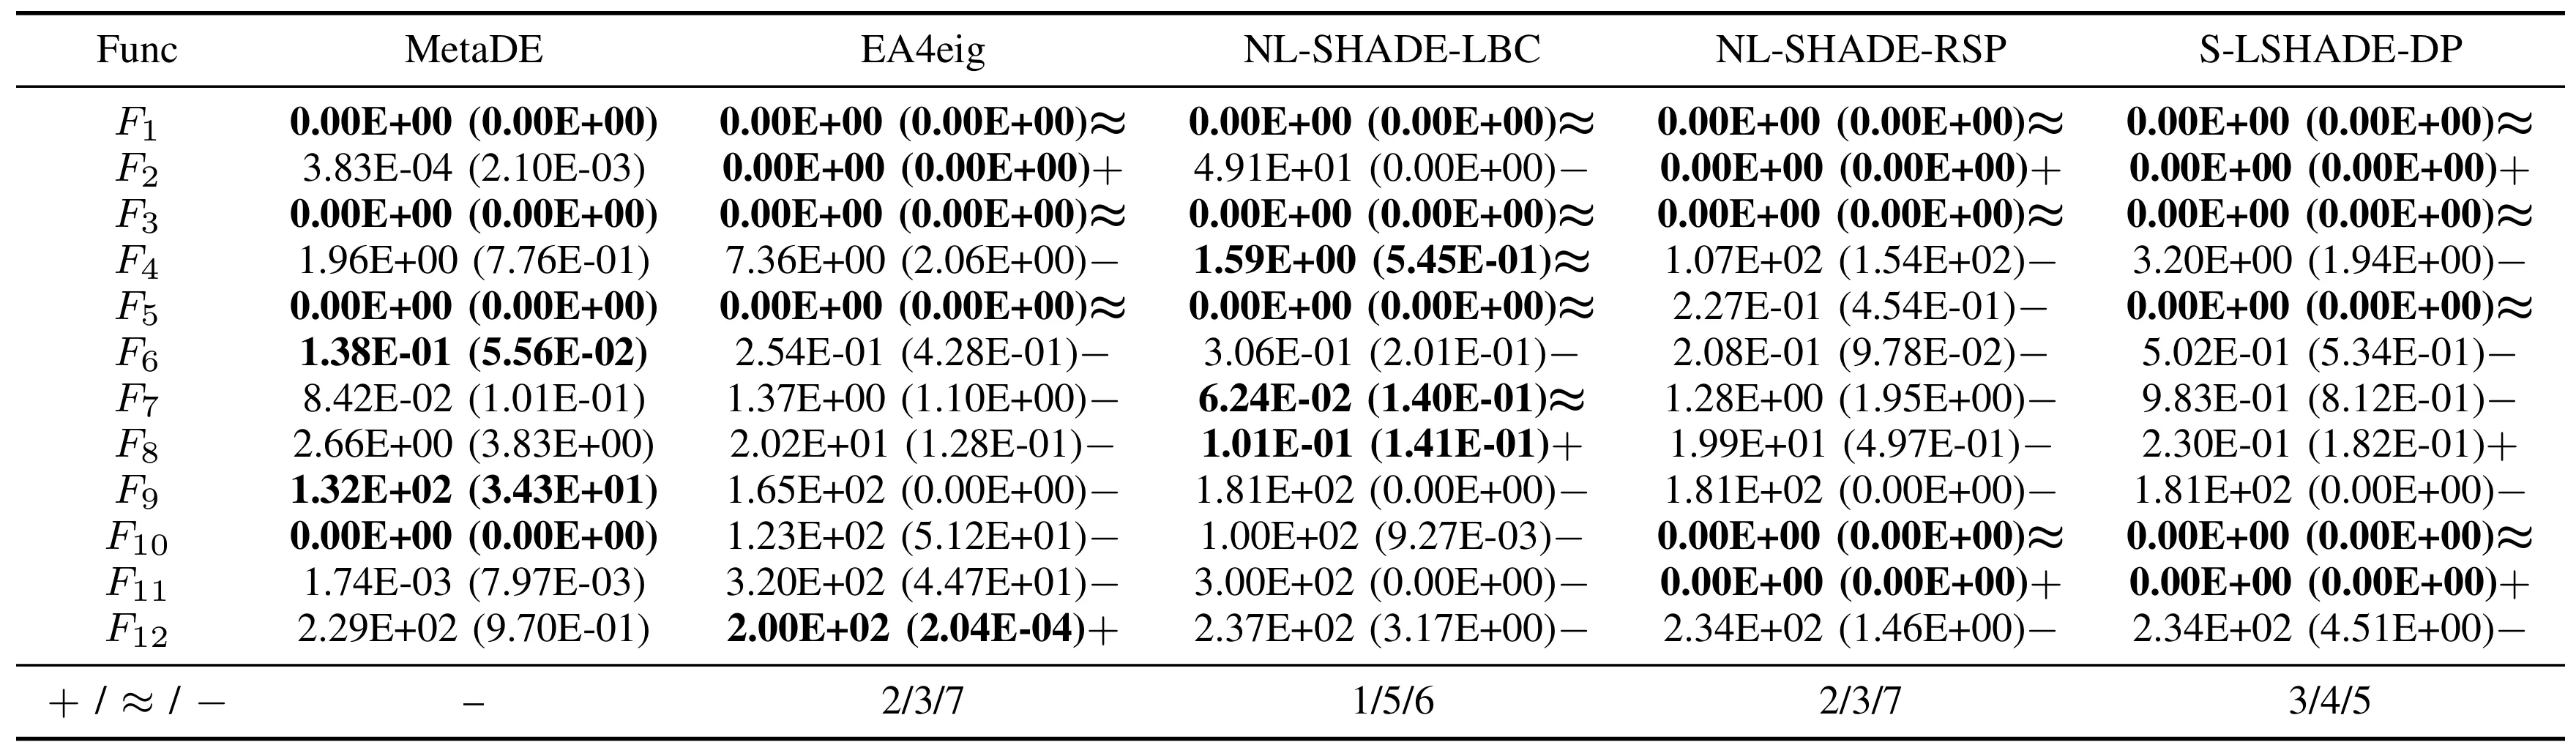
20D CEC2022 竞赛算法比较(相同 FEs)
MetaDE 始终表现出强大的性能,特别是在需要稳健收敛的复杂问题上。得益于其自适应机制,MetaDE 能针对不同的搜索景观有效地调整策略,从而提高搜索效率和全局优化能力。这些结果表明,MetaDE 不仅优于主流 DE 变体,而且在与顶级竞赛算法的竞争中也表现出强大的竞争力。
计算效率:固定时间(60 秒)内的 FEs
研究团队进一步记录了不同算法在相同的固定运行时间(60 秒)内完成的函数评估次数(FEs)。
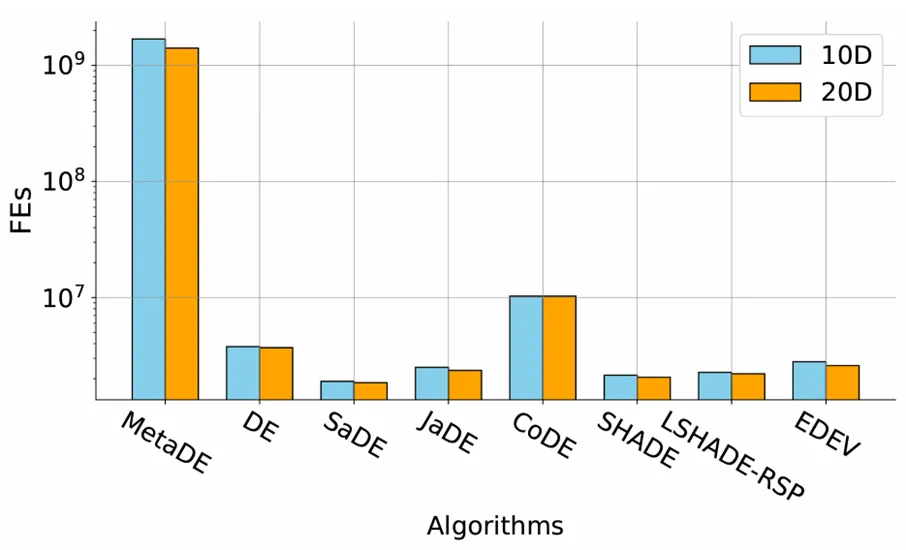
各算法在 60 秒内实现的 FEs
在相同的 EvoX 框架下,利用 GPU 加速并行计算,MetaDE 平均达到了 10⁹ 级别的 FEs,而传统 DE 变体仅达到约 10^6 FEs。这一优势源于 MetaDE 的参数化方法,该方法对个体进行大规模并行评估,从而实现了更高效的硬件资源利用。因此,该算法能在相同的时间窗口内探索更多的解,提高了解决方案的质量和稳定性。
演化强化学习:机器人控制任务
MetaDE 的机器人控制实验对神经网络策略参数进行无梯度搜索,这一路线不通过策略目标反向传播。演化强化学习是更广泛的方法家族,也包含梯度学习与混合方法,不能概括为普遍消除了 PPO 或 SAC 面临的学习困难。
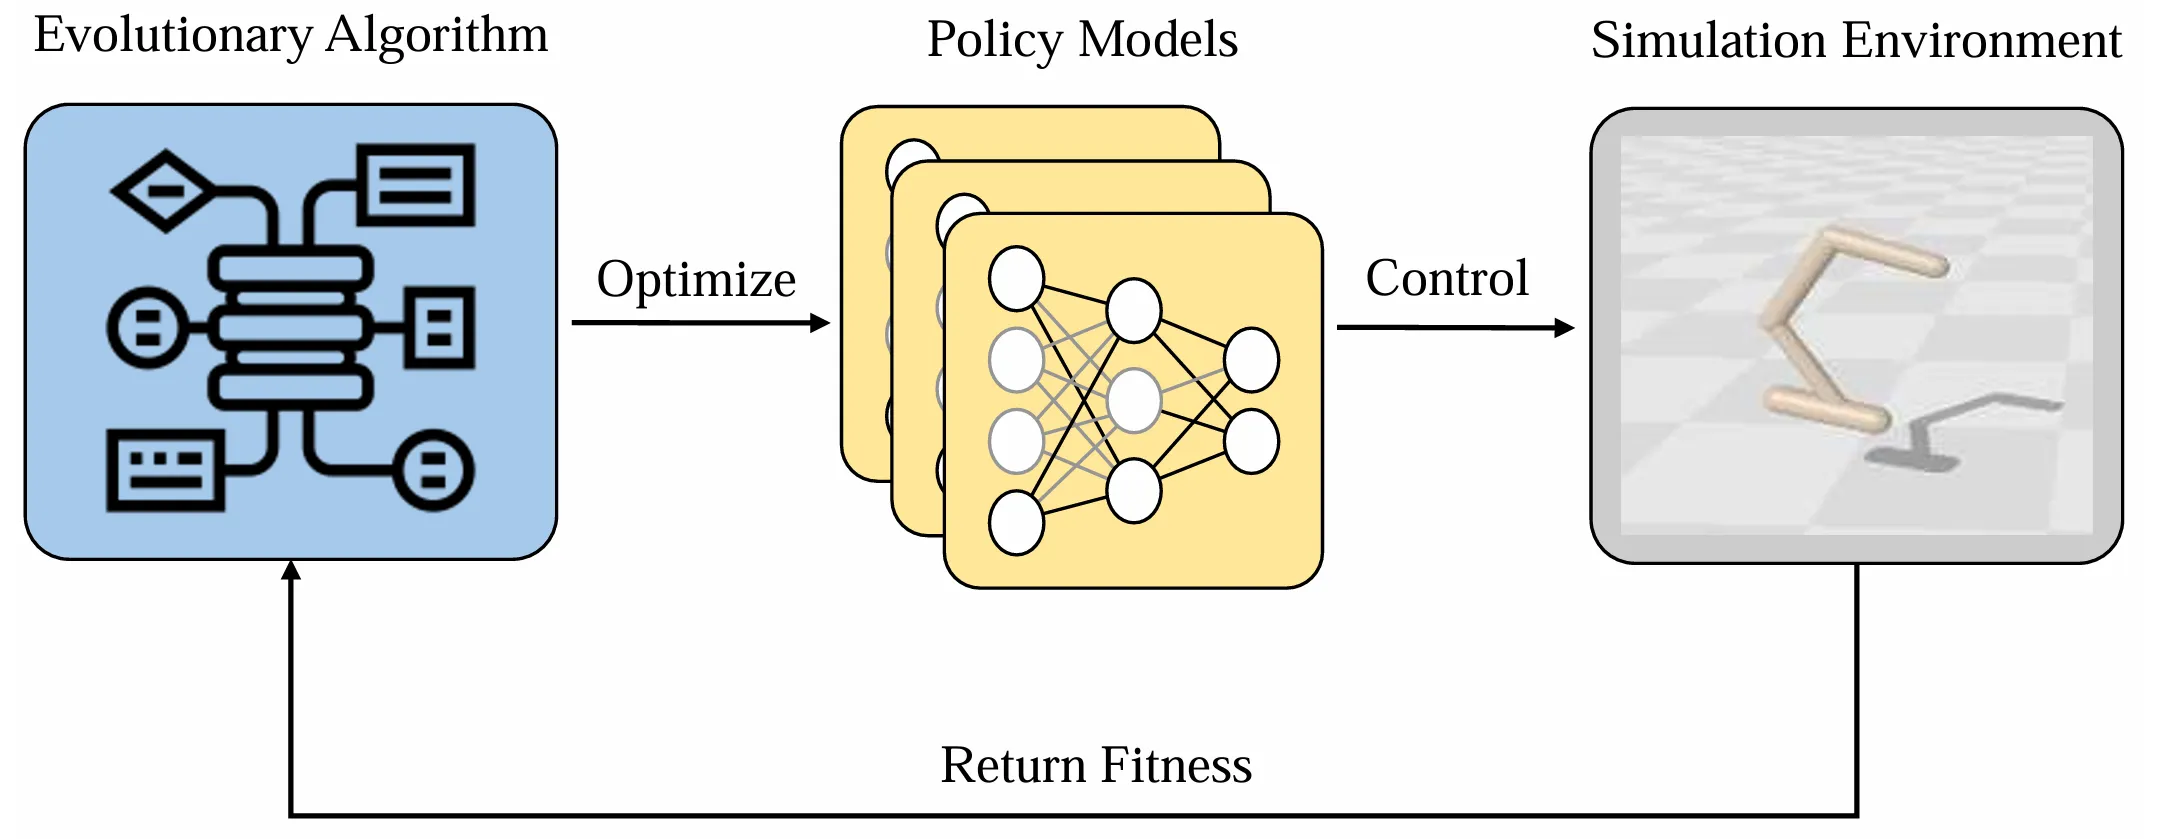
实验使用 Brax 的 Swimmer、Hopper 和 Reacher,以约 1,500 个参数的三层 MLP 表示策略。内层搜索优化策略权重,外层搜索调整 DE 执行器的参数与策略。这里验证的是仿真控制任务,不能据此宣称已完成真实机器人部署,或普遍改善了强化学习训练稳定性。
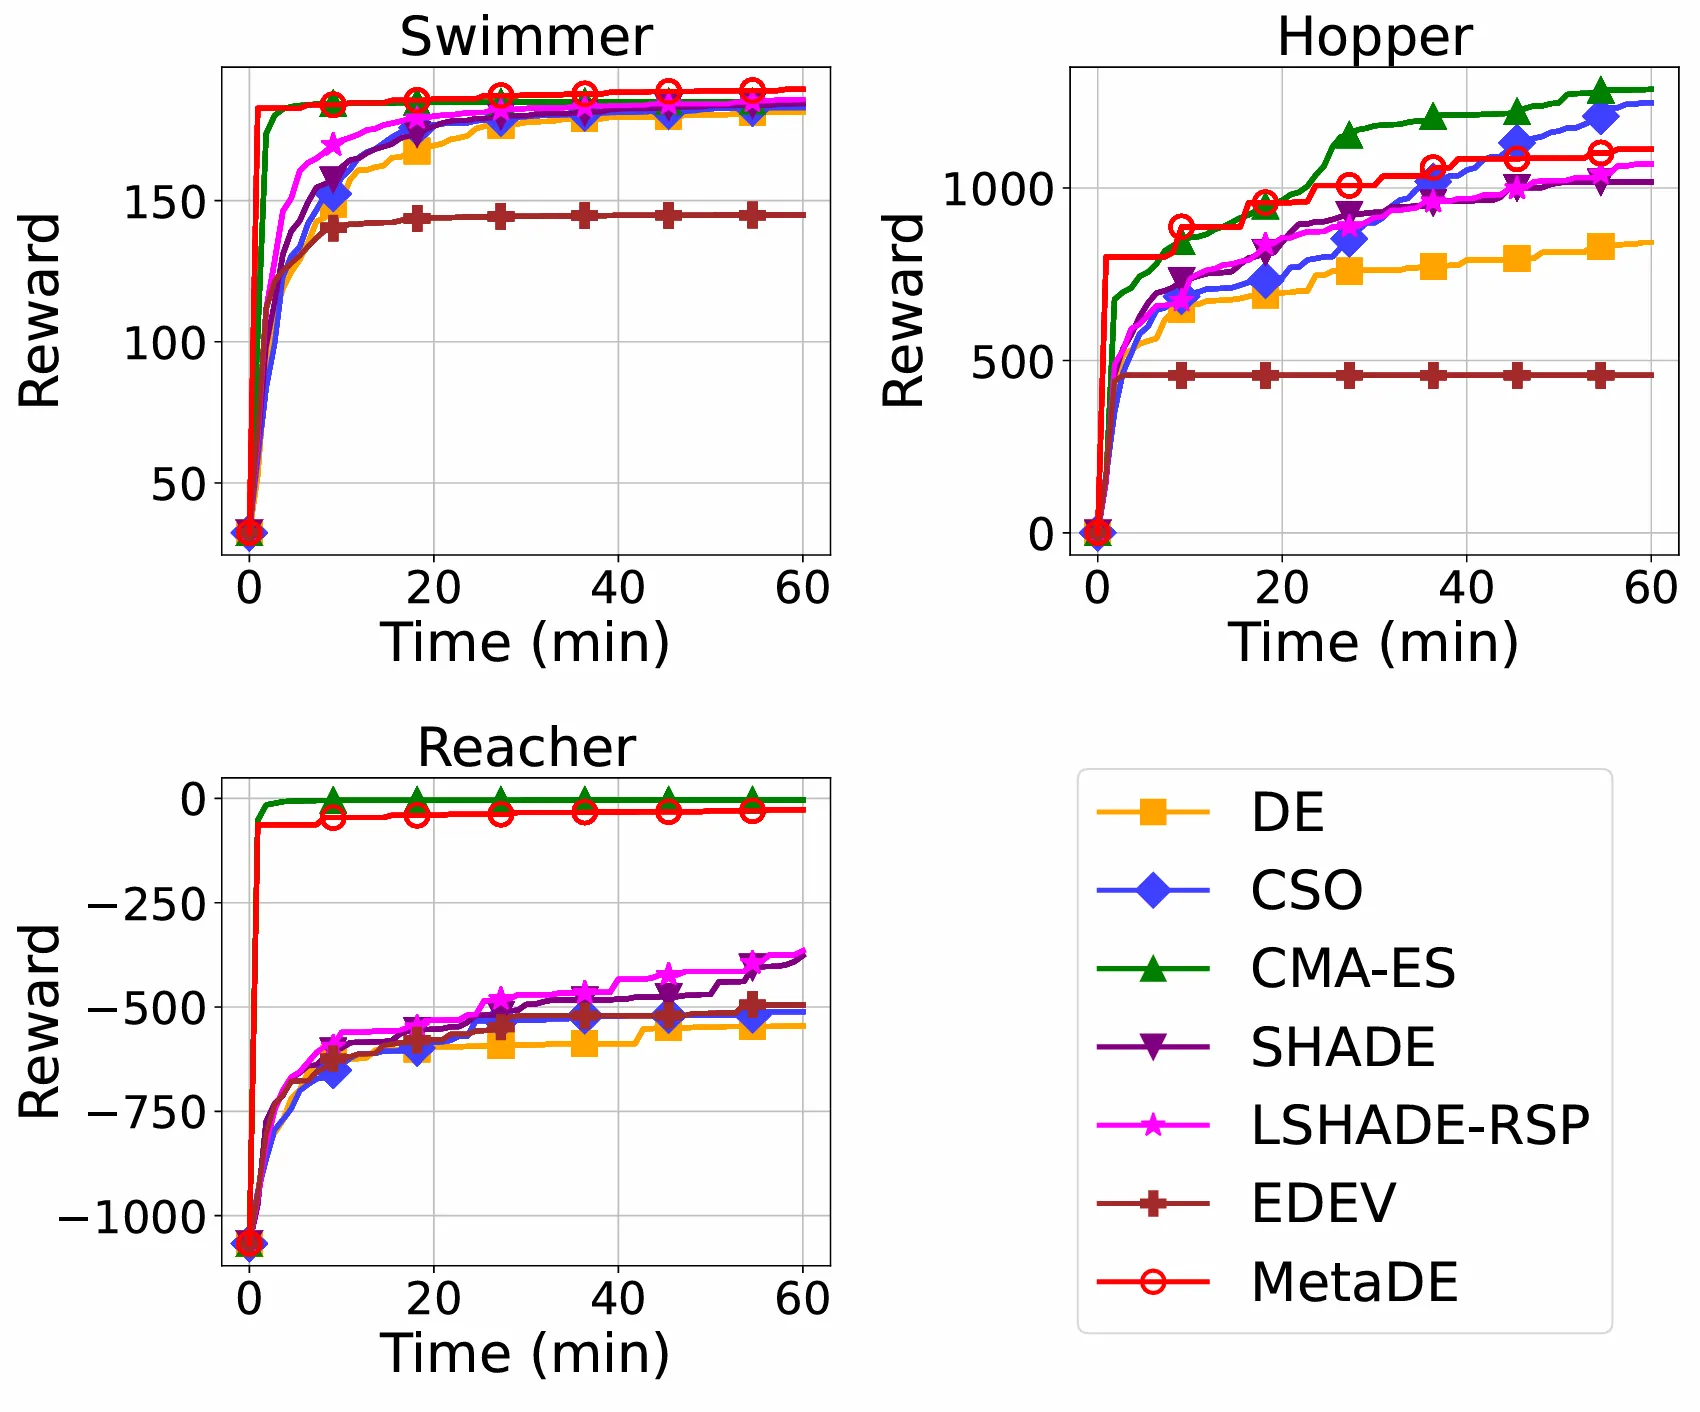
三个 Brax 环境的收敛曲线
如图所示,MetaDE 在基于 Brax 的机器人控制任务中表现出强大的性能,在 Swimmer 任务上取得了最佳结果,在 Hopper 和 Reacher 上取得了接近最优的结果。其主要优势在于初始种群的高质量,能够实现快速的早期收敛并产生高质量的解。这些发现表明,MetaDE 可以高效地优化神经网络策略,使其非常适合具有复杂物理仿真的机器人控制任务,并具有广泛的实际应用潜力。
结论与未来方向
同时核算两层搜索:记录外层配置尝试次数与内层目标评估次数。比较方法时,结合总预算与实际耗时。 iStratDE:以种群多样性组织并行搜索